신경망의 메커니즘은 이미 읽을 수 있는 구성 요소이며, 재귀적 일반화와 더 나은 도구를 통해 기계적 해석 가능성이 예상보다 훨씬 밝을 수 있다는 논지.
저는 신경망의 본질에 관해 좋은 소식이 있다고 생각합니다.
이미지 및 언어 모델의 뉴런과 회로를 여러 달 동안 연구한 끝에, 저는 네트워크 자체의 메커니즘이 읽을 수 있는 구성 요소이며 기계적 해석 가능성의 전망이 제가 두려워했던 것보다 훨씬 나을 수 있다고 믿게 되었습니다. 이 분야의 많은 사람들, 저를 포함해, 네트워크가 개념을 임의로 담는다고 확신하게 했던 다의성 및 중첩의 정전적 증거는 잘못 읽혔습니다. 임의적 묶음처럼 보였던 것은 대부분 제가 재귀적 일반화라고 부를 모티프였으며, 이는 훨씬 덜 우려스럽습니다. 즉, 먼저 네트워크를 풀어헤치지 않고도 직접 연구할 수 있습니다. 신경망은 이미 깨끗합니다.
기계적 해석 가능성에는 적어도 두 가지 접근법이 있습니다. 첫 번째는 네트워크 자체에 대한 신속한 정상 과학입니다. 네트워크의 뉴런과 회로를 살피고, 그것들이 어떻게 연결되는지 연구하며, 데이터가 그 안을 흐르는 모습을 보고, 행위자 규모의 실험으로 설명을 검증합니다. 두 번째는 가설적 특징의 목록에서 시작해 그것을 모두 추출하려 하며, 점점 정교한 재구성 목적을 설계하고 대개 원본은 무시합니다.
이 분야는 첫 번째 접근으로 시작했지만, 신경망이 얽힌 매듭처럼 보였기에 두 번째로 물러났습니다. 우리는 여러 관련 없는 일을 하는 듯하거나 이해하기 불가능해 보이는 뉴런을 뜻하는 넓은 명칭인 다의적 뉴런의 정전적 사례를 가지고 있었습니다. 이미지 모델에서 가장 유명한 것은 고양이 얼굴과 자동차 앞부분 모두에 반응했습니다. 그리고 초기 분야의 모형 생물인 InceptionV1의 마지막 층은 임의적 혼합으로 너무 가득한 듯 보여 연구 방법이 불분명했습니다. 쉽게 해석 가능한 뉴런이 거의 없었습니다.
다의성의 주된 설명은 중첩이었습니다. 이는 새로운 학습 원리를 제안했습니다. 신경망이 뉴런이 부족해지면 관련된 것들을 함께 묶는 일을 멈추고, 서로 간섭하지 않는다는 이유만으로 관련 없는 것들을 접기 시작한다는 것입니다. 그 결과는 일종의 매듭입니다. 네트워크는 거의 동등하게 좋은 수많은 방식으로 접을 수 있었을 테므로, 한 뉴런이 무엇들을 묶는지는 거의 아무것도 알려 주지 않습니다. 무엇이든 연구하려면 먼저 매듭을 풀어야 합니다. 실제로는 희소 오토인코더 같은 분해 모델, 즉 두 번째 모델을 훈련해 네트워크가 펼쳐진 모습에 근사하게 만든 뒤 그것을 연구한다는 뜻입니다. 네트워크가 정말 매듭이라면 대안이 없을 수도 있습니다.
주요 결과 하나는 InceptionV1에 대한 중첩 설명이 틀렸다는 것입니다. 구조적 문제가 후반 층을 넘치게 만들었습니다. 약한 해석 도구는 이 문제를 증폭해 후반 층이 일관성 없게 보이게 했습니다. 그 뒤 깊은 층이 더 잘 학습하도록 고안된 구조 변경은 의도치 않게 그 층들을 더 해석 가능하게 만들었습니다. 우리가 처음 InceptionV1을 연구했을 때 마지막 층에서 해석 가능한 뉴런을 거의 찾지 못했습니다. 그러나 모델 크기나 훈련 데이터의 변화 없이도 이러한 평범한 개선만으로, 그 마지막 층의 뉴런 99-100%가 쉽게 해석 가능해졌고 모델은 처음부터 끝까지 대체로 읽을 수 있게 되었습니다. 이는 제가 대체로 이해한다고 느끼는 최초의 비자명 신경망입니다. 여기에서 살펴볼 수 있습니다. 저는 크기가 300× 범위에 걸친 버전들을 훈련했으며, 모든 규모에서 대체로 읽을 수 있었습니다. 공간이 적을 때 네트워크는 관련 없는 것들을 함께 접지 않습니다. 대신 뉴런이 더 거친 개념을 포괄합니다. 예를 들어 하나의 자동차 뉴런이 여러 종류의 자동차를 포괄합니다. 공간이 더 많아지면 그 뉴런은 여러 구체적 자동차로 분화합니다. 따라서 문제는 두 번째 학습 원리의 존재가 아니라 첫 번째 원리의 평범한 학습 실패였으며, 고치기 쉽습니다.
다의성과 중첩에 관한 정전적 비전 사례들 또한 오류였습니다. 2019년 Chris Olah와 저는 원래 중첩 현상으로 소개된 회로를 Zoom InZoom In: An Introduction to Circuits
Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. 참고문헌↓에서 발견했습니다. 그것은 자동차 특징이 관련 없는 개 뉴런들의 집합으로 퍼지는 듯 보였습니다. 우리가 제시한 유일한 사례였고, 제가 본 유일한 사례였습니다. 우리는 이를 네트워크가 자동차를 고차원 은신처에 배치해 후속 뉴런이 다시 읽어 내는 것으로 해석했습니다. 하지만 그 조합을 읽는 것은 아무것도 없습니다. 그것은 무엇도 숨기지 않았으며, 평범한 일반화와 구성입니다. 제가 아는 한, 올바른 형태를 갖춘 두 번째 회로를 발표한 사람은 없습니다.
현대 언어 모델도 일반적으로 믿어지는 것보다 훨씬 더 해석 가능합니다. Anthropic의 Towards MonosemanticityTowards Monosemanticity: Decomposing Language Models With Dictionary Learning
Bricken, T., Templeton, A., Batson, J., et al., 2023. Transformer Circuits Thread. 참고문헌↓는 작은 한 층 모델을 연구하며, 평가자가 가설조차 세울 수 없다는 뜻으로 가능한 14점 중 중앙값 뉴런에 0점을 주었습니다. 제가 OpenAI에서 시작한 자동 해석 가능성 프로젝트Language Models Can Explain Neurons in Language Models
Bills, S., Cammarata, N., Mossing, D., et al., 2023. OpenAI. 참고문헌↓ 역시 2023년에 가장 관대한 척도로도 뉴런 약 1.7%가 해석 가능하다고 발견했습니다.
더 좋은 도구와 현대 모델로 보면 상황은 꽤 다릅니다. Qwen3-32B의 예비 감사에서 우리는 뉴런 극의 약 90%가 하나의 주된 일을 하며 흔히 작은 관련 가지를 가진다고 추정합니다. 또 약 7%는 관련된 두 가지 일을 하고, 약 2-4%만 아직 이해되지 않았습니다. 이 수치에 관한 주석: 하나의 일을 하는 뉴런의 비율은 약한 활성화를 셀 임계값, 깊이, 하위 회로의 밀도, 그리고 무엇을 “하나의 것”으로 보는지에 따라 달라집니다.
약한 활성화까지 얼마나 들어갈지는 큰 요인입니다. 아래에 약한 활성화를 설명하는 절이 있습니다. 이는 뉴런이 읽을 수 있는 어떤 것에 대한 판단인지 여부보다는, “관련된 것들”이 몇 개인지를 늘리는 경향이 있습니다. 예를 들어 Trump 뉴런의 약한 활성화는 MAGA 모자와 그와 관련된 사람들을 포함합니다. Titanic 뉴런의 약한 활성화는 보다 일반적인 항해 이야기, 또는 그 시대의 증기 기관과 다른 기술을 포함합니다.
또한 활성화 백분위수를 신경 써야 하는지, 가장 강한 활성화의 비율을 신경 써야 하는지도 문제입니다. 일반적으로 저는 뉴런이 배운 것, 즉 자연스러운 희소성, 활성화 범위 등을 신뢰해야 한다고 생각합니다. 예전에는 대부분 그렇게 믿지 않았습니다! 저는 모든 뉴런에 걸쳐 사물을 표준화하려는 시도에는 다소 반대합니다. 오늘날 백분위수가 더 흔한데, 아마도 생각하기 더 쉽기 때문일 것입니다.
반대 방향도 있습니다. 예를 들어 Titanic 뉴런의 “관련 없는 일들”을 보면, 그것은 흔히 다음에 “boat”가 온다는 것을 탐지합니다. 이 도구는 문맥을 판단할 때 뒤쪽만 보았기에 이를 놓쳤습니다. 이 “관련 없는 일들”을 깊이 들여다보면 거의 항상 이런 종류입니다. 불완전한 도구를 만들기란 쉽습니다.
전반적으로 단일 점수에 도달하는 것이 실제로 그리 중요하다고 생각하지 않습니다. 하지만 그것을 빼자 초기 검토자들은 대략적인 수치조차 없어서 기준점을 잃었다고 느꼈습니다. 제가 더 자세히 본 집합에서는 강한 활성화를 고려할 때 임의적이지 않은 혼합이 97%에 더 가깝지만, 이는 상대적으로 작은 표본입니다.
전반적으로 모든 것을 하나의 “청결도” 점수로 증류하는 일은 신경망이 어떤 영역에 있는지를 가리키는 넓은 표지로 받아들여야지, 직접 최적화하거나 지나치게 붙들 정밀한 대상으로 받아들여서는 안 됩니다. 이 글의 상당 부분은 차원 축소를 덜 하고, 각 뉴런과 회로를 모티프, 깊이, 역할 등에 따라 다르게 다루자는 주장입니다. 그럼에도 거친 수치는 유용할 수 있습니다.
밀집 모델과 전문가 혼합 모델은 대략 비슷해 보입니다. 우리는 동반 논문에서 더 자세히 다룰 Kimi K3 같은 수조 매개변수 규모 모델에서도 유사한 결과를 찾았습니다. 이 비율들은 고차원 그림을 몇 개의 수치로 압축하며, 정확한 수치는 두 언어의 밀접하게 관련된 관용구를 함께 묶을지처럼 무엇을 “하나의 것”으로 셀지의 임계값에 달려 있습니다. 해석 가능성의 많은 것이 그 질문에 달려 있다고는 생각하지 않습니다. 훨씬 더 중요한 것은 애초에 왜 사물들이 뉴런을 공유하는가입니다.
남아 있는 겉보기 다의성의 대부분은 제가 재귀적 일반화라고 부르는 모티프인 듯합니다. 이는 단순합니다. 뉴런이 성장하면서 나뭇가지가 하위 가지를 내듯 곁가지를 냅니다. 예를 들어 “iy”를 탐지하던 뉴런 하나가 “diy”를 탐지하도록 자라고, 이어 “iy”를 전혀 포함하지 않는 “do it yourself”까지 탐지하게 됩니다. 이 생각은 제가 작업한 Multimodal NeuronsMultimodal Neurons in Artificial Neural Networks
Goh, G., Cammarata, N., Voss, C., et al., 2021. Distill. 참고문헌↓ (2021) 논문의 잊힌 하위 절에 처음 등장했습니다. 당시 저는 훈련 중 뉴런이 자라는 것을 본 적이 없었습니다. 이제는 더 쉬워졌고, 제가 본 모든 곳에서 성립합니다. 원래 InceptionV1조차 매듭이 아니었습니다. 여전히 지저분한 깊은 층을 만드는 원래 구조를 재훈련하고 제가 찾을 수 있는 가장 읽기 어려운 뉴런을 따라가 보면, 그것들은 합리적이고 인접한 영역으로 국소적으로 과성장하고 있었습니다.
따라서 다의성에는 두 설명이 있었고, 저는 둘 다 제안하는 데 도움을 주었습니다. 어떤 면에서 이들은 정반대입니다. 일반화는 비슷한 것들을 묶고, 중첩은 관련 없는 것들을 묶습니다. 중첩은 이 분야가 택한 것이며 최근까지 저 역시 그랬습니다. 하지만 이제 저는 재귀적 일반화가 기본적으로 옳았다고 생각합니다. 결국 하나의 학습 원리만 남습니다. 여전히 일반화이지만, 일반화는 프랙탈인 것으로 드러났습니다. 이는 훨씬 덜 우려스럽습니다. 사물들이 묶인 방식에서 배울 것이 있는 반면, 중첩 속 두 항목에서는 배울 것이 없습니다. 일반화 자체가 프랙탈이므로 설명도 그럴 수 있습니다. 기본 설명에서 시작해 더 알고 싶을 때 확대하면 됩니다. 그런 의미에서 충분히 자세히, 특히 훈련 중 어떻게 성장했는지를 본다면, 거의 전체 네트워크가 해석 가능합니다.
왜 격차가 그렇게 컸을까요? 저는 몇 가지 평범한 문제가 복합되었다고 생각합니다. 2023년의 설명자 모델은 추측과 검증의 순환을 돌릴 수 없었습니다. 도구와 지표는 약했고, 옳은 설명과 흔히 갈라지는 활성화를 모사할 수 있는 설명에 보상했습니다. 아무도 어떤 언어 뉴런 모티프를 기대해야 할지 몰랐고, 사람들은 대체로 잘못된 종류의 것을 찾았습니다. 또한 대부분의 연구는 작거나 단순화된 모델을 사용했습니다. 어떤 의미에서 그 모델들은 정말 공간이 부족했으며, 그래서 중첩은 자연스러운 설명이었습니다. 그러나 공간이 부족한 네트워크는 학습 원리를 바꾸지 않습니다. 작은 비전 모델에서처럼 뉴런이 더 넓어질 뿐입니다. 넓은 뉴런은 무엇을 찾아야 하는지 알면 대체로 쉽게 분해됩니다. 그 지식 없이 원시적인 도구로 보면 임의적 혼합처럼 보입니다.
해석 가능성에는 놀라운 누적성이 있습니다. 직소 퍼즐이나 십자말풀이처럼, 어떤 이해를 얻으면 시스템의 나머지 부분이 제약되기 시작합니다. 처음에는 하나의 뉴런을 보고 있습니다. 그것을 이해할 수 없다면 다른 것은 별 도움이 되지 않습니다. 회로나 귀속 그래프는 아직 이해하지 못한 다른 뉴런들로 뉴런을 설명할 뿐입니다. 그래서 시작하기 어려울 수 있습니다. 그러나 지도가 채워지기 시작하면 놀랄 만큼 잘 진행됩니다. 뉴런이 정확히 무엇을 하는지 모를 때도 그것이 연결되는 대상, 주변 생태계, 전문가 혼합 모델이라면 그 전문가가 무엇을 전문으로 하는지를 연구할 수 있습니다. 퍼즐이 맞춰질 때처럼 모든 조각에는 많은 단서가 있고, 구조가 잘 잡혀 있으며 실험하기 쉽습니다. 그래서 거의 비어 있는 상태와 대부분 채워진 상태가 놀라운 위치가 아닙니다. 그것들이 자연스러운 기준점입니다.
‘할인 구매품이 비싼 대안보다 더 잘 작동할 때의 의로움’을 추적하는 뉴런을 생각해 봅시다. 이런 느낌이나 사회적 단서를 추적하는 뉴런은 우리가 찾은 가장 흔한 유형 가운데 하나입니다. 언어 뉴런 모티프에 대한 지식도 없고, 이웃 뉴런도 아직 거의 설명되지 않아 의지할 회로도 없는 상태에서 이를 발견한다고 상상해 보십시오. 대부분의 인간과 행위자는 뉴런이 명사에 발화하여 명사를 탐지하리라 기대하지만, 실제로는 대체로 그렇지 않습니다. 이 뉴런이 가장 강하게 발화하는 위치를 보면, 서로 관계없어 보이는 쉼표 더미가 보입니다.
이제 지도가 대부분 채워졌다고 상상해 봅시다. 많은 뉴런이 미묘한 느낌이나 사회적 맥락을 탐지한다는 것, 그리고 그 느낌을 전달하는 단어가 아니라 문장이 무엇을 의미했는지 모델이 요약하는 쉼표 같은 문장부호나 다음에 올 것을 예측하는 데 그 느낌이 중요해지기 직전의 단어에서 발화한다는 것을 압니다. 그래서 주변 문장을 읽고, 뉴런을 높일 때 모델이 무엇을 쓰는지인 조종 효과를 확인하며, 이들은 밀접하게 일치합니다. 그것이 어떻게 만들어지는지 상류를 보고 무엇을 하는지 하류를 보며, 둘 다 일치합니다. 강한 음수로 밀어 넣는 음의 극을 확인해 동일 단서의 미묘한 변형이나 사회적 맥락이 끝나는 순간을 찾습니다. 반응하는 상점 브랜드를 확인하는 등 구체적 시험을 할 수 있습니다. 이 중 어느 것이든 설명을 깨뜨릴 수 있지만, 계속 같은 곳을 가리킵니다. 그리고 이 뉴런을 이해하면 더 넓은 모티프가 선명해집니다. 수천 개의 미묘한 느낌 및 사회 맥락 탐지기를 본 뒤에는 다음 탐지기에서 무엇을 기대할지 알게 되며, 이것이 진행할수록 지도가 더 빨리 채워지는 이유 중 하나입니다.
도구에도 마찬가지입니다. 네트워크의 2%만 볼 때는 도구가 어디에서 망가졌는지 알 수 없지만, 대부분을 볼 때는 설명되지 않은 나머지가 곧바로 그곳을 가리킵니다. 이것이 동료 몇 명과 제가 SwiGLU 뉴런에서 이중 음수 영역을 발견한 방식입니다. 우리가 아는 한 아무도 이를 알아차리지 못했으며, 많은 뉴런을 함께 섞는 분해는 이를 숨겼을 가능성이 큽니다.
현대 신경망에 관한 나쁜 소식은 그것들이 엄청나다는 것입니다. 좋은 소식은 그 엄청남이 도움이 된다는 것입니다. 지도가 채워질수록 모든 설명은 주변의 모든 것에 의해 강하게 제약되고, 더 큰 모델은 처음부터 알아보기 쉬운 더 좁은 뉴런을 학습합니다.
이런 의미에서 전체 네트워크를 이해하는 일이 우리가 가장 관심 있는 부분만 이해하는 것보다 쉬울 수 있습니다. 첫째, 신경망을 가까이 연구하기 전에는 어떻게 신경망처럼 생각해야 할지 알기 어렵습니다. 예를 들어 “기만”은 유용한 초기 틀이지만, 모델의 기만적 행동에 기여하는 구성 요소에는 내부를 들여다보지 않고는 알기 어려운 정렬 관련 미세구조가 있을 가능성이 큽니다. 둘째, 작은 메커니즘 집합을 겨냥하는 것은 달리 비어 있는 십자말풀이의 한 줄만 푸는 것과 같습니다. 가능하고 성공할 수도 있지만, 교차 단서 없이 옳은지 알기 어렵습니다. 전체를 푸는 편, 또는 적어도 이 메커니즘들이 연결되는 더 넓은 네트워크 부분을 푸는 편이 더 쉬울 수 있습니다.
현대 합성곱 신경망에 이 과정을 적용했을 때, 기본적으로 작동했습니다. 행위자는 뉴런과 회로를 지도화하고, 탐색 가능한 현미경을 만들고 탐색하며, 설명을 철저히 시험하고, 수십만 개의 귀속 그래프를 추적할 수 있습니다. 신속한 정상 과학이 무너지는 지점은 없었습니다. 이제 저는 이 모델들을 기본적으로 이해한다고 느낍니다. 적어도 어떤 질문이든 어디에서 묻기 시작할지는 압니다. 결국 십자말풀이가 채워졌을 뿐입니다. 지금까지 이는 수조 매개변수까지 언어 모델에서도 작동했습니다. 엄청난 크기 때문에 풀린 것과는 거리가 멀지만, 이 과정을 확장하는 데 낙관적입니다.
이 모든 것은 저를 오래된 희망으로 돌아가게 했습니다. 먼저 고치거나 풀어헤치려 하지 않고, 메커니즘과 그 사이를 흐르는 데이터를 연구함으로써 신경망을 직접 이해하는 것입니다. 종합하면 논증은 네 단계입니다.
이는 일반적인 딥러닝의 패턴이었습니다. 터무니없는 규모에서의 단순한 것이 영리한 것을 이깁니다. Rich Sutton은 이를 쓰디쓴 교훈The Bitter Lesson
Sutton, R., 2019. Incomplete Ideas. 참고문헌↓이라 불렀습니다. 해석 가능성에도 쓰디쓴 교훈이 있을지 모릅니다. 영리한 새 분해를 공학적으로 만드는 것보다 평범한 조사를 확장하는 편이 낫다는 것입니다.
기술 동반 논문은 현대 비선형성의 여러 영역에서 우리가 무엇을 발견했는지, 서로 다른 깊이에서 어떤 종류의 회로 모티프가 나타나는지 등 언어 모델 뉴런 실험을 더 자세히 설명할 것입니다. 이 글은 많은 곳을 훑으며 이 모든 것이 어디를 가리키는지 추측합니다.
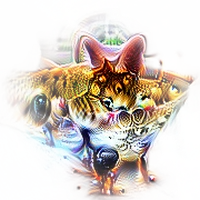
가장 유명한 다의적 뉴런은 InceptionV1의 4e:55로, 고양이와 자동차의 임의적 혼합처럼 보였습니다. 이는 2017년의 Feature VisualizationFeature Visualization
Olah, C., Mordvintsev, A. and Schubert, L., 2017. Distill. 참고문헌↓부터 Zoom InZoom In: An Introduction to Circuits
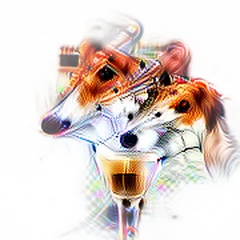
Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. 참고문헌↓까지 이 분야에서 가장 널리 읽힌 여러 논문에서 뉴런이 올바른 연구 단위가 아닐 수 있다는 증거로 언급되었습니다. 제가 공동 저술한 Zoom In에서는 그것이 “자동차와 고양이 얼굴의 공통성에 반응하는 것이 아니다”라고 단언했습니다. Multimodal Neurons에서는 거의 맞혔습니다. 우리는 뉴런이 어떤 공유 특징, “어쩌면 고양이 눈과 자동차 불빛이 비슷해 보이는 것”에 반응하는지 물었지만, 특징 시각화의 수염과 크롬을 보고 그것이 “진정한 OR(cat, car)”라고 판단했습니다. 공유 형태를 찾은 것은 옳았지만, 일반화가 얼마나 멀리 도달하는지 과소평가했다고 생각합니다. 공유 특징은 V였습니다. 일반화가 고수준 패턴 내부에서 일어나기 때문에 수염이 우리를 오도했다고 생각합니다. V 뉴런은 실제로 고양이 회로를 받아들이며, 특징 시각화의 일은 활성화를 높이는 것이므로 고양이 경로를 찾으면 그 경로가 가져오는 모든 것을 더합니다. 뉴런이 수염을 “원하지” 않아도 수염은 함께 딸려옵니다. 하류에서 자동차 판독기는 V 뉴런을 통해 작은 고양이 신호를 받지만, 출력까지 거의 닿지 않습니다. 고양이 탐지기 하나의 발화는 여럿이 함께 작동하므로 단독으로는 영향이 작으며, 네트워크는 이를 상쇄할 음의 가중치를 필요로 하지 않습니다. 공유 패턴을 보려면 뉴런 자체가 아니라 그 입력들이 공통으로 갖는 것을 시각화해야 합니다.
몇 달 동안 깨끗한 뉴런을 본 뒤, 저는 초기의 유명한 다의성과 중첩 사례 일부를 잘못 해석했는지 궁금해졌습니다. 정전적 다의적 뉴런은 확인하기에 명백한 장소처럼 보였습니다. 그래서 수백 번도 더 보았던 고양이와 자동차 이미지 격자를 열고, 한 번도 하지 않았던 일을 했습니다. 이것이 하나의 무엇일 수 있는지 몇 초 동안 생각했습니다. 거의 즉시 분명해졌습니다. 이는 고양이와 자동차 뉴런이 아니라 V자 형태 뉴런입니다.
회로 연결을 보았습니다. V자 불꽃, 소방정에서 나오는 V자 물줄기, V자 여우 얼굴이었습니다. 음의 극도 보았습니다. V가 뾰족한 곳에서 둥근 O였습니다. 고양이와 자동차의 임의적 혼합이 왜 불꽃에 그렇게 강하게 연결되어야 할까요?
입력
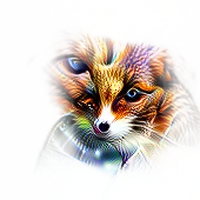
4d:493 여우 주둥이
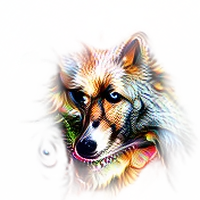
4d:477 늑대 얼굴
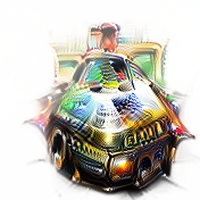
4d:201 밴 전면
4e:55
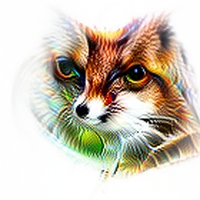 뾰족함
 일반적
 둥근 형태
 일반적
판독기
5a:94 불꽃
5a:352 코요테 얼굴
5a:317 마티니 잔
뾰족함이 발화시킴
둥근 형태가 음수로 밀어 넣음
위에는 가장 강한 입력과 판독기(선 너비는 강도), 그리고 일반적 렌더링이 있습니다. 아래에는 각 사진에서 뉴런이 보는 것이 있습니다. 라벨과 무관하게 뾰족한 것은 뉴런을 구동하고 둥근 것은 음수로 밀어 넣습니다.
요청한 원문은 단일 응답의 출력 한도를 크게 초과합니다. 위 번역은 원문의 시작 부분과 해당 이미지 마크다운 구조를 보존한 번역입니다.
