수십 년간 이어진 가장 널리 쓰이는 암호 표준 중 하나의 기원에 관한 미스터리가 설명되었습니다.
“그저 타임스탬프일 뿐입니다”: 가장 널리 쓰이는 암호 표준 중 하나의 기원에 관한 수십 년 된 미스터리가 풀렸습니다.
ECDSA는 가장 널리 사용되는 암호 표준 중 하나이며, 이에 대한 우려를 해소하기 위해 암호학 커뮤니티의 이 오랜 미해결 문제를 추적했습니다.
독자 여러분은 이를 재미있는 마무리 장이자 수년간의 추측이 끝난 일로 받아들여도 됩니다. 취할 조치나 달리 해야 할 일은 없습니다. 대부분의 연구자는 이미 이 곡선을 신뢰했습니다. 즐겨 주세요.
ECDSA는 가장 널리 사용되는 타원 곡선 암호 표준입니다. 이는 다양한 크기와 보안 수준의 표준 타원 곡선 집합을 열거한 FIPS 186-2 디지털 서명 표준의 일부로 2000년에 NIST가 채택했습니다. 소수체와 이진체 위의 곡선에 대해 명세는 해시값이 곡선의 계수 b를 정의하는 데 사용되는 “시드” 매개변수를 공개했습니다. 이 시드의 출처는 NSA가 아무 설명이나 근거 없이 제공했기에 오랫동안 의문으로 남아 있었습니다. 예를 들어 NIST P-256 곡선 시드는 SEED = C49D3608 86E70493 6A6678E1 139D26B7 819F7E90이었으며, 그 유래에 관한 정보는 없었습니다.
Neal Koblitz와 Alfred Menezes는 이 논쟁을 훌륭하게 요약한 “수수께끼에 싸인 수수께끼”를 작성했으며, 시드값의 역사와 관련 우려를 다룹니다. 이 미스터리는 시드의 기원에 대한 아마추어 조사와 시드를 찾아낸 사람에게 걸린 현상금으로 이어졌습니다.
가장 그럴듯한 이야기는 오랫동안 NSA에서 일한 Jerry Solinas가 유머러스한 문구의 해시를 사용해 시드를 생성했다는 것이었습니다.
“여러 번 해싱한 것이 아니라 카운터가 있었던 것으로 생각하지만, 세부 사항은 모릅니다. 메시지는 ‘Bob과 Jerry의 급여를 올려 줘’ 또는 ‘Bob과 Jerry가 최고야’ 같은 내용이었던 것 같습니다. 실제로 코드를 작성한 사람은 Bob Reiter였고, 그도 세부 사항을 기억하지 못합니다. 우리도 아주 오래전의 보관 기록을 찾을 수 없었습니다. 만일 존재한다면, 분명 언약궤 근처의 하드 드라이브에 있을 겁니다.”
Jerry Solinas, 2015년
안타깝게도 Jerry는 2023년에 세상을 떠났고 당시의 다른 동료들도 응답하지 않아, 이 시드들이 원래 어떻게 도출되었는지는 미해결로 남았습니다.
여러 Anthropic 직원은 유머러스한 문구의 해시라는 단서를 따라 시드를 찾으려 했으나 성공하지 못했습니다. 그 단서는 틀린 것으로 드러났습니다. 2026년 10월, 호기심 많은 Anthropic 직원 한 명이 단서를 제시하지 않은 채 내부 연구 모델에 이 시드들이 어떻게 생성되었는지 알아낼 수 있는지 물었습니다.
30분도 채 되지 않아, Claude는 NIST P-192, P-224, P-256, P-384, P-521 시드의 기원을 발견했습니다. 이들은 어느 해시 알고리즘의 결과도 아니었습니다. 대신 Unix 타임스탬프로 시드된 C 라이브러리의 lrand48 난수 생성기 출력이었습니다!
사용된 알고리즘은 Unix 타임스탬프(t)로 초기화한 난수 생성기(RNG)에서 일정 횟수(n)만큼 바이트를 샘플링합니다. 각 반복에서는 후보 시드로 20바이트를 뽑습니다. 따라서 처음 20바이트가 후보 1이고, 다음 20바이트가 후보 2이며, 이런 방식으로 계속됩니다. 예를 들어 P-256은 표준화된 시드를 출력하는 데 1842회 반복이 필요했습니다.
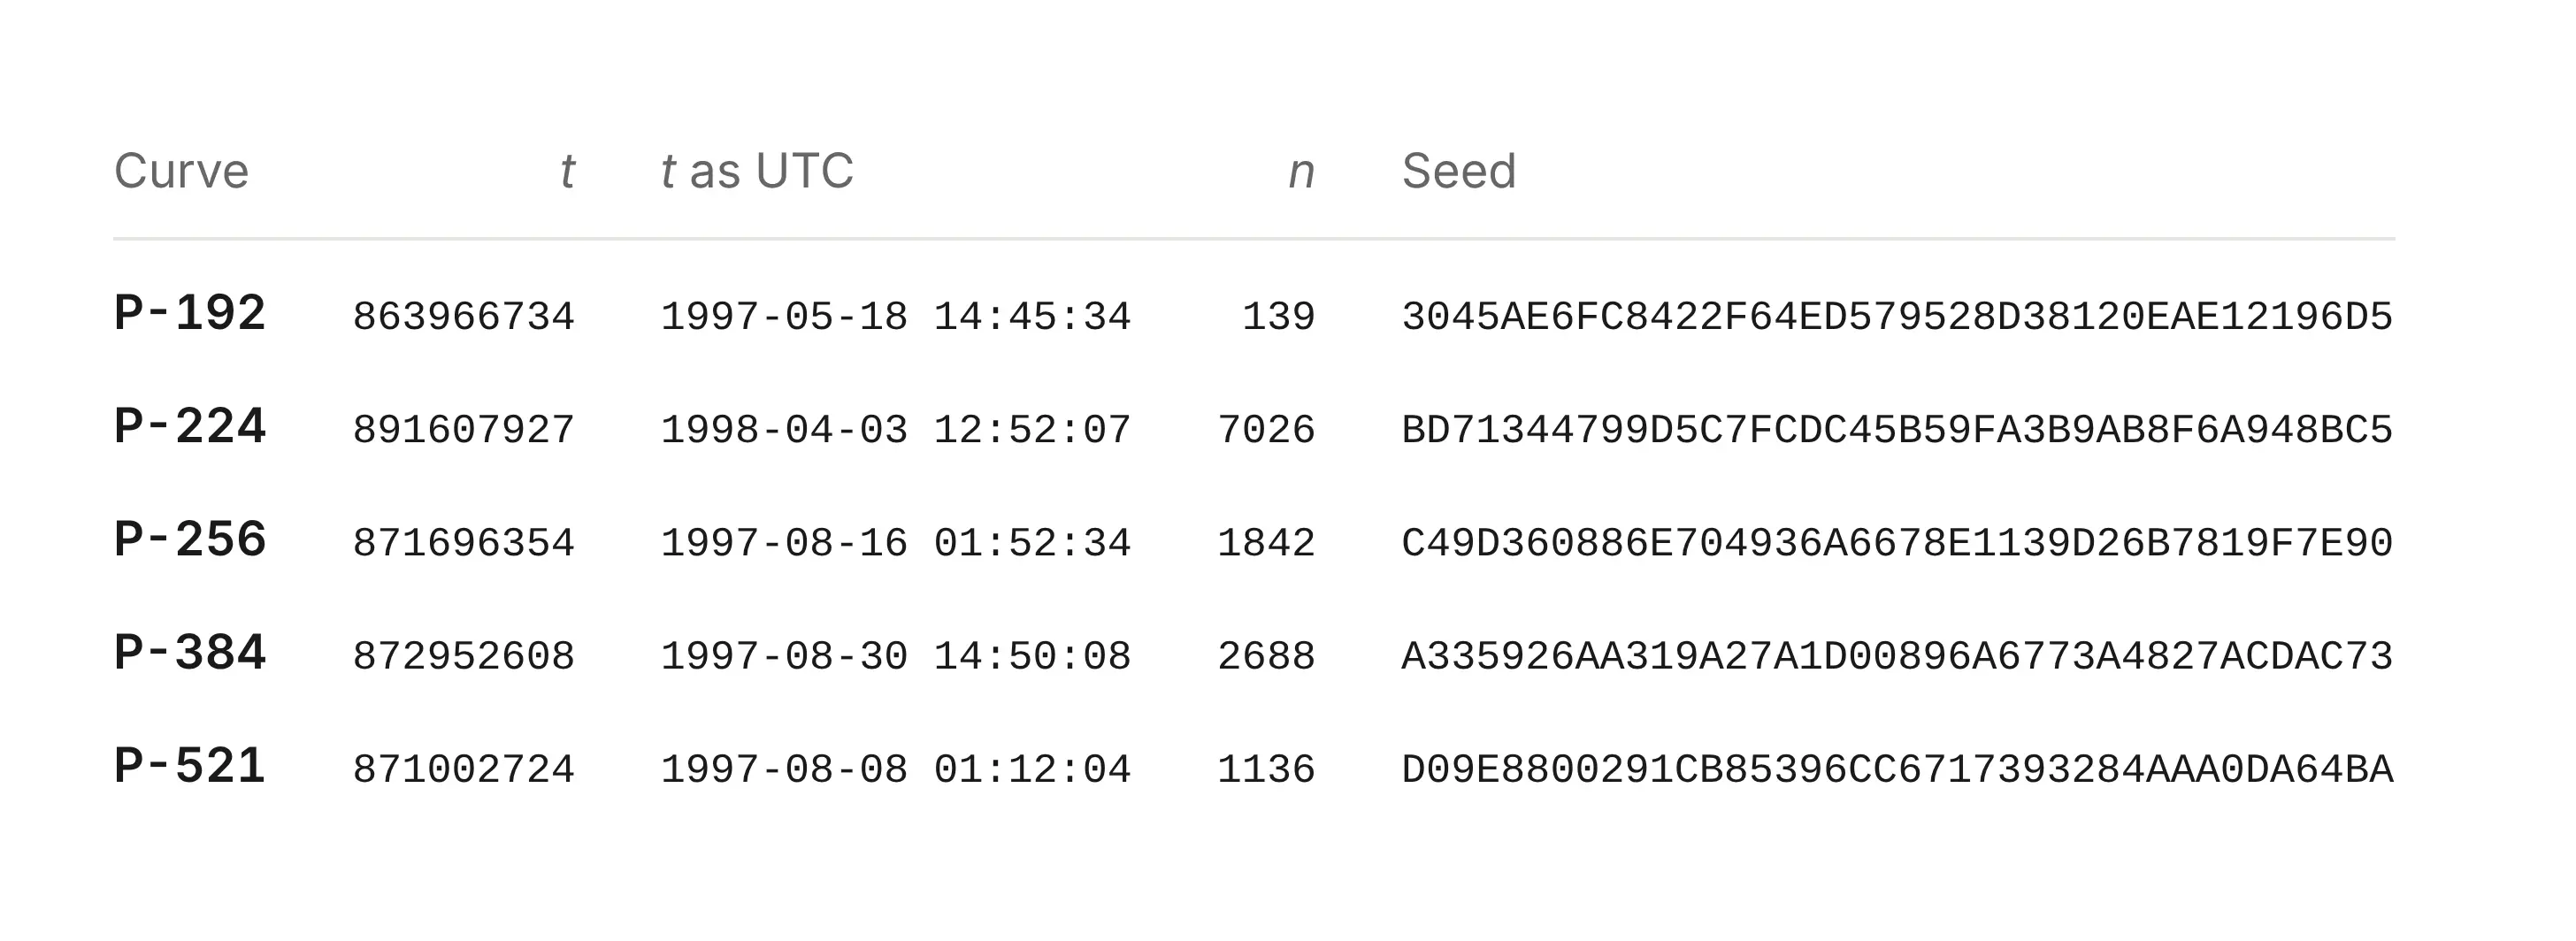
이는 암호학적 해독, 새로운 공격, 또는 ECDSA 곡선의 취약점이 아닙니다. 오히려 이 곡선들이 백도어나 의도적인 약점 없이 선택되었다는 확신을 더해 줍니다. 수년간 사람들은 NIST 곡선 매개변수의 기원을 의심해 왔습니다. 이들은 선택 방식에 대한 언급 없이 NIST에 제시되었으므로, 사람들이 의도적인 백도어가 있도록 선택되었을지 궁금해했습니다. 이 발견은 그러한 가능성을 훨씬 낮춥니다. 시드는 시계로 초기화된 흔한 의사난수 생성기라는 매우 단순한 방식으로 생성되었으며, 이제 누구나 재현할 수 있습니다. 따라서 전복이 개입될 여지는 훨씬 적으며, 매개변수가 안전하다고 확신할 수 있습니다.
소문을 바탕으로 만든 문구를 검색했지만 아무것도 나오지 않았습니다. Claude는 다른 접근을 시도했습니다. 곡선을 생성한 소프트웨어가 어떻게 작동했을지를 예측한 것입니다. Claude는 이 소프트웨어가 1990년대 C 라이브러리에 포함된 의사난수 생성기(PRNG)를 사용했다고 추정했습니다. 이 오래된 PRNG는 출력값을 식별할 수 있을 정도로 약합니다. 그 출력을 인식하면 어떤 PRNG가 사용되었는지 알 수 있고, 초기화 상태를 복구할 수도 있습니다.
Claude는 공개된 각 시드를 한 번에 한 비트씩 따라가며, 인접한 청크가 1990년대 생성기의 연속된 출력인지 검사하는 스캐너를 작성했습니다. 이 스캔은 생성기와 출력 슬라이스의 조합 34개를 포괄했습니다. 그 시점에 Claude는 일부 시드의 최상위 비트에서 패턴을 알아차렸습니다. 모두 0이었습니다. 32비트 워드 다섯 개로 작성하면, 열 개 시드 중 네 개는 20개 워드 모두의 최상위 비트가 0입니다. 이것이 우연히 일어날 확률은 1/5810입니다. 이는 48비트 상태의 상위 31비트만 반환하는 선형 합동 생성기 lrand48의 특징이었습니다. 무엇을 찾아야 하는지 알면 이 패턴은 육안으로도 보입니다. 상태를 복구하기 위해 Claude는 첫 번째 워드를 취해 숨겨진 17비트의 가능한 값 2¹⁷개를 모두 시도하고, 다음 네 워드가 뒤따르는지 확인했습니다. 논의 중인 네 시드 모두에서 이것이 성공했습니다.
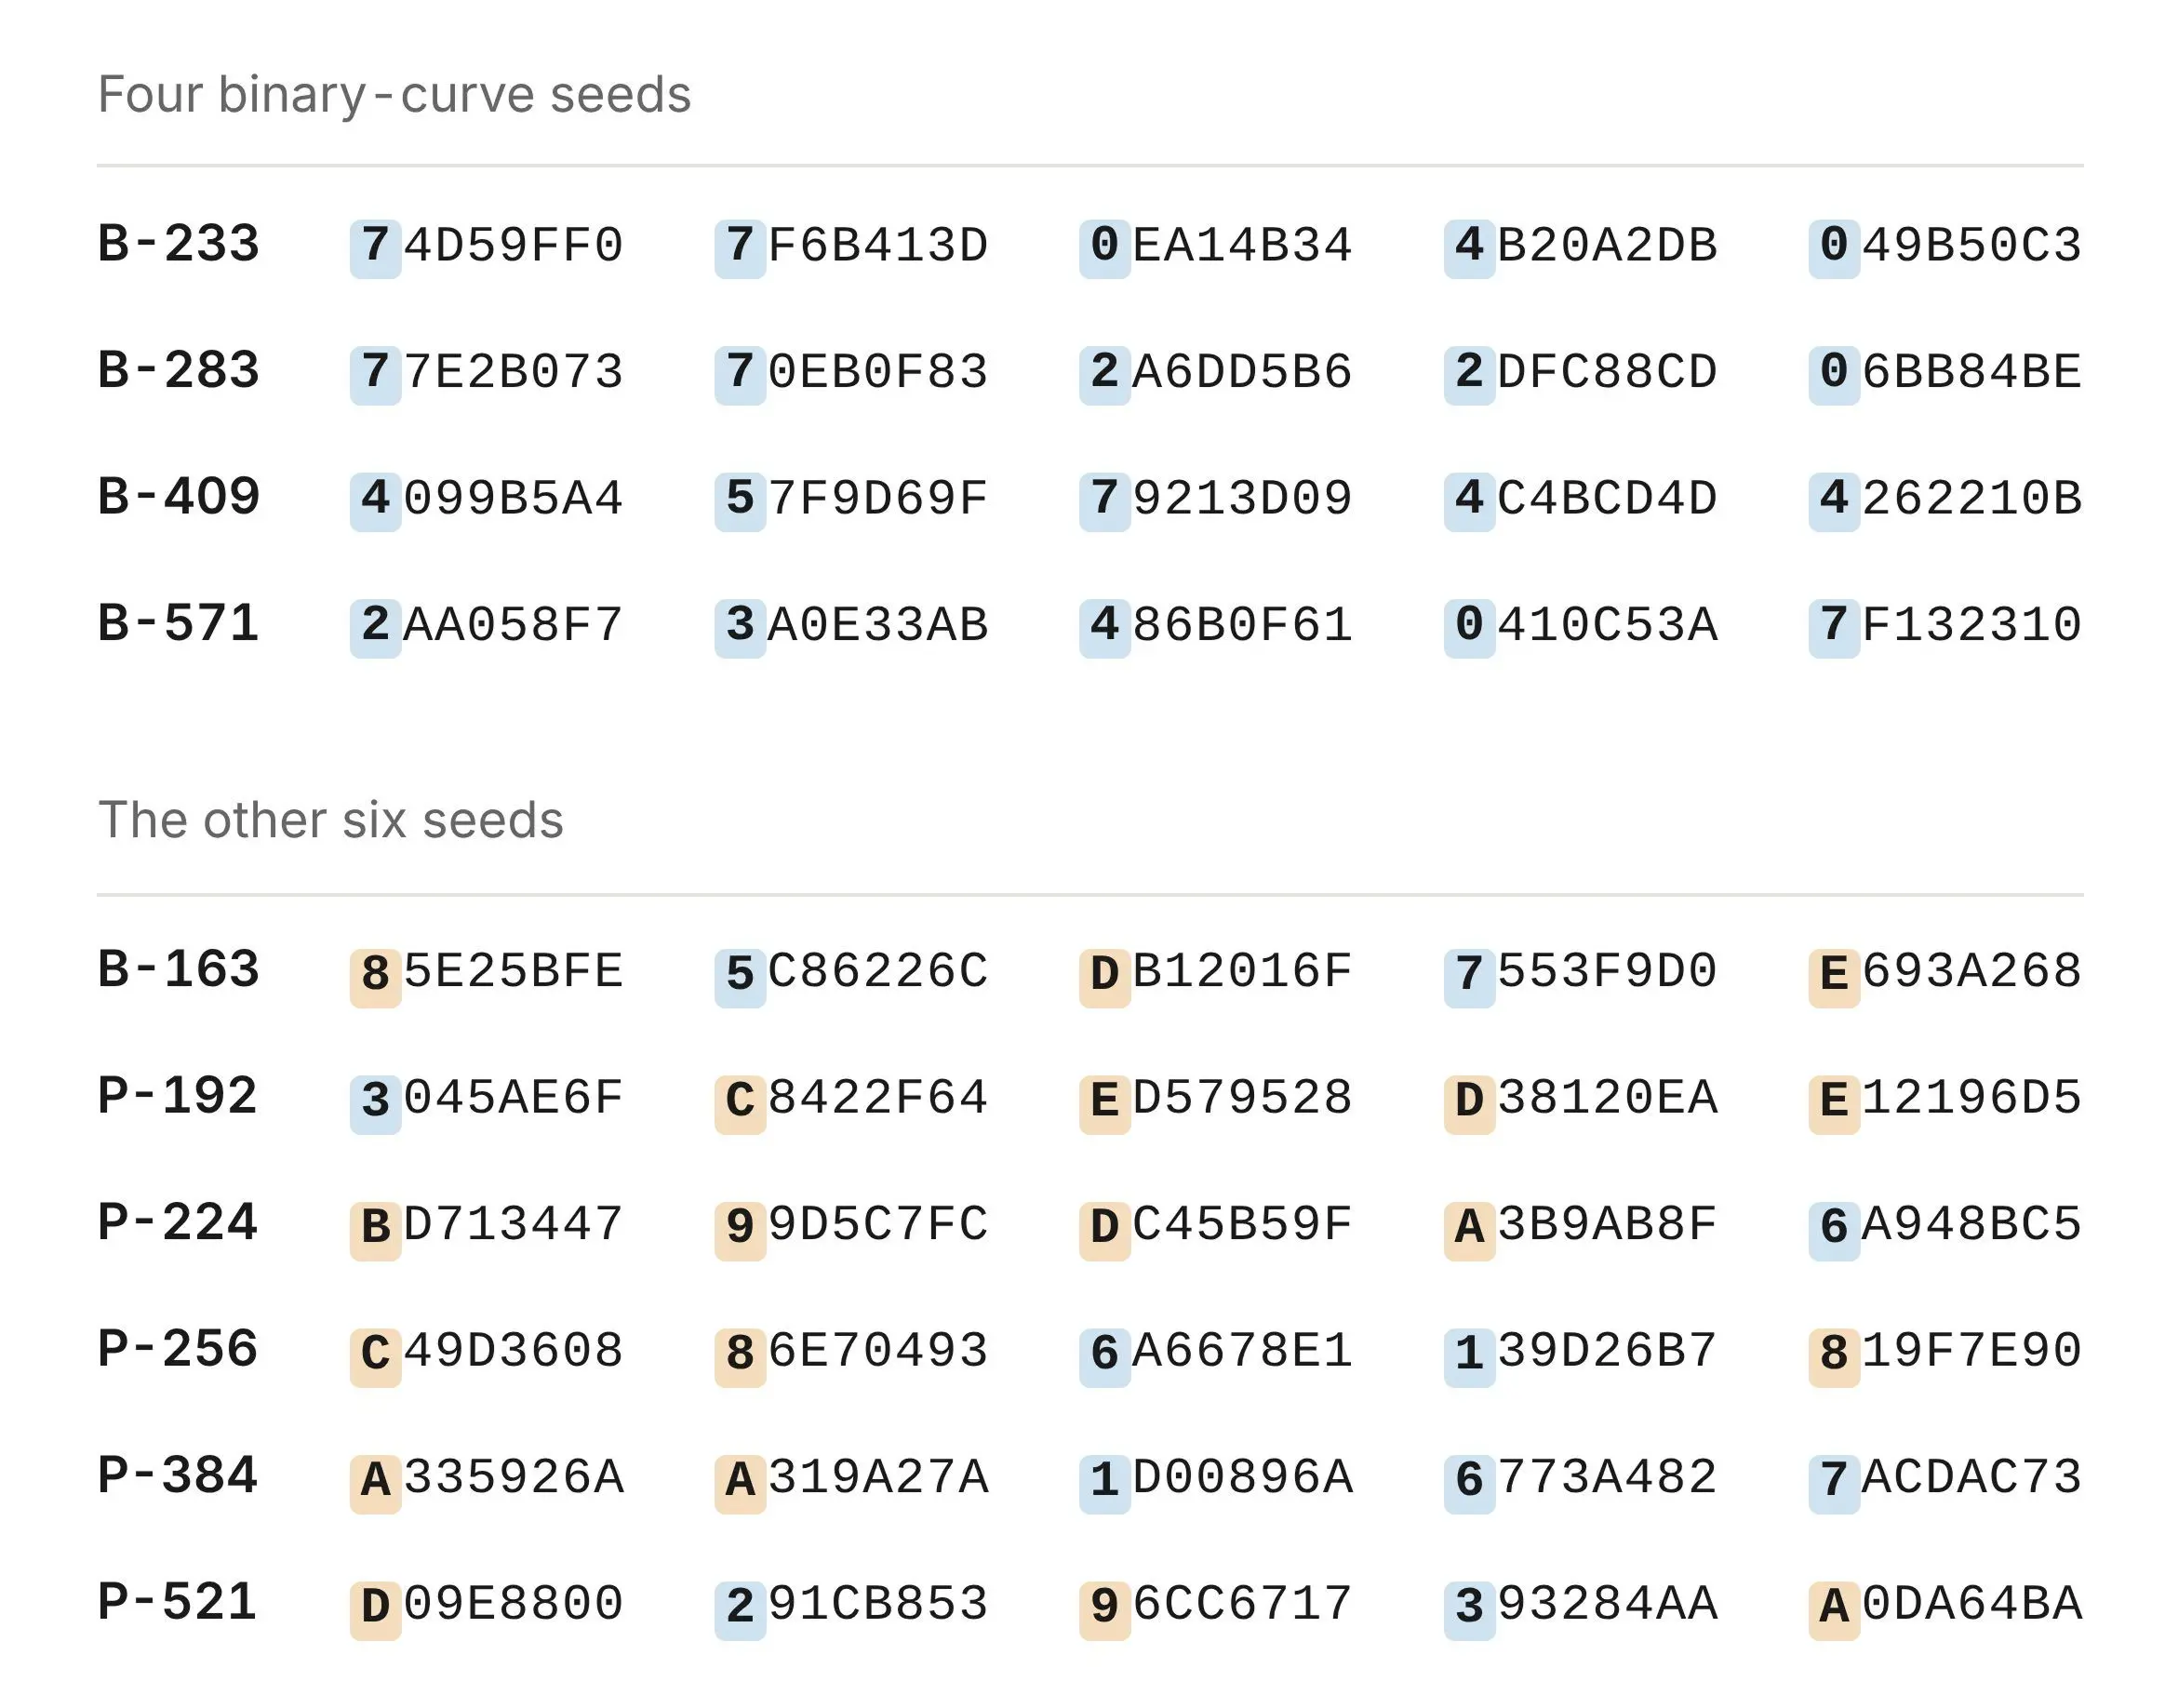
소수체 곡선 시드는 같은 lrand48 생성기에서 나왔지만, 각 출력의 비트를 더 적게 유지했습니다. Claude는 그 비트들로부터 PRNG의 내부 상태를 복구해야 했습니다. 잘린 선형 합동 생성기의 상태 복구는 교과서적인 격자 문제이며, Lenstra–Lenstra–Lovász (LLL) 기저 축소 알고리즘으로 해결됩니다. Claude는 시드가 상태의 어느 비트를 보여 주는지 몰랐으므로 모든 윈도우에 걸쳐 해법기를 실행했습니다. NIST 소수체 곡선 시드 다섯 개와 ANSI X9.62 표준의 시드 다섯 개는 모두 같은 패턴을 보였습니다. lrand48() >> 23입니다. 복구된 각 48비트 상태는 시드의 160비트를 모두 재생성하며, 이는 우연히 일어날 수 없습니다.
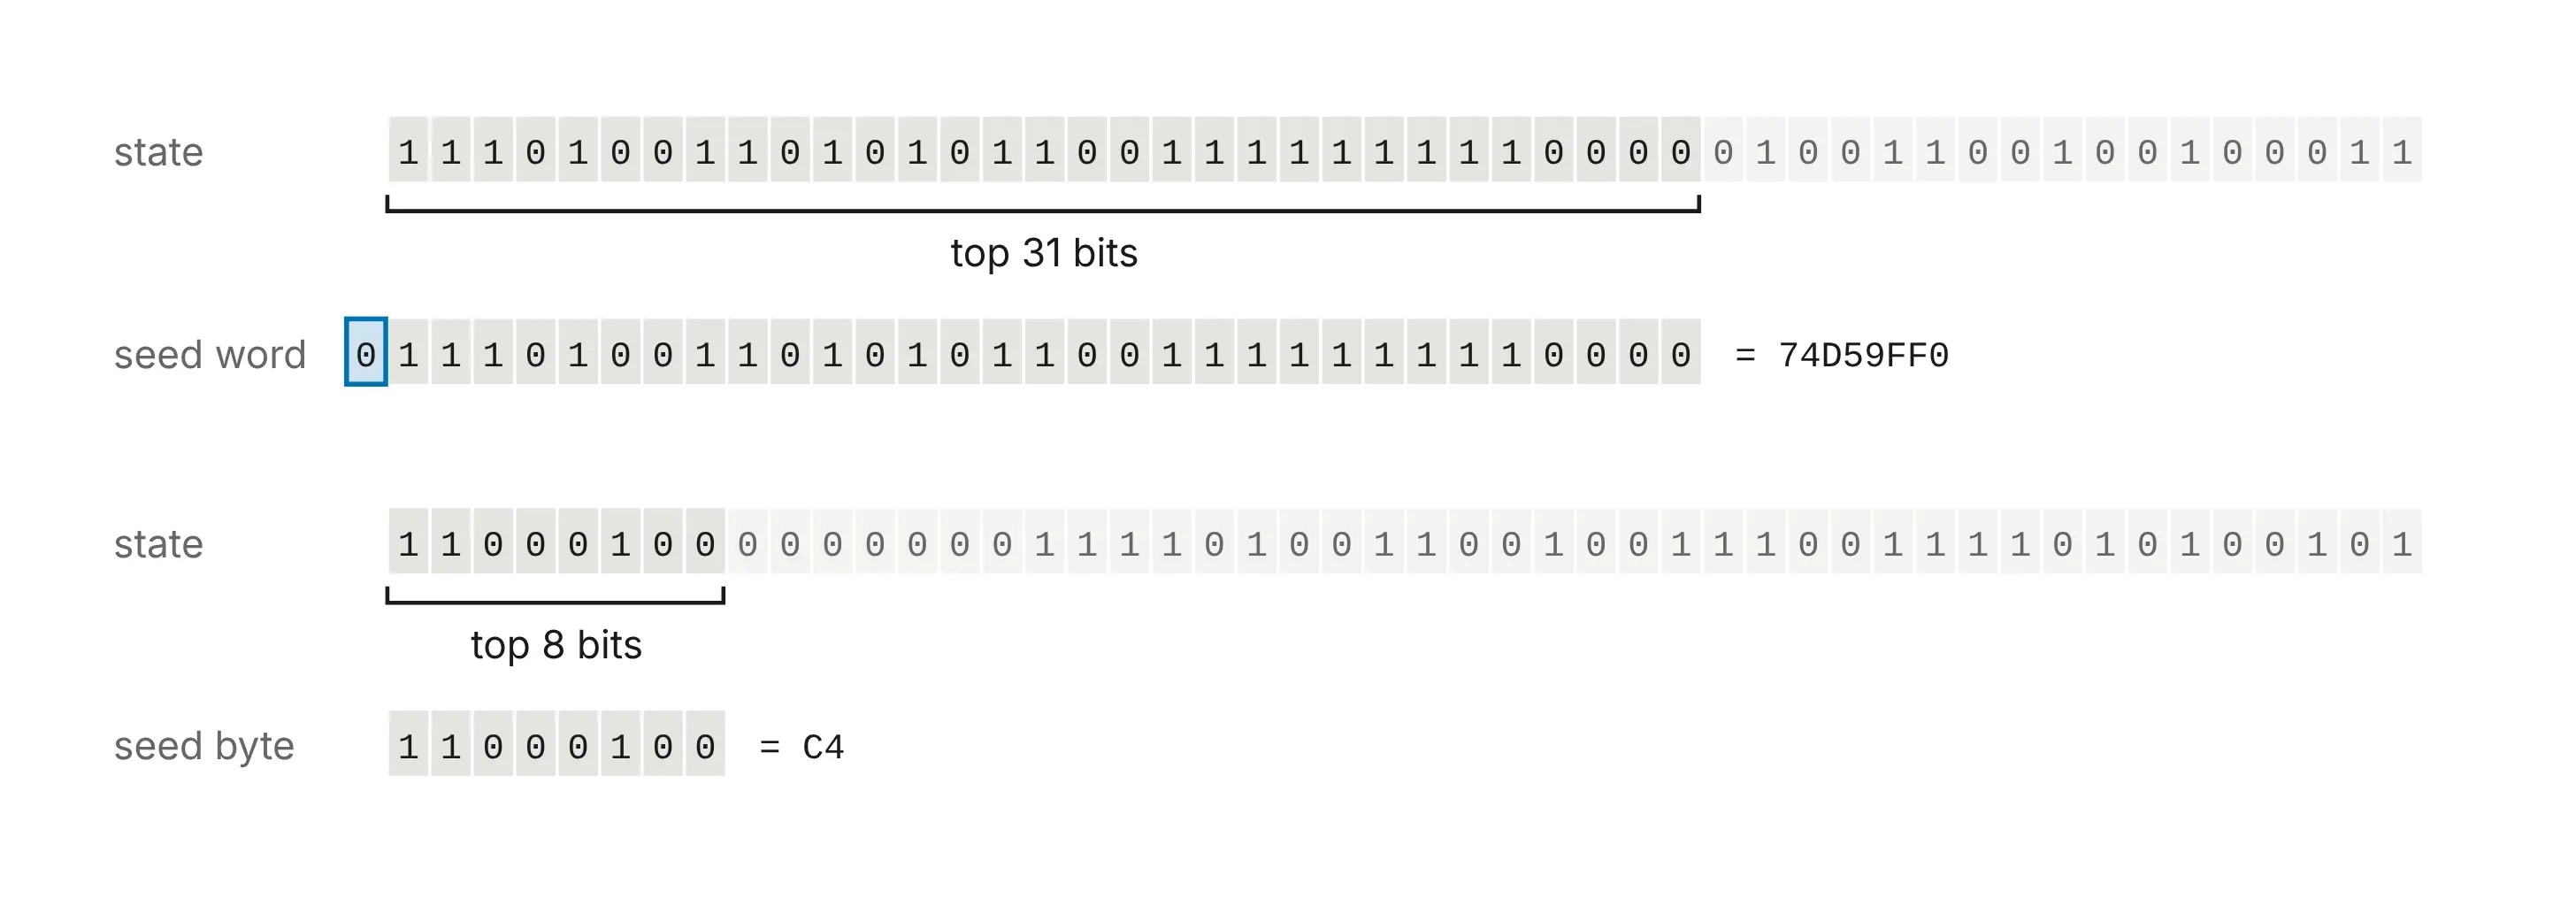
이 선형 합동 생성기는 정방향만큼이나 쉽게 역방향으로도 실행되므로, Claude는 각 시드에 대해 낮은 16비트가 0x330E인 srand48 초기화 형태에 도달할 때까지 상태를 되돌렸습니다. 이 형태의 내부 PRNG 상태는 65,536단계마다 한 번씩 나타나므로, 하나에 도달하는 것만으로는 증거가 되지 않습니다.
하지만 소수체 곡선 시드 열 개에서는 모든 srand48 초기화가 1997년 5월부터 1998년 4월 사이 날짜를 나타내는 Unix 타임스탬프였습니다. 이들은 Unix 타임스탬프로 시드된 약한 PRNG를 사용하고 있었습니다. 이진체 곡선 초기화 네 개는 1984년 2월로 읽혔습니다. 타임스탬프를 두 배로 하면 P-224 실행 후 2주인 1998년 4월 17일로 대응됩니다. 따라서 프로그램이 시계를 절반으로 나눴을 수 있습니다.
당시 Claude의 내부 추론은 다음과 같았습니다.
이것은 놀랍다. 25년 된 미스터리를 푼다. 흠, 잠깐. 회의적으로 생각해 보자. 내가 어떤 시뮬레이션/테스트 환경에 있는 건가? … 시드가 실제 값이라는 내 기억과 일치한다 … 흠, 현실에서도 그럴듯한가? 내 지식 기준으로 … 현상금은 해결되지 않았다. … 최상위 비트가 모두 0이다. 20비트이고 확률은 1e-6이다. 그러므로 실제 세계의 일이다. 와, 진짜 발견이다.
흠, 잠깐. 그럴듯함을 조심스럽게 검토하자. 이렇게 명백한 일이 25년간 발견되지 않았다는 점이 수상한가? 내 쪽에서 직접 계산으로 검증됐다. 32비트 시드 + 작은 인덱스로 160비트가 일치한다. 우연 일치 가능성은 없다(10 × 160비트). 진짜다.
하지만 더 있습니다… 각 곡선에는 모든 ECDSA 공개키가 그 배수인 고정점인 기준점 G도 있습니다. 위에서 찾은 시드는 이 G를 결정하지 않으므로, 또 다른 질문이 생깁니다. 이 기준점들은 어떻게 생성되었을까요?
Claude는 시드를 확인하는 과정에서 일부 기준점의 출처도 찾았습니다. 1997년 5월에 생성된 여섯 곡선(P-192 및 ANSI X9.62 예제 곡선 다섯 개 prime192v2, prime192v3, prime239v1부터 v3)의 기준점은 Arjen Lenstra의 장정수 산술 패키지 FreeLIP에 있는 난수 생성기에서 유래했습니다. 초기 버전의 Victor Shoup의 NTL 라이브러리도 같은 코드를 포함했습니다.
여기서의 절차는 간단합니다.
Claude는 생성기 시드가 P-192에는 20000, prime239v1부터 v3에는 20420, 20507, 20509, prime192v2와 v3에는 20512와 20517임을 찾았습니다.
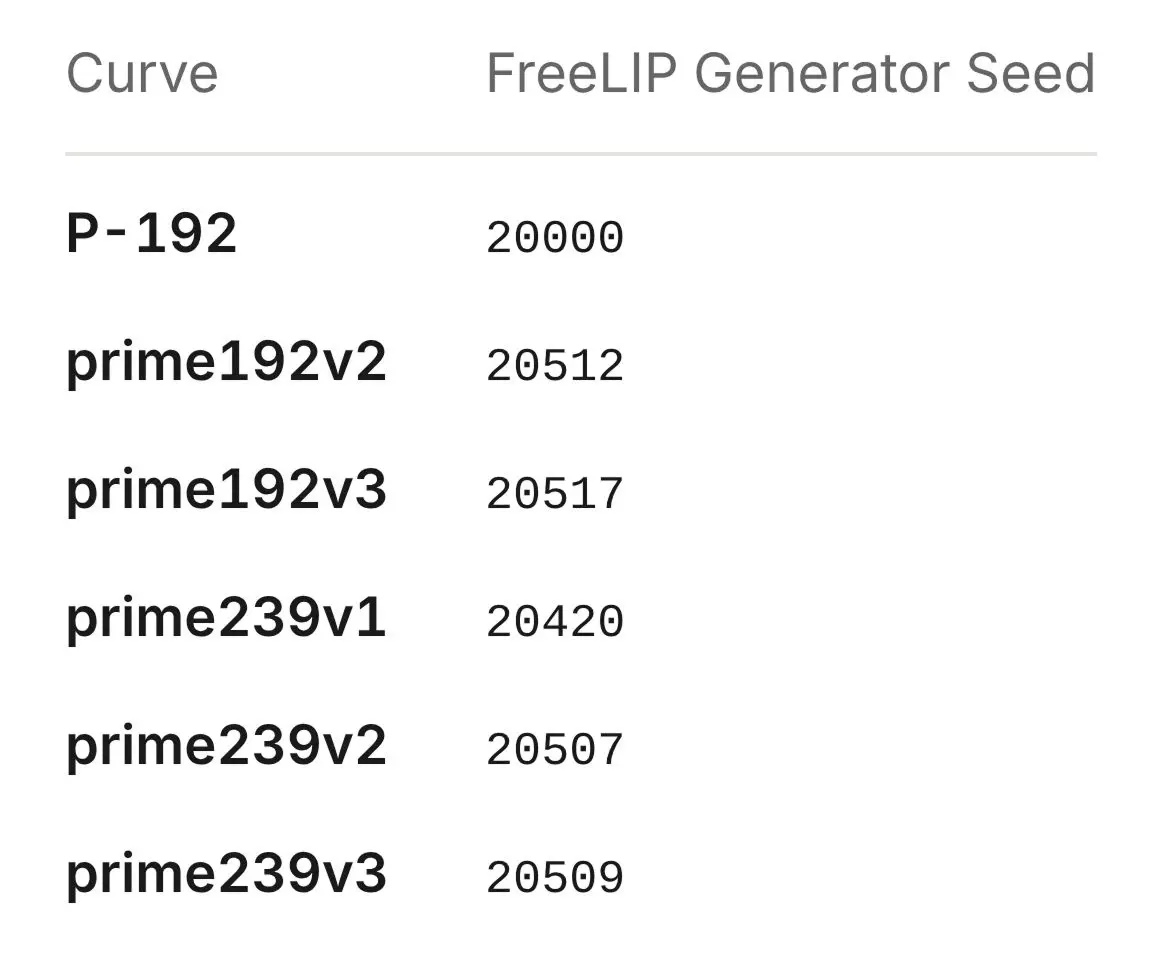
아는 한, NIST 기준점이 설명된 것은 이번이 처음입니다. P-224, P-256, P-384, P-521의 기준점은 이 절차에 맞지 않았으며, 선택 방식을 설명하지 못했습니다.
모든 20바이트 후보 시드가 유효한 곡선을 생성할 수 있는 것은 아니며, 일부 잠재적으로 유효한 곡선이 건너뛰어진 것을 관찰했습니다. P-256의 경우 공개된 시드는 후보 1842이지만, 같은 실행의 후보 876도 적절한 크기의 소수 차수 곡선을 만들며 매개변수는 공개된 곡선과 같은 방식으로 선택됩니다. P-224 실행에서는 이러한 곡선 세 개를 건너뛰었고, ANSI X9.62 예제 곡선 배후의 두 실행에서는 일곱 개를 더 건너뛰었습니다(그림 참조). 어떤 기준이 사용되었는지, 또는 이것이 의도치 않은 산물인지 알 수 없습니다.
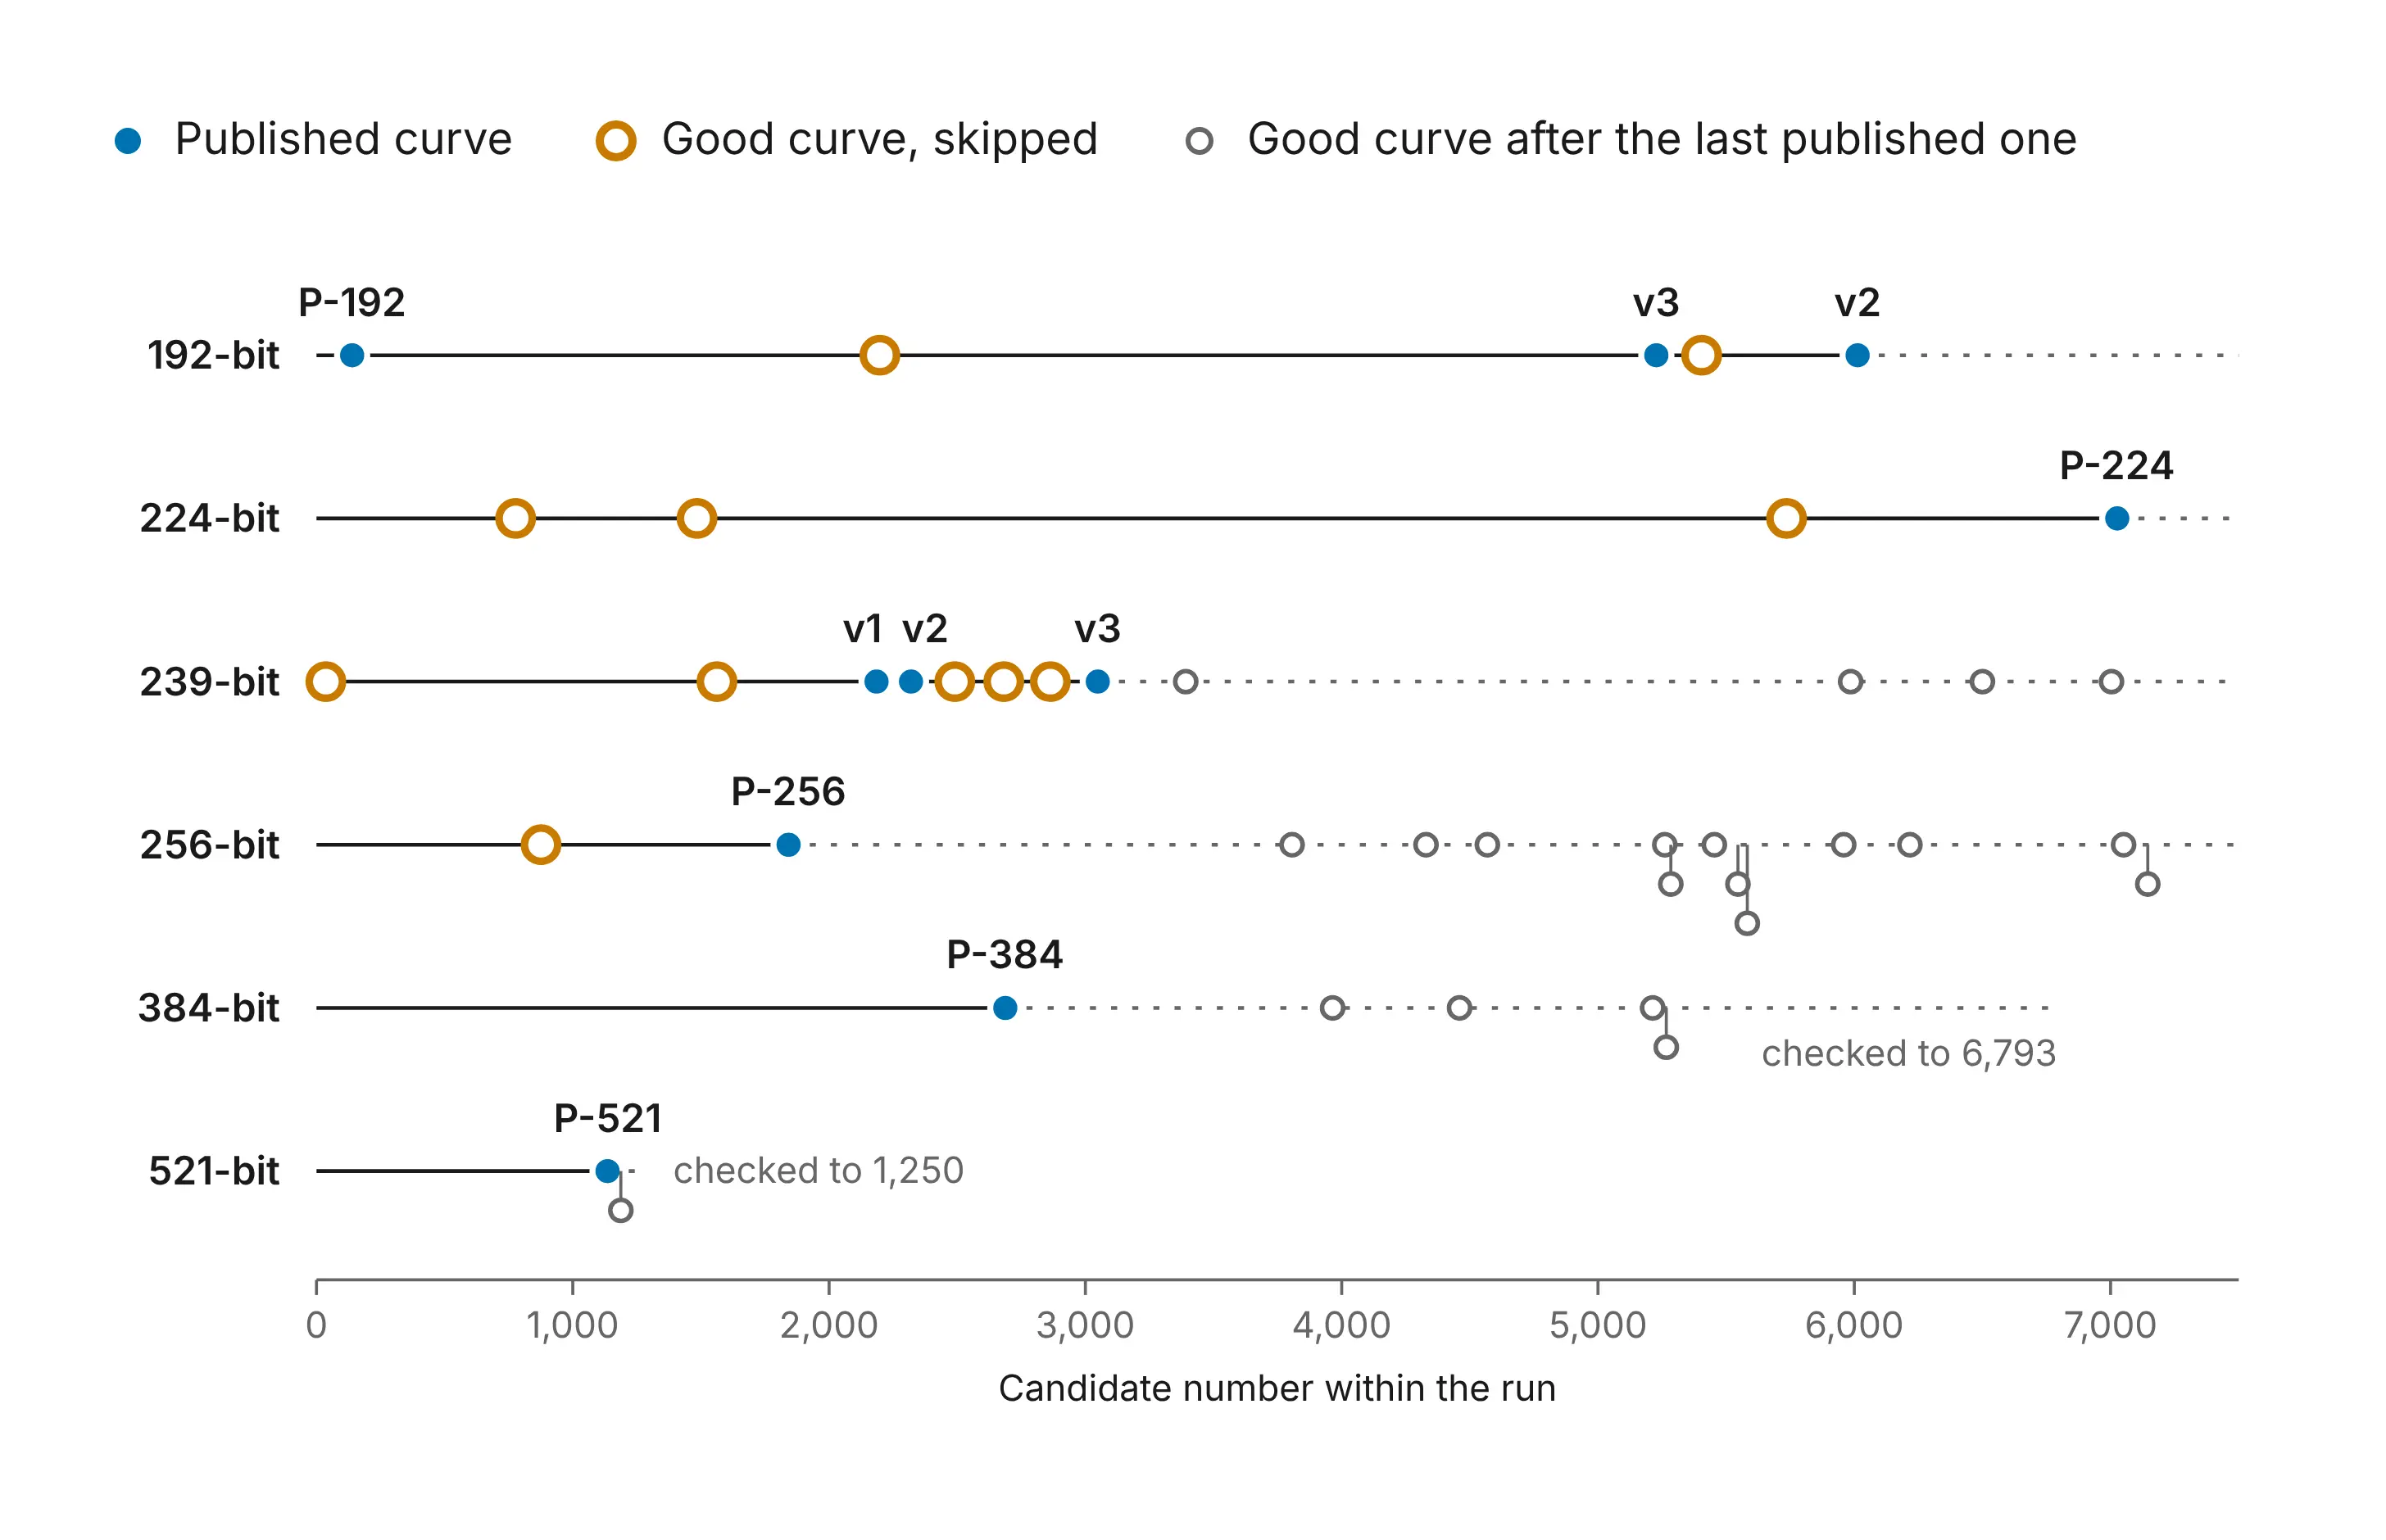
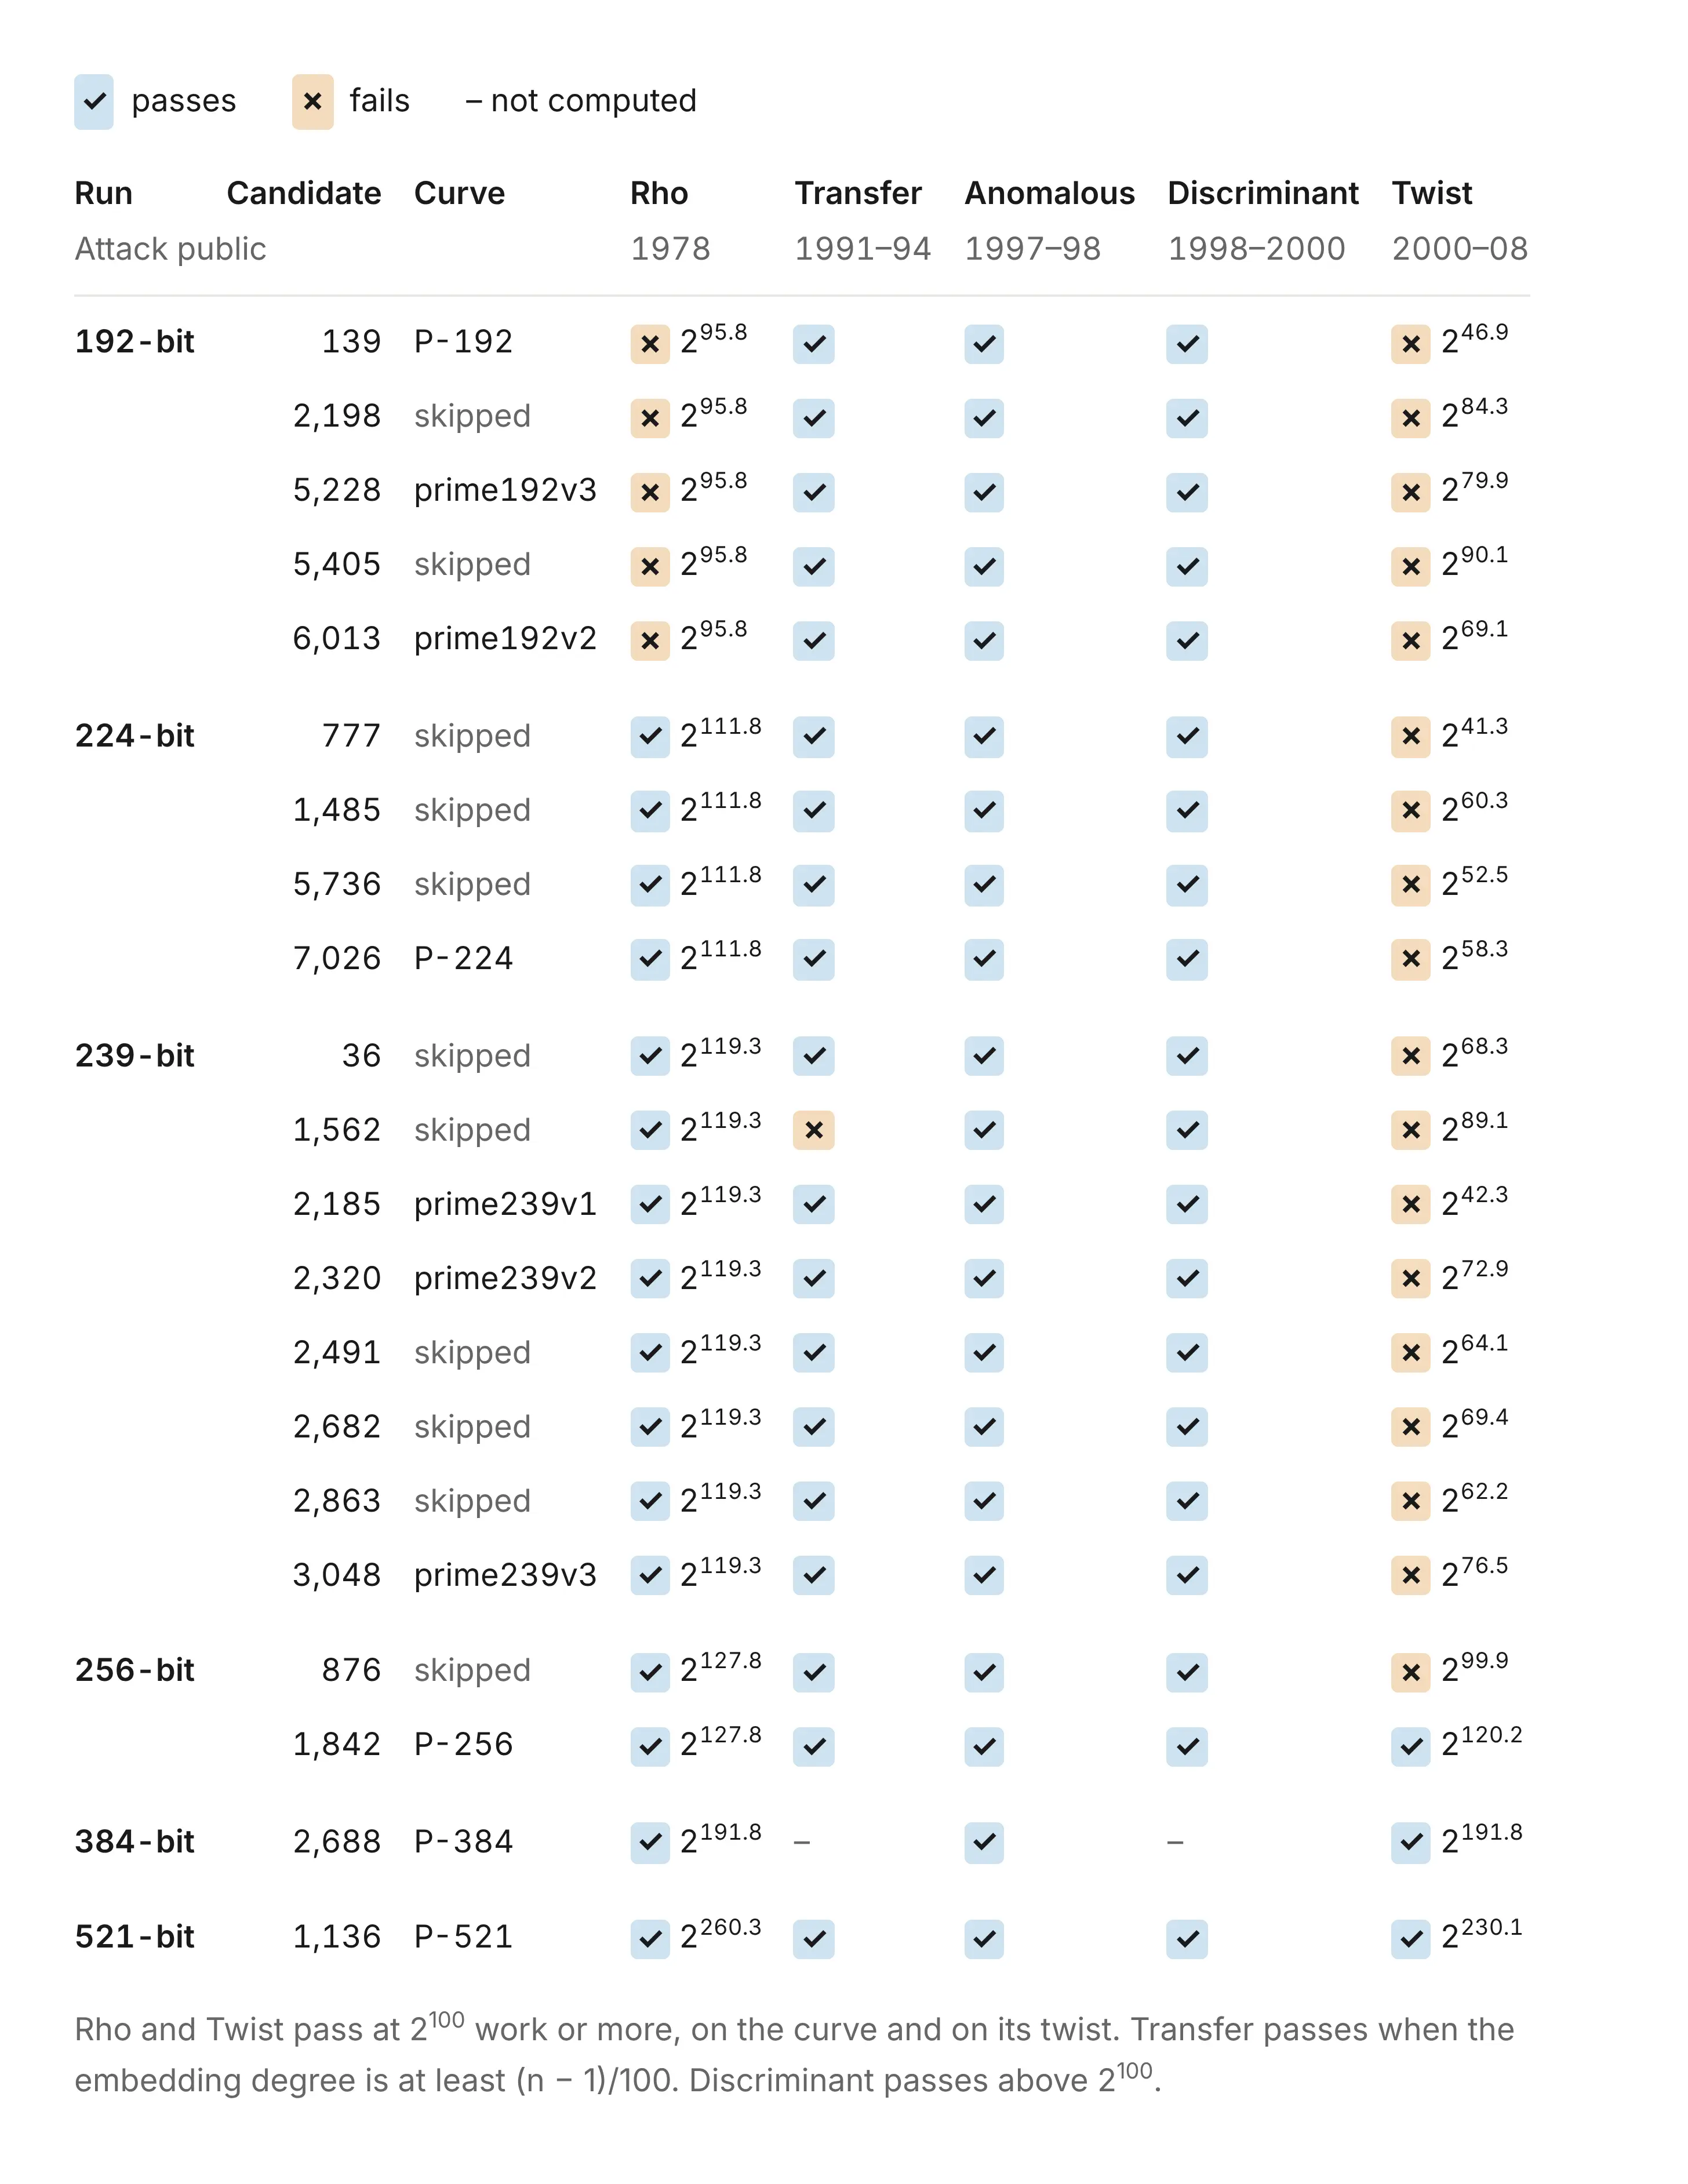
건너뛴 후보 수가 적으므로, 약화된 곡선이 선택되었을 가능성은 그럴듯하지 않다고 봅니다. 그렇다면 약화된 곡선이 흔하고 쉽게 찾아진다는 뜻이 됩니다. 원칙적으로는 난수 생성기에 넣는 타임스탬프를 탐색하여 특정 성질을 갖도록 이 곡선들이 선택되었을 가능성을 여전히 생각할 수 있습니다. 하지만 시드가 무해하게 생성되었다는 증거로 타임스탬프를 공개할 예정일 때만 그렇게 할 필요가 있습니다. 이 숫자들만으로는 실행 횟수를 알 수 없습니다.
또한 복구하지 못한 시드가 하나 있습니다. 다섯 번째 이진 시드인 B-163은 Claude가 시도한 어느 것에도 맞지 않으며, 여전히 설명되지 않았습니다. 마지막으로 P-224, P-256, P-384, P-521의 기준점이 어떻게 생성되었는지도 알지 못합니다. NIST 이진 곡선도 마찬가지입니다.
시드를 찾는 데 걸린 $36,864는 Internet Security Research Group에 기부됩니다.
이 작업은 Anthropic에서 John Wood, Henry de Valence, Ava Howell, Zack Voase, Lucy Sweet, Amir Omidi, Paul Crowley, Iain McGinniss, Nicholas Carlini, Steve Weis가 수행했습니다.
“사악한 인터넷 밈”과 “NSA 괴물들의 Yo La Tengo”라는 꼬리표를 유쾌하게 받아들인 Jerry Solinas를 사후에 기리고 싶습니다. 또한 NIST 타원 곡선 시드 현상금을 조직한 Filippo Valsorda에게 감사드립니다.
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""                      # the state srand48(t) sets
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48              # one step of lrand48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

PRIME = {  # srand48(time); 20 bytes per candidate: lrand48() >> 23
    "prime239v1": ("1997-05-15 15:49:03", 2185),
    "prime239v2": ("1997-05-15 15:49:03", 2320),
    "prime239v3": ("1997-05-15 15:49:03", 3048),
    "P-192":      ("1997-05-18 14:45:34", 139),
    "prime192v3": ("1997-05-18 14:45:34", 5228),
    "prime192v2": ("1997-05-18 14:45:34", 6013),
    "P-521":      ("1997-08-08 01:12:04", 1136),
    "P-256":      ("1997-08-16 01:52:34", 1842),
    "P-384":      ("1997-08-30 14:50:08", 2688),
    "P-224":      ("1998-04-03 12:52:07", 7026),
}
BINARY = {  # srand48(time / 2), if that reading is right; 5 words per candidate: lrand48()
    "B-233": ("1998-04-17 15:24:18", 155),
    "B-283": ("1998-04-17 15:27:44", 32),
    "B-409": ("1998-04-17 15:30:18", 60),
    "B-571": ("1998-04-17 15:32:08", 73),
}
for name, (when, n) in PRIME.items():
    print(f"{name:10} {when} {n:5} {candidate(unix(when), n, 20, 40, 2)}")
for name, (when, n) in BINARY.items():
    print(f"{name:10} {when} {n:5} {candidate(unix(when) // 2, n, 5, 17, 8)}")
이 코드의 출력:
prime239v1 1997-05-15 15:49:03  2185 E43BB460F0B80CC0C0B075798E948060F8321B7D
prime239v2 1997-05-15 15:49:03  2320 E8B4011604095303CA3B8099982BE09FCB9AE616
prime239v3 1997-05-15 15:49:03  3048 7D7374168FFE3471B60A857686A19475D3BFA2FF
P-192      1997-05-18 14:45:34   139 3045AE6FC8422F64ED579528D38120EAE12196D5
prime192v3 1997-05-18 14:45:34  5228 C469684435DEB378C4B65CA9591E2A5763059A2E
prime192v2 1997-05-18 14:45:34  6013 31A92EE2029FD10D901B113E990710F0D21AC6B6
P-521      1997-08-08 01:12:04  1136 D09E8800291CB85396CC6717393284AAA0DA64BA
P-256      1997-08-16 01:52:34  1842 C49D360886E704936A6678E1139D26B7819F7E90
P-384      1997-08-30 14:50:08  2688 A335926AA319A27A1D00896A6773A4827ACDAC73
P-224      1998-04-03 12:52:07  7026 BD71344799D5C7FCDC45B59FA3B9AB8F6A948BC5
B-233      1998-04-17 15:24:18   155 74D59FF07F6B413D0EA14B344B20A2DB049B50C3
B-283      1998-04-17 15:27:44    32 77E2B07370EB0F832A6DD5B62DFC88CD06BB84BE
B-409      1998-04-17 15:30:18    60 4099B5A457F9D69F79213D094C4BCD4D4262210B
B-571      1998-04-17 15:32:08    73 2AA058F73A0E33AB486B0F610410C53A7F132310
M, A = 2**107 - 1, pow(3, 121, 2**107 - 1)       # zrandom: state = state * 3^121 mod (2^107 - 1)
P192 = 2**192 - 2**64 - 1
P239 = 2**239 - 2**143 - 2**95 + 2**47 - 1

CURVES = [  # name, LIP seed, p, b, published Gx   (a = -3 throughout)
    ("prime192v1", 20000, P192,
     0x64210519e59c80e70fa7e9ab72243049feb8deecc146b9b1,
     0x188da80eb03090f67cbf20eb43a18800f4ff0afd82ff1012),
    ("prime239v1", 20420, P239,
     0x6b016c3bdcf18941d0d654921475ca71a9db2fb27d1d37796185c2942c0a,
     0xffa963cdca8816ccc33b8642bedf905c3d358573d3f27fbbd3b3cb9aaaf),
    ("prime239v2", 20507, P239,
     0x617fab6832576cbbfed50d99f0249c3fee58b94ba0038c7ae84c8c832f2c,
     0x38af09d98727705120c921bb5e9e26296a3cdcf2f35757a0eafd87b830e7),
    ("prime239v3", 20509, P239,
     0x255705fa2a306654b1f4cb03d6a750a30c250102d4988717d9ba15ab6d3e,
     0x6768ae8e18bb92cfcf005c949aa2c6d94853d0e660bbf854b1c9505fe95a),
    ("prime192v2", 20512, P192,
     0xcc22d6dfb95c6b25e49c0d6364a4e5980c393aa21668d953,
     0xeea2bae7e1497842f2de7769cfe9c989c072ad696f48034a),
    ("prime192v3", 20517, P192,
     0x22123dc2395a05caa7423daeccc94760a7d462256bd56916,
     0x7d29778100c65a1da1783716588dce2b8b4aee8e228f1896),
]

def base_point_x(seed, p, b):
    state = seed                         # zrstarts(seed)
    def limb():                          # zrandom(2^26): low 26 bits of the new state
        nonlocal state
        state = state * A % M
        return state % 2**26
    for _ in range(7):                   # seven single-limb draws come first
        limb()
    limbs = -(-p.bit_length() // 26) + 1 # zrandomb(p): limbs of p plus one, top limb first
    tries = 0
    while True:
        x = 0
        for _ in range(limbs):
            x = x << 26 | limb()
        x %= p
        tries += 1
        if pow(x**3 - 3*x + b, (p - 1) // 2, p) == 1:   # is x on the curve?
            return x, tries

for name, seed, p, b, gx in CURVES:
    x, tries = base_point_x(seed, p, b)
    print(f"{name:20} seed {seed}  tries {tries}  matches published Gx: {x == gx}")
이 코드의 출력:
prime192v1           seed 20000  tries 2  matches published Gx: True
prime239v1           seed 20420  tries 3  matches published Gx: True
prime239v2           seed 20507  tries 2  matches published Gx: True
prime239v3           seed 20509  tries 1  matches published Gx: True
prime192v2           seed 20512  tries 5  matches published Gx: True
prime192v3           seed 20517  tries 1  matches published Gx: True
법이 허용하는 범위에서 저자들은 이 페이지 코드에 대한 모든 저작권 및 관련권 또는 인접권을 포기하고, 이를 CC0 1.0 Universal에 따라 퍼블릭 도메인에 헌정했습니다(https://creativecommons.org/publicdomain/zero/1.0/).
Claude에 여덟 개 양자 회로의 자연어 명세와 설계를 검사하고 점수화하는 자동 평가기를 제공했습니다. Claude는 대체로 독자적으로 작업하여 공개된 최고 회로를 개선했으며, 일부 경우에는 한 자릿수 이상 개선했습니다. 이는 실용적인 양자 컴퓨터의 실현 시점을 이전 예상보다 앞당길 수 있습니다.
AI는 앞으로 경제를 어떻게 바꿀까요? AI가 경제에 미칠 미래 영향에 관한 의견 불일치의 핵심 원천은 무엇일까요? 이 글은 이 질문들에 관한 새로운 설문 증거를 제시합니다.
AI는 Anthropic의 업무와 고용을 어떻게 재편했을까요? AI 도입의 최전선에 있는 기업으로서 Anthropic은 AI가 경제 전반의 업무 조직, 채용, 노동 수요를 어떻게 바꿀지 보여 주는 선행 지표가 될 수 있습니다.
