KV 캐시가 K와 V를 저장하는 이유, 프리필·프리픽스 캐싱의 차이, 그리고 긴 컨텍스트에서의 계산 및 메모리 트레이드오프를 설명합니다.
긴 프로젝트 문서를 AI에게 맡기고 요약해 달라고 한다고 해 보겠습니다.
답변이 시작되면 토큰이 하나씩 생성됩니다. 다음 내용을 생성할 때도 모델은 앞선 문서와 이미 생성한 답변을 활용해야 합니다.
토큰을 하나 더 쓸 때마다 점점 길어지는 전체 텍스트를 처음부터 다시 계산해야 할까요?
KV 캐시는 이미 완료된 계산의 일부를 모델이 보존하게 해 줍니다. 그런데 왜 K와 V를 보존할까요? 마찬가지로 어텐션에 참여하는 Q는 왜 보통 사용한 뒤 버려도 될까요?
이 글에서는 이 문제를 살펴보며 KV 캐시를 이해해 보겠습니다.
입력을 “The sky is”로 줄이고, 모델이 이어서 “ blue”, 그다음 “.”를 생성한다고 가정해 보겠습니다.
모델은 먼저 전체 프롬프트를 처리해 각 층의 KV 캐시를 구축합니다. 이 단계를 프리필이라고 합니다. 마지막 프롬프트 위치의 출력은 어휘 헤드를 거쳐 첫 번째 출력 토큰을 선택하는 데 쓰이는 로짓을 만듭니다.
“ blue”를 선택한 뒤 모델은 이를 새 입력으로 넣어 “.”를 계속 예측합니다.
아래 애니메이션을 보세요. “blue”가 나타나기 전과 후에 어떤 블록은 제자리에 남고, 어떤 블록은 새로 추가될까요?
기존 K/V는 제자리에 남고, 새 위치의 K/V가 뒤에 추가됩니다. 새 토큰은 여전히 모델 계산을 거쳐야 하지만, 유효한 과거 상태를 중복 계산할 필요는 없습니다.
순서에 유의하세요. “blue”를 선택할 때는 그 K/V가 아직 생성되지 않았습니다. 이를 모델에 다시 넣어 후속 토큰을 예측할 때 비로소 해당 K/V가 계산됩니다.
하나의 어텐션 층에서 각 위치에는 히든 스테이트라고도 하는 입력 벡터가 있습니다. 세 개의 학습 가능한 투영이 이를 쿼리(Q), 키(K), 밸류(V)로 변환합니다.
blue 위치를 처리할 때 새 Q는 The sky is 및 blue 자신에 해당하는 K와 매칭 점수를 계산합니다.
점수는 스케일링과 소프트맥스를 거쳐 어텐션 가중치가 됩니다. 이어 해당 V를 이 가중치로 가중합하여 이 헤드의 출력을 얻습니다.
다음 위치는 자신의 Q를 새로 만들지만, 여전히 이 위치들의 K/V를 읽어야 할 수 있습니다. 과거 Q는 해당 위치의 계산을 이미 끝냈으므로 일반적인 디코딩에서는 다시 사용할 필요가 없습니다.
이 과정을 수식으로 쓰면 아래 한 줄과 같습니다.
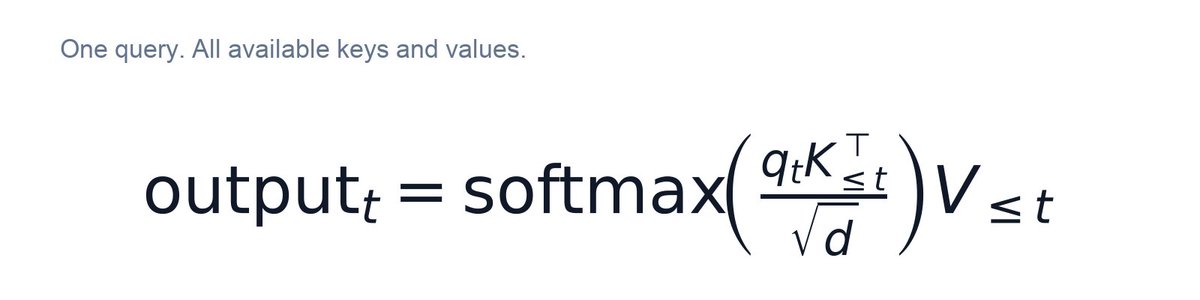
이것이 KV 캐시라는 이름을 설명합니다. K/V는 후속 위치가 계속 읽을 수 있도록 남아 있고, Q는 새 위치마다 다시 생성됩니다.
프로젝트 문서로 돌아가 보겠습니다. 문서 시작 부분에 “예산은 100만 위안”이라고 쓰여 있고, 뒤에는 진행 상황, 인력, 납품 계획이 있다고 가정합니다.
이제 두 작업을 비교해 보겠습니다.
어느 작업이 기존 캐시를 무효화할까요? 먼저 생각한 뒤 애니메이션을 보세요. 그림의 글자는 토큰 위치를 나타냅니다.
차이는 인과적 어텐션의 정보 방향에서 나옵니다. 한 위치는 자신과 그 앞의 입력만 사용할 수 있고, 뒤에 오는 내용은 읽을 수 없습니다.
따라서 끝에 질문을 추가해도 문서 위치에서 이미 완료된 계산이 거꾸로 바뀌지는 않습니다. 반면 시작 부분의 예산을 수정하면 후속 위치의 표현에 영향을 줄 수 있으므로, 기존 전체 캐시를 그대로 재사용할 수 없습니다.
즉, 시작의 “100만 위안”을 “50만 위안”으로 바꾸면 이후 모든 토큰 생성 시의 컨텍스트에 영향을 주므로 기존 캐시는 무효화됩니다.
이제 “blue”가 모델에 다시 입력되는 단계를 확대해 보겠습니다. 하나의 어텐션 헤드만 보면 다음과 같습니다. 과거 K/V는 그대로이고, 새 위치가 Q/K/V를 생성하며, 새 Q가 사용 가능한 K/V를 읽습니다.
새 K/V는 먼저 캐시에 추가된 뒤 어텐션에 참여하므로, 현재 Q도 자기 자신의 위치에 주의를 기울일 수 있습니다. 이 헤드의 출력이 층 내부의 후속 계산과 모델의 다른 부분에서 사용된 뒤에도 K/V는 다음 위치가 읽을 수 있도록 남아 있습니다.
그림의 헤드 출력은 다음 토큰 로짓을 얻으려면 층 내부의 후속 계산과 모델의 다른 부분도 거쳐야 합니다. 입력과 실행 조건이 호환된다면 캐시를 사용한 결과와 사용하지 않은 결과는 적절한 수치 오차 범위에서 일치해야 합니다.
프로젝트 문서가 길어질수록 보존해야 하는 위치도 더 많아질 수 있습니다. 시퀀스에 따라 늘어나는 전체 KV 캐시를 사용하면 새로 추가된 위치는 계속 저장 공간을 차지합니다.
차원을 따라 세어 볼 수 있습니다. 시퀀스 수, 층 수, 각 층이 보존하는 위치 수, KV 헤드 수, 각 헤드의 너비, 그리고 각 원소가 차지하는 바이트 수입니다.
K/V를 따로 저장하고 너비가 같으며 모든 층의 구조가 동일하다고 가정하면, 이들을 곱한 값은 다음과 같습니다.
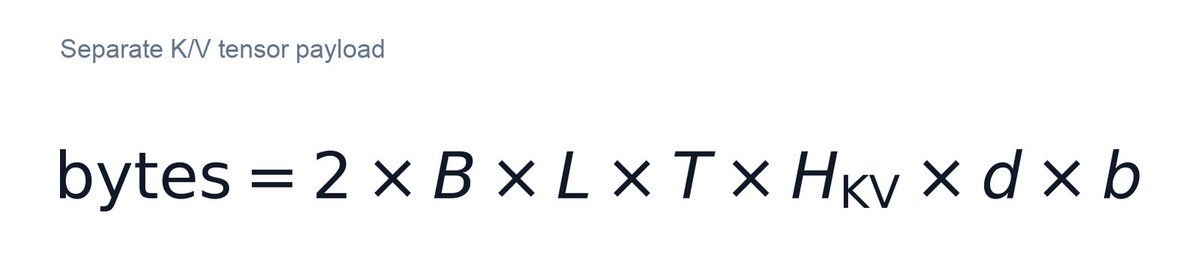
이 문서에 가상의 구성을 적용해 보겠습니다. 24개 층, 시퀀스 1개, KV 헤드 8개, 헤드 너비 64, 원소당 2바이트입니다.
애니메이션의 두 변화를 보세요. 먼저 위치 수를 늘린 다음 원래 길이로 돌아가고, KV 헤드가 더 적은 다른 구성을 비교합니다.
AI에게 위험 요약을 요청한 뒤, 이번에는 마감일을 알고 싶다고 해 보겠습니다. 두 요청이 다음과 같이 구성되어 있다고 가정합니다.
요청 A: [같은 프로젝트 문서] + “위험을 요약해 주세요.”
요청 B: [같은 프로젝트 문서] + “마감일을 나열해 주세요.”
문서 부분의 실제 토큰 프리픽스가 완전히 같고, 모델과 실행 설정이 호환되며, 시스템이 이 부분의 캐시를 계속 보존하고 있다면 이를 재사용한 뒤 두 질문과 각각의 후속 생성을 계산할 수 있습니다. 이를 프리픽스 캐싱이라고 합니다.
프리필, KV 캐시, 프리픽스 캐싱은 다음처럼 구분할 수 있습니다. 프리필은 프롬프트를 처리하는 계산 단계이고, KV 캐시는 저장된 K/V 상태이며, 프리픽스 캐싱은 기존 프리픽스 상태를 재사용하는 전략입니다. 프리픽스 캐싱을 활성화하지 않아도 일반적인 생성에는 KV 캐시를 사용할 수 있습니다.
vLLM의 공식적인 대표 사례는 같은 연차 보고서나 소프트웨어 매뉴얼에 반복해서 질문하는 것입니다. 위 프로젝트 문서도 같은 사용 방식입니다. 첫 번째 요청은 프리필로 캐시를 만들고, 이후 공통 프리픽스가 적중하면 해당 K/V를 바로 재사용하여 이 부분의 중복 계산을 줄입니다.
새 질문은 여전히 프리필을 계속 수행하고 문서의 K/V를 읽어야 하며, 새 답변은 여전히 토큰별로 디코딩해야 합니다. 프리픽스 캐싱은 주로 반복되는 프리필 작업을 줄이며, 새 답변의 생성 계산까지 줄여 주지는 않습니다.
요청 B가 문서 앞에 다른 설명을 하나 더 넣으면 공통 프리픽스는 짧아질 수 있습니다. 뒤의 문서 텍스트가 같더라도 그 인과적 상태가 같다고 바로 단정할 수는 없습니다.
앞에서는 “각 층이 자신의 K/V를 저장한다”는 방식에서 출발했습니다. 이런 계산 의존성을 이해하면 DeepSeek-V4.1-Flash의 몇 가지 변화를 파악할 수 있습니다.
먼저 출처를 보겠습니다. 인과적 인코더-디코더입니다. 디코더의 전역 KV는 인과적 인코더의 최종 출력에서 나옵니다. 각 디코더 층은 여전히 자신의 Q와 로컬 슬라이딩 윈도우 KV를 생성합니다.
다음은 층 간 공유입니다. 크로스 레이어 공유입니다. 논의 중인 구성에서는 21번째 층이 인코더 출력을 활용해 하나의 디코더 전역 KV 뱅크를 만들고, 이를 21~40번째 층이 사용합니다.
21번째와 22번째 층을 주의 깊게 보세요. 이들은 공유 전역 항목을 읽지만, Q와 로컬 상태는 각각 유지합니다. 공유 항목이 동일한 어텐션 가중치를 강제하지는 않으며, 희소 선택이 어떤 전역 항목을 읽을지 결정합니다.
마지막으로 K/V의 표현을 보겠습니다. 공유 KV 표현입니다. 참조 코어 어텐션 커널에서는 동일하게 선택된 벡터가 Q의 매칭 점수 계산과 출력의 가중합 모두에 참여합니다.
애니메이션을 보세요. 하나의 전역 KV가 여러 층에 어떻게 연결될까요? 한 벡터를 확대하면, 그 벡터는 다시 어떤 두 계산에 참여할까요?
모델은 여전히 로컬 캐시, 인덱서 상태 등의 데이터를 보존합니다. 공유 KV 표현은 독립적인 K/V 배열 두 개를 나란히 저장하는 것과 분명히 다릅니다.
프로젝트 문서로 돌아가 보겠습니다. 이번 입력이 10만 개 토큰이라고 가정합니다. 보고서의 서빙 방식은 다음처럼 처리할 수 있습니다.
이는 전역 KV의 출처가 프리필에서 어떤 계산을 조정할 수 있는지에 영향을 준다는 점을 보여 줍니다. 후속 토큰을 생성할 때 새 입력은 여전히 인과적 인코더와 디코더를 거칩니다.
이제 같은 상황을 따라 KV 캐시를 연결해 볼 수 있습니다.
