재귀적 자기개선에서 하니스 엔지니어링의 역할, 설계 패턴, 최적화, 진화적 탐색과 향후 과제를 살펴본다.
재귀적 자기개선(RSI) 이라는 개념은 I. J. Good (1965)까지 거슬러 올라간다. 그는 “초지능 기계”를 모든 지적 활동에서 인간을 능가하고 자신을 개선하기 위한 더 나은 기계를 설계할 수 있는 시스템으로 정의했다. Yudkowsky (2008)는 AI가 현재의 지능을 이용해 그 지능을 만들어 내는 인지적 기제를 개선하는 특정 피드백 루프를 가리켜 “재귀적 자기개선”이라는 표현을 사용했다.
현대 AI에서 이 피드백 루프는 모델이 자신의 가중치를 직접 다시 쓰는 것을 뜻할 수도 있고, 더 넓게는 경제적으로 가치 있는 과제 전반에서 성능이 향상된 후속 모델을 가능하게 하는 훈련 파이프라인 및 _배포 시스템_을 모델이 개선하는 것을 뜻할 수도 있다. 최전선 연구소에서 AI 연구 개발의 속도가 극적으로 가속되었음이 나타났다(Anthropic; OpenAI).
원시 모델과 현실 세계의 맥락 사이의 계층이 모델의 원시 지능만큼 중요해 보이기 때문에 _“배포 시스템”_을 명시적으로 언급한다. 이는 사전학습 직후의 평가를 뜻한다. Claude Code와 Codex 같은 성공적인 코딩 에이전트 제품이 보여 주듯, 하니스는 AI 배포의 중요한 구성 요소다. 하니스는 기반 모델을 둘러싼 시스템으로, 실행을 조율하고 모델이 사고하고 계획하는 방식, 도구를 호출하고 행동하는 방식, 맥락을 인지하고 관리하는 방식, 산출물을 저장하는 방식, 결과를 평가하는 방식을 결정한다.
이 글은 하니스 엔지니어링 연구와 그것이 RSI에 기여하는 방식에 초점을 맞춘다. 자동 연구, 자기개선 에이전트, 진화적 프로그램 탐색에 관한 최근 연구 대부분은 이 질문을 중심으로 정리할 수 있다. 모델 자기대전, 합성 데이터, 추론 시점 훈련 및 더 폭넓은 지속 학습이라는 주제의 다른 연구도 RSI 비전과 부합하지만(예: Yuan et al. 2024, Chen et al. 2024, Zhao et al. 2025, Choi et al. 2026)), 이 글의 중심 주제는 아니다.
초기 에이전트 프레임워크의 “에이전트 = LLM + 메모리 + 도구 + 계획 + 행동”과 비교하면, 하니스 엔지니어링에는 추가로 _워크플로 설계(예: 루프 엔지니어링), 평가, 권한 제어, 영속 상태 관리_가 포함된다. 더 이상 프롬프트 템플릿만의 문제가 아니라, 모델이 관찰하고 행동하고 기억하고 스스로 점검하며 개선하는 방식을 다루는 런타임 및 소프트웨어 시스템 설계에 가깝다.
일반화를 가능하게 하려면 설계는 의도적으로 단순하고 범용적이어야 하며, 사전훈련 지식의 이점을 얻기 위해 기존 소프트웨어 엔지니어링 관행을 참조할 가능성이 크다. 운영체제와 하니스 사이에도 강한 유비가 있다. 운영체제처럼 하니스는 복잡한 논리를 캡슐화하면서 인터페이스는 단순하게 유지해야 한다. 한편 설정, 도구 인터페이스 및 기타 프로토콜은 산업 전반에서 점차 표준화될 수 있다.
모델이 작동하고, 시험하고, 반복할 수 있는 워크플로를 정의하는 일은 자동화의 핵심 설계다. Karpathy의 autoresearch 저장소(https://github.com/karpathy/autoresearch)는 이런 워크플로를 어떻게 구성할 수 있는지 보여 주는 깔끔한 사례다. 일반적인 워크플로는 목표가 달성될 때까지 계획, 실행, 관찰/시험, 개선, 재실행을 반복하는 목표 지향 루프를 따른다. 이 과정은 과제 명세나 실행 선호를 명확히 하기 위해 사용자에게 능동적으로 요청할 수 있다.
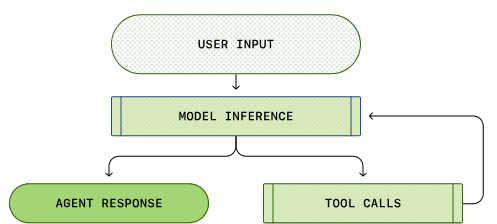
단순화한 Codex 에이전트 루프: 에이전트는 도구를 호출하며, 도구 응답은 모델의 다음 생성에 영향을 준다.
(이미지 출처: OpenAI codex agent post)
워크플로 그래프는 또한 정적 프롬프트 템플릿이 아니라 “에이전트 런타임”을 통해 모델이 자신의 궤적과 실패 사례를 분석하고 진행 상황을 반복적으로 개선한다는 점을 강조한다.
장기 지평 에이전트 시스템에서 반복적으로 등장하는 패턴은 풍부한 상태와 산출물을 단순하게 제어하는 것이다. 하니스가 전체 워크플로와 모든 로그를 맥락에 담아서는 안 되며, 대신 파일에 지속 가능한 상태를 보관해야 한다. 장기 지평 에이전트 롤아웃에서는 실험 로그, 코드 차이, 논문 요약, 오류 추적, 과거 롤아웃 궤적 같은 산출물이 모델이 훈련된 맥락 창보다 훨씬 길어지는 경우가 많다.
파일 시스템을 읽고, 쓰고, 편집하는 방법을 배우는 일(흔히 bash 명령을 통해)은 LLM의 기초 역량이다. 따라서 파일이라는 단순한 형태로 영속 메모리를 관리하는 일은 핵심 모델 역량의 향상으로부터 자연스럽게 이득을 얻는다.
하니스는 여러 하위 에이전트를 생성하여 병렬로 실행하고 백엔드 작업을 감시할 수 있다. 이는 주 에이전트가 여러 가설을 탐색하거나, 실험을 동시에 실행하거나, 주 맥락을 오염시키지 않고 독립된 하위 과제를 위임해야 할 때 유용하다. 그러면 부모 에이전트에는 작업을 시작하고, 로그를 검사하고, 실패한 실행을 취소하고, 결과를 주 에이전트 스레드로 병합하는 작은 프로세스 관리자가 필요하다.
핵심 설계 선택은 병렬성을 명시적이고 검사 가능하게 만드는 것이다. 하위 에이전트 출력이 일시적인 채팅 맥락에만 존재하면 빠르게 낡고 숨겨진다. 파일, 로그, 상태 기록으로 저장된다면 모델은 중단 후에도 복구하고 자신의 실행 이력을 추론할 수 있다.
주류 코딩 에이전트의 핵심 인터페이스는 Claude Code, Codex, OpenCode, Cursor 스타일 에이전트 전반에서 안정화되었다. 이들은 흔히 다음과 같은 루프를 사용한다.
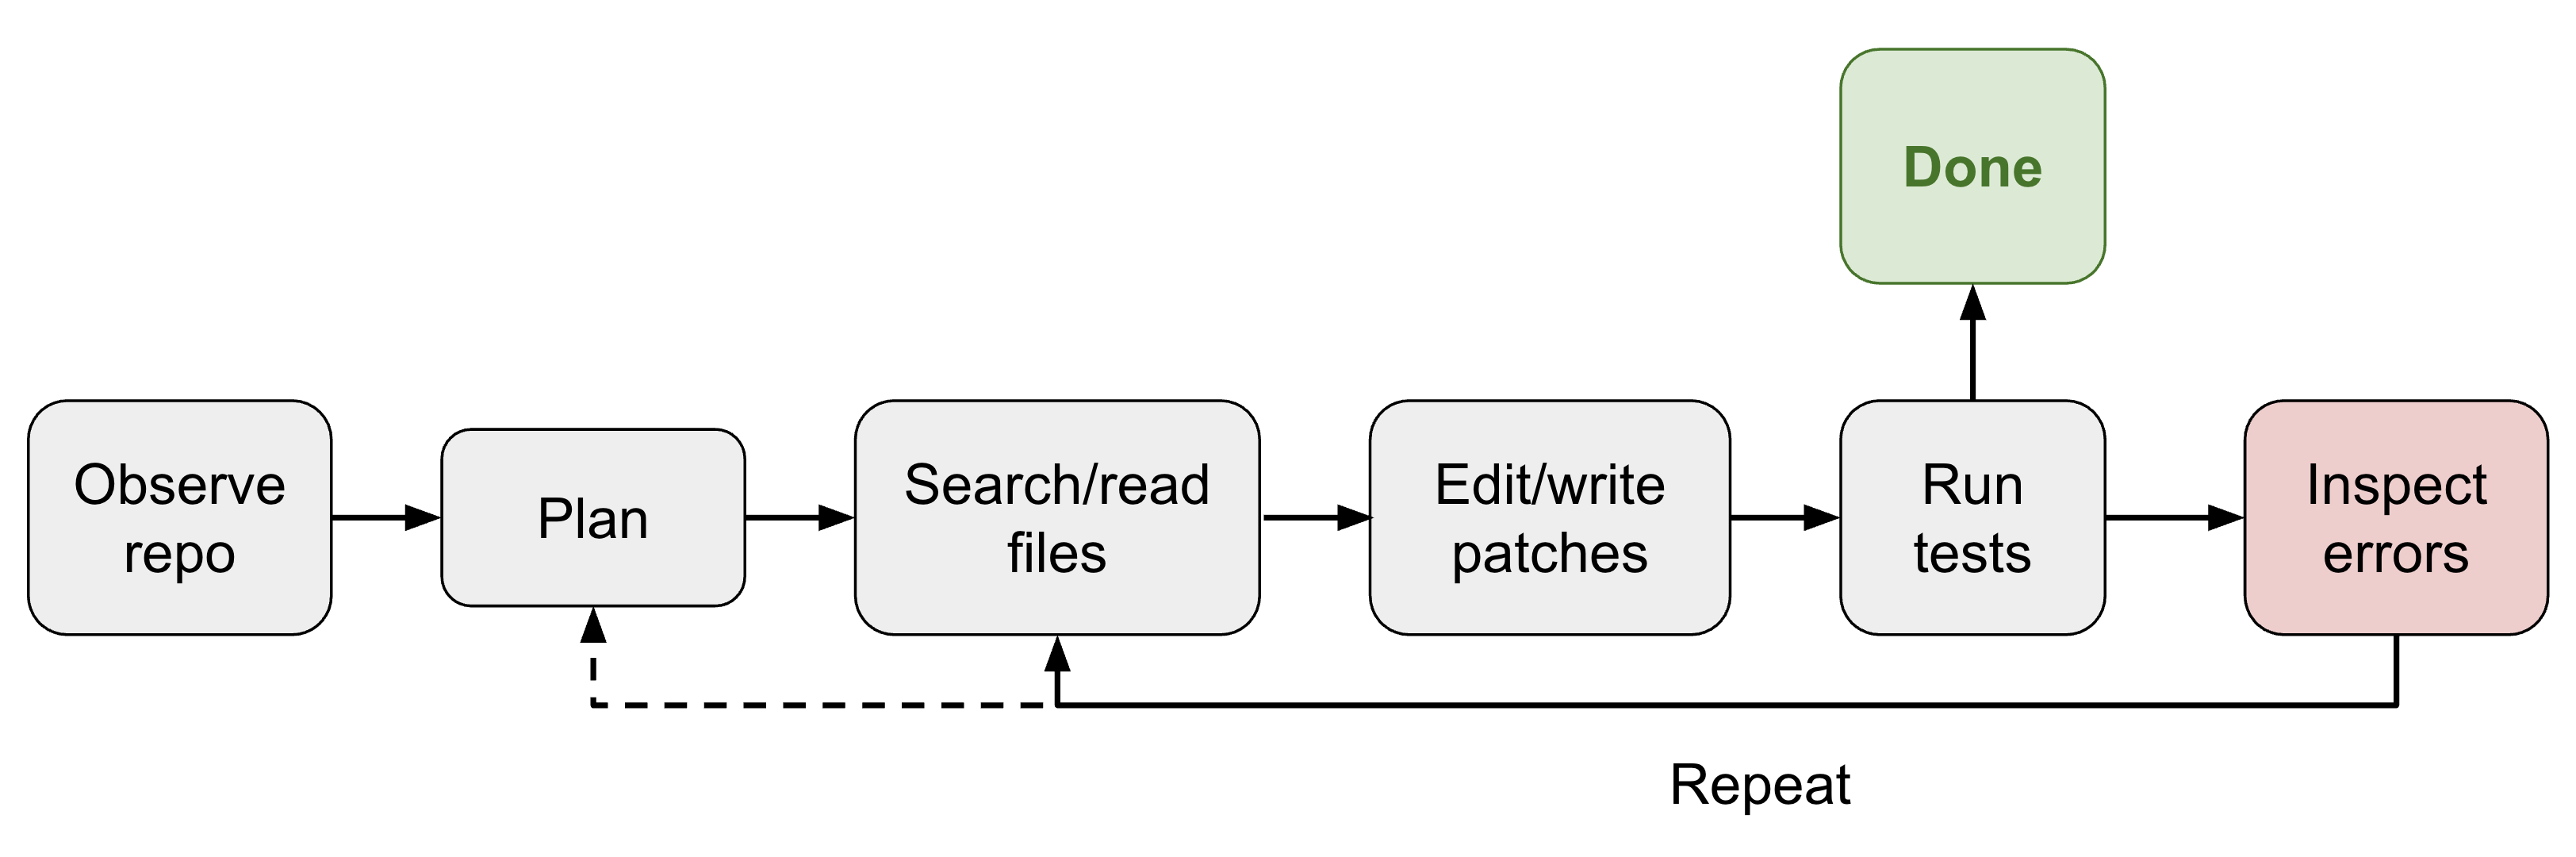 도구 집합에 접근할 수 있는 코딩 에이전트는 인간 개발자가 IDE를 갖추는 방식과 비슷하게 주어진 저장소에서 이슈를 개발하고 디버그할 수 있다.
(포괄적 목록은 아니며, 시연을 위해 제시했다. 관심이 있다면 this를 읽어 보라.)
| 그룹 | 도구 정의 |
|---|---|
| 파일 시스템 | - 파일 탐색: glob, grep, ls - 파일 읽기: read, read_many - 파일 수정: write(완전히 새 파일), edit(문자열 정확 일치 치환), multi_edit, apply_patch(구조화된 패치/차이 적용) |
| 셸 실행 | 명령 실행: bash, PowerShell |
| 입출력 | lsp, git_status, git_diff, git_commit 같은 git 도구 |
| 외부 맥락 | MCP 도구, Skills |
| 웹 검색 | web_search, web_fetch, 브라우저 도구 |
| 산출물 | 문서, 이미지 읽기; HTML, 이미지 생성 |
| 백엔드 프로세스 | 예: CronCreate, CronDelete, CronList |
| 에이전트 위임 | 예: spawn_agent, resume_agent, wait_agent, list_agents, close_agent, interrupt_agent 등 |
미래 RSI가 하니스 엔지니어링에 얼마나 의존할지 예측하기는 어렵지만, 단기 RSI의 경로가 모델이 자신의 가중치를 직접 다시 쓰는 것으로 시작할 가능성은 낮다. 실용적인 단기 경로에 대한 내 예측은 다음과 같다.
결국 많은 하니스 개선은 핵심 모델 행동에 _내재화_될 수 있지만, 외부 맥락 및 도구와의 인터페이스는 남아야 한다. 프롬프트 엔지니어링에서 이 패턴의 더 약한 형태를 이미 보았다. 수작업 프롬프트 요령은 명령어 미세조정과 모델 추론의 향상에 따라 덜 중심적이 되었지만, 목표, 제약, 맥락, 평가를 명시해야 할 필요는 사라지지 않았다.
하니스 시스템에서 최적화 대상의 발전은 대략 명령 프롬프트 → 구조화된 맥락 → 워크플로 → 하니스 코드 → 최적화기 코드 순서다. 모델이 더 지능적이고 강력해질수록 우리는 더 복잡한 대상과 범용적 방법으로 이동한다.
에이전트 작업의 지평이 크게 늘어날 때 모든 도구 응답과 모델 생성을 단순히 맥락에 덧붙이면 빠르게 통제 불능으로 커질 수 있다. 맥락 관리는 LLM을 위해 더 구조화되고 간결한 맥락을 구성하고 영속 상태를 관리하는 계층이다. 장문맥 연구가 계속 발전할 것이라는 점에는 의심의 여지가 없지만, 현재 장문맥 지능과 맥락 엔지니어링은 때때로 얽혀 있다.
에이전트형 맥락 엔지니어링(ACE; Zhang et al. 2025)은 맥락을 계속 길어지는 프롬프트가 아니라 진화하는 실행 지침서로 취급한다. 식별자와 설명을 갖는 글머리 항목들로 된 하나의 맥락 지침서를 유지하는 세 구성 요소가 있다.
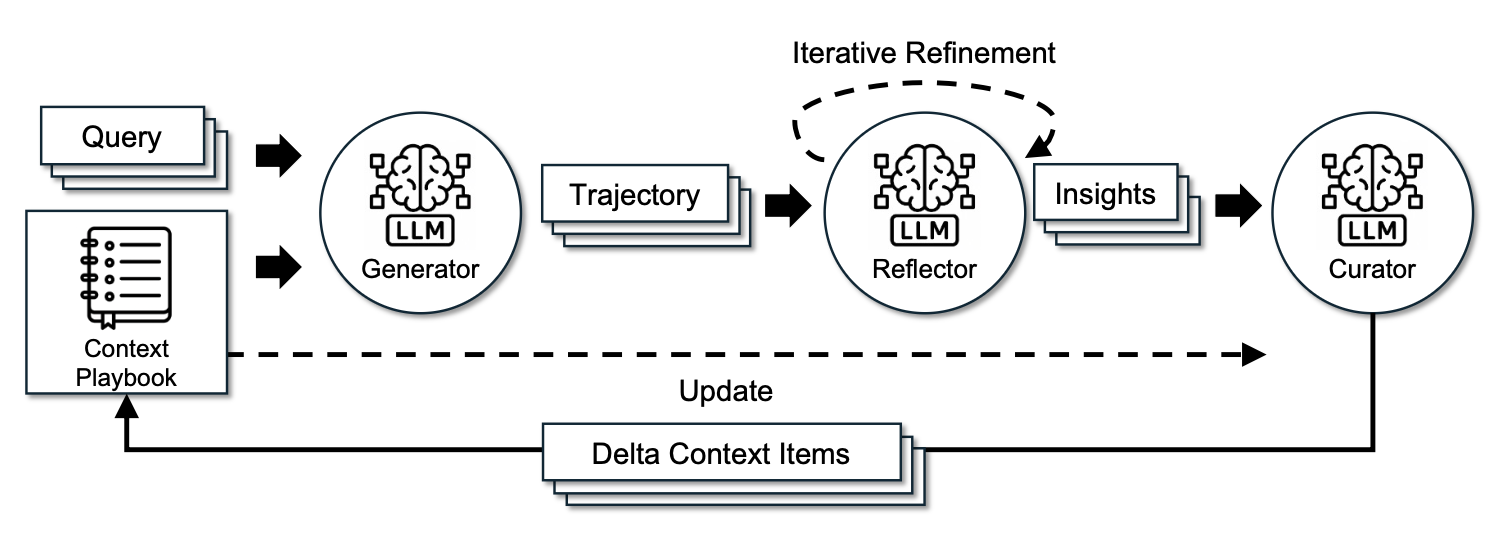
에이전트형 맥락 엔지니어링(ACE)의 프레임워크. (이미지 출처: Zhang et al. 2025)
반복 재작성 중 맥락 붕괴와 간결성 편향을 막기 위해 ACE의 핵심 설계 선택 하나는 관리기가 전체 프롬프트 덩어리를 다시 쓰지 않는다는 것이다. 대신 (식별자, 설명) 형태의 구조화되고 항목화된 글머리 항목 모음을 출력하며, 이 항목들은 결정론적 논리로 구조화된 맥락 일지에 병합된다. 맥락 항목은 주기적으로 정제되고 중복 제거된다.
ACE가 롤아웃에서 통찰을 학습한다는 사실은 자기 관리 메모리에 가까이 다가가게 해 주지만, 갱신 규칙과 전체 워크플로는 여전히 수작업으로 만든 것이다. 더 자기개선적인 루프로 나아가기 위해 메타 맥락 엔지니어링(MCE; Ye et al. 2026)은 메커니즘(맥락 관리 방법)을 산출물 내용(맥락에 있는 것)과 분리하고, 메타 최적화 수준에서 기술 진화를 실행하며 기저 수준에서 맥락 최적화를 실행한다.
MCE 기술은 맥락 함수를 정의하고 입력을 맥락으로 매핑한다. 여기서:
이중 수준 최적화는 훈련 데이터에서 주어진 기술에 가장 적합한 맥락을 찾는 것이며, 외부 루프는 검증 세트에서 가장 높은 성능을 제공하는 최적 기술을 찾는다.
기술 데이터베이스는 이전 기술, 맥락 함수, 평가 지표의 이력을 추적한다. 메타 수준 에이전트는 과제에 대해 새 기술을 만들기 위해 이전 기술들에 걸쳐 에이전트형 교차를 수행한다. 그다음 기저 수준 맥락 엔지니어는 현재 기술의 안내를 받아 기술을 실행하고 롤아웃 피드백에서 맥락 함수를 학습한다.
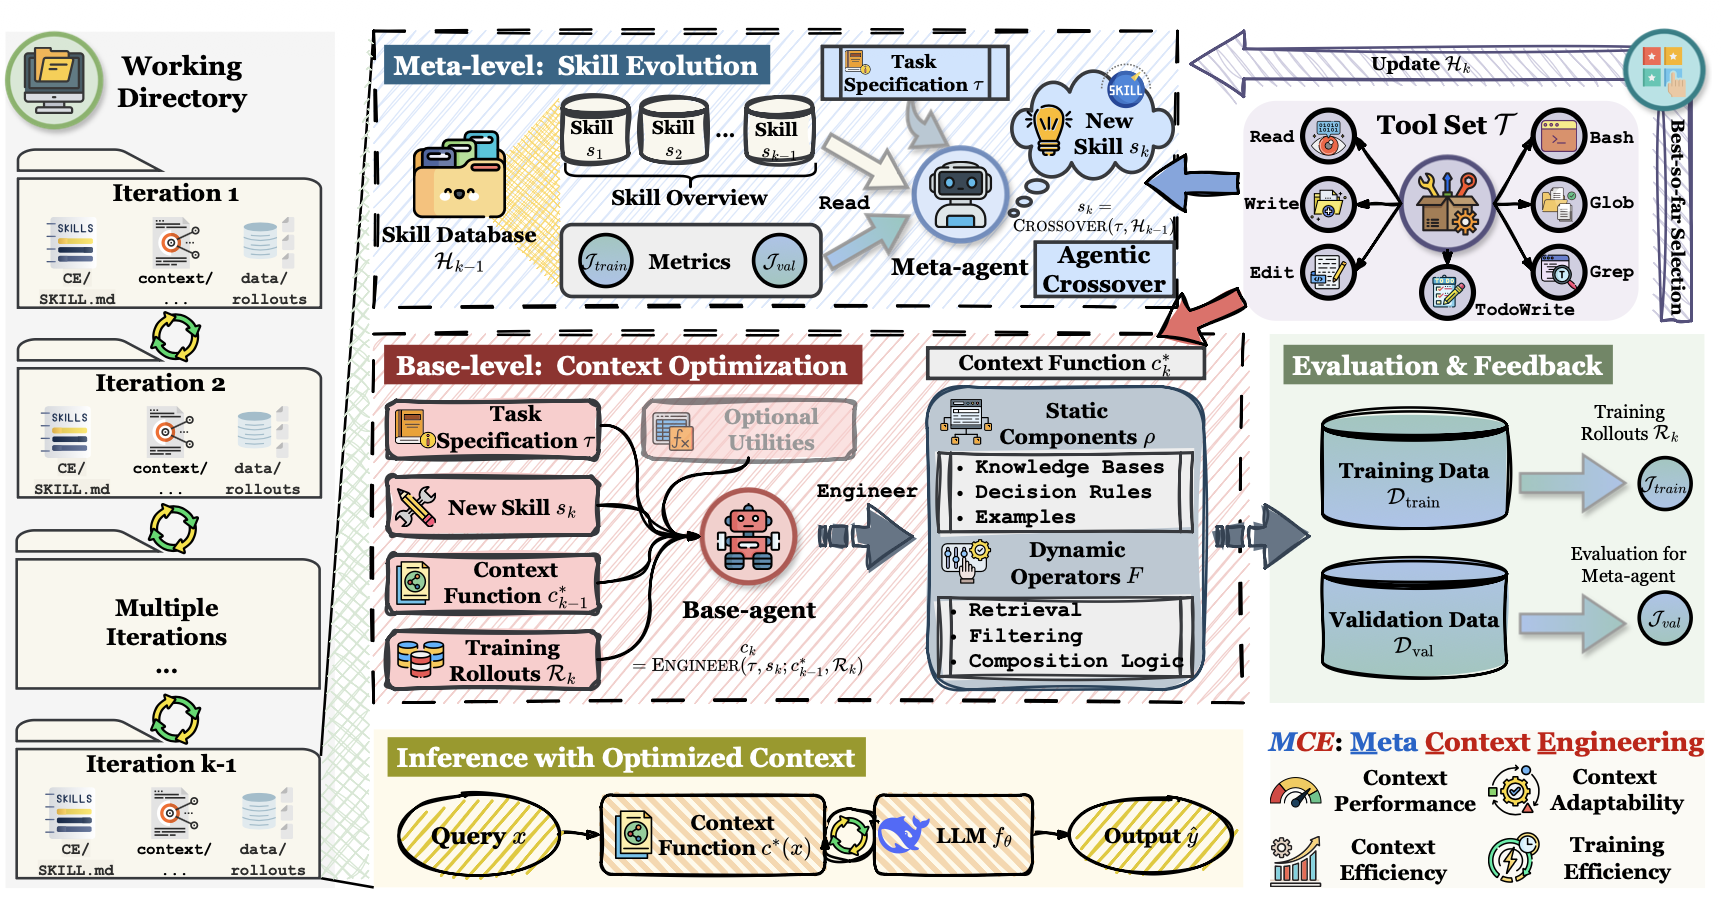
메타 맥락 엔지니어링(MCE)의 프레임워크: 메타 수준 기술 진화는 맥락 관리 메커니즘을 탐색하고, 기저 수준은 과제 맥락을 최적화한다. (이미지 출처: Ye et al. 2026)
MCE는 ACE처럼 맥락을 구조화하는 방법에 관한 휴리스틱 규칙을 강제하지 않는다. 과제에 가장 중요한 지식을 저장하기 위해 _자유 형식 기술_을 사용하며, 기술과 기술 조건부 맥락을 함께 반복적으로 진화시킨다. 구현상 맥락 함수는 정적(skill.md) 구성 요소와 동적(맥락 및 데이터 롤아웃) 구성 요소를 포함하는 전용 디렉터리의 파일 모음으로 인스턴스화된다. 메타 수준과 기저 수준 최적화는 모두 표준 도구 집합을 갖춘 에이전트형 코딩 환경에서 실행된다.
메타 하니스(Lee et al. 2026)는 한 단계 더 깊이 들어간다. 최적화 대상은 어떤 정보를 저장하고, 검색하고, 모델에 제시할지를 결정하고 최적화하는 _코드_다. 이름의 “메타”는 하니스를 최적화하는 하니스라는 뜻이다.
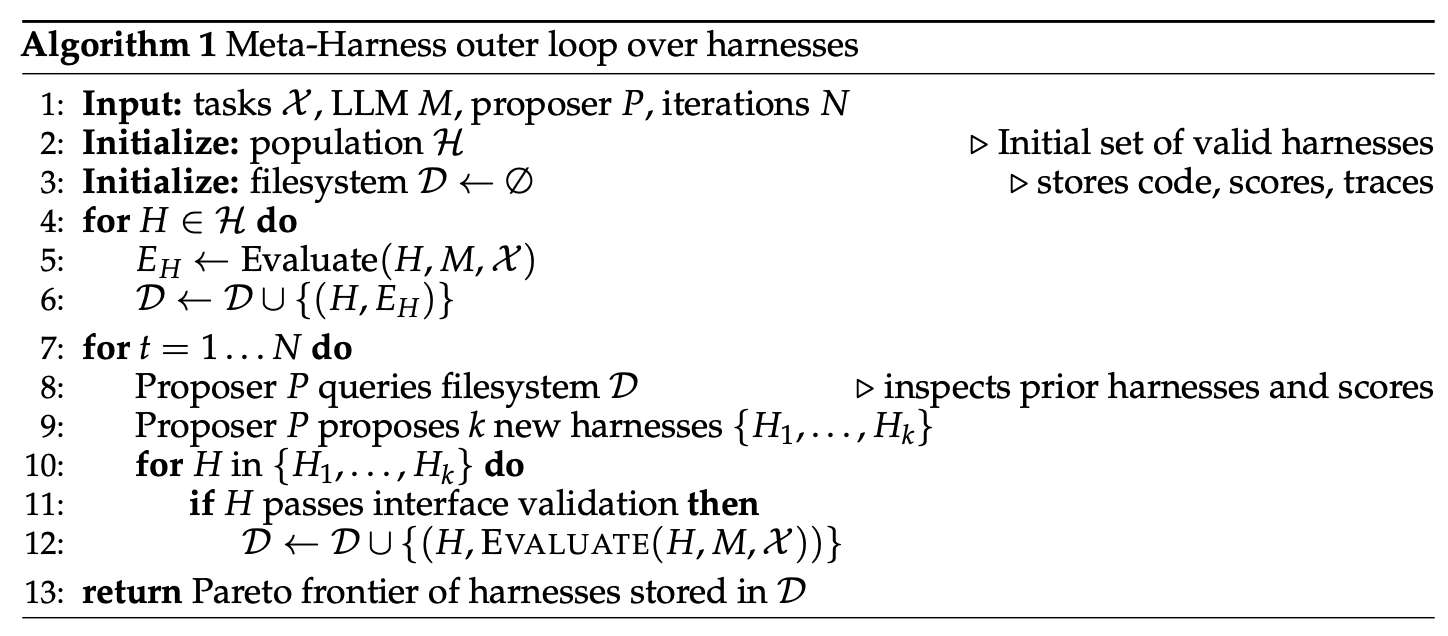
메타 하니스 외부 루프 최적화 알고리즘. (이미지 출처: Lee et al. 2026)
새 하니스를 만드는 제안자 자체가 코딩 에이전트이며, 최종 출력은 파레토 전선 위의 하니스 후보 모음이다.
grep 또는 cat 같은 명령으로 이를 읽는다.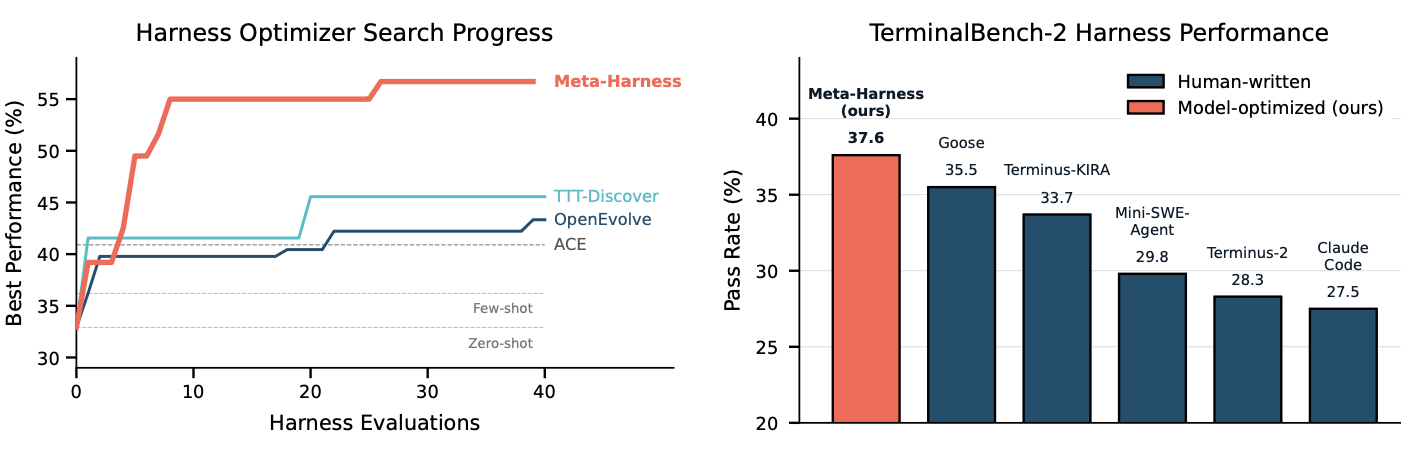
메타 하니스의 성능: (왼쪽) 적은 반복 횟수의 텍스트 분류, (오른쪽) TerminalBench-2. TerminalBench-2 실험의 탐색은 매우 강력한 두 하니스인 Terminus-KIRA와 Terminus-2에서 초기화된다는 점에 유의하라. (이미지 출처: Lee et al. 2026)
여전히 중요한 교훈은 분명하다. 하니스 설계가 실행 가능한 탐색 공간이 되면, 강력한 코딩 에이전트는 인간 엔지니어가 사용하는 동일한 설계 공간을 활용할 수 있다.
하니스 엔지니어링의 워크플로 설계는 분야 전문가가 수작업으로 만들 수 있다. 자동 연구를 예로 들면 다양한 프레임워크가 제안되고 시험되었다. AI Scientist 시스템(Lu et al. 2026)은 연구 아이디어를 제안하고, 코드를 작성하고, 실험을 실행하고, 결과를 분석하고, 원고를 작성하고, 동료 검토를 수행하는 파이프라인을 구축한다. Meng et al. (2026)은 ScientistOne에서 검증 가능성을 중심 설계 제약으로 삼아 모든 주장(인용, 수치, 방법론, 결론)이 증거 출처까지 추적되어야 하며 증거 사슬 점검으로 감사되어야 한다고 한다.
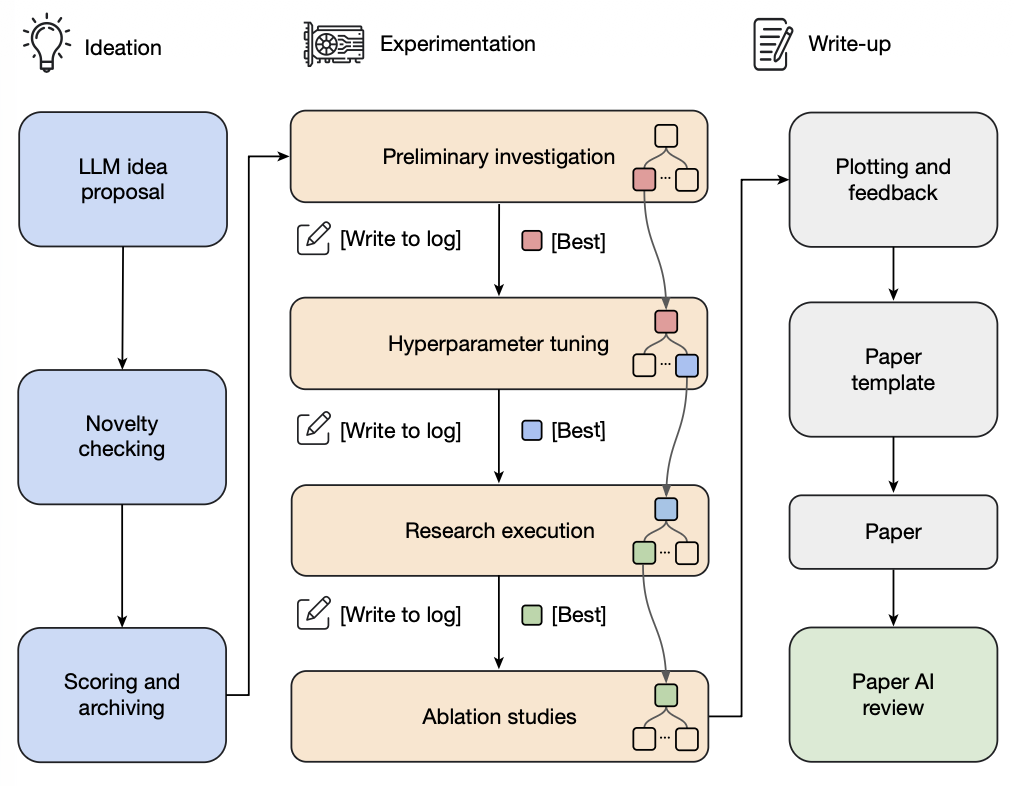
아이디어 생성, 실험, 논문 작성, 검토를 위한 AI Scientist 파이프라인. (이미지 출처: Lu et al. 2026)
Autodata 에이전트(Kulikov et al. 2026)는 훈련 및 평가 데이터를 생성하는 데이터 과학자로 작동하도록 설계되었다. 주 에이전트는 문제를 제안하는 도전자, 약한 해결자, 강한 해결자, _검증자/심판_을 관리하며, 강한 해결자는 성공하지만 약한 해결자는 실패하는 “알맞은” 난이도의 데이터를 합성하는 것을 목표로 한다.
Autodata에서 도전자 프롬프트는 해결자와 검증자의 피드백에 따라 반복적으로 갱신된다. 여기서 한계는 합성된 과제가 약한 해결자의 미세조정에는 사용되지만 강한 해결자에는 사용되지 않는다는 점이다. 루프가 강한 모델을 반복적으로 개선할 수 없다면, 이는 RSI의 색채가 더 옅은 생성된 프롬프트 분포에 대한 간접 증류에 가깝다.
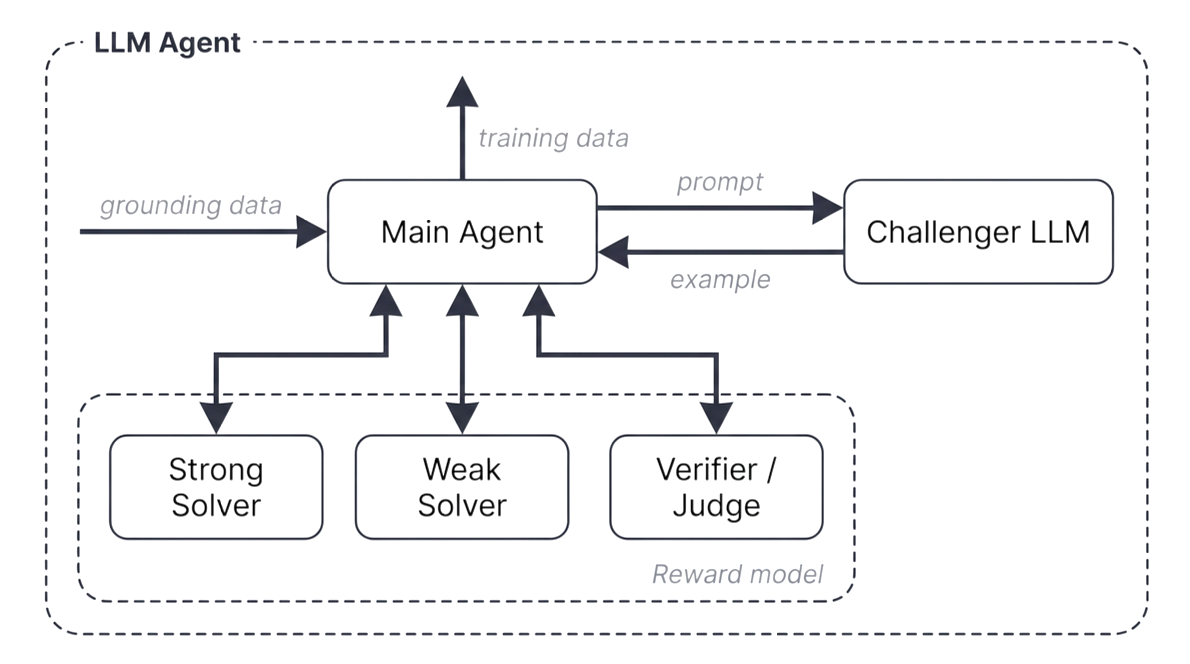
도전자, 해결자, 검증자 역할을 중심으로 합성 훈련 및 평가 데이터를 생성하는 Autodata 에이전트형 워크플로 설계. (이미지 출처: Kulikov et al. 2026)
워크플로의 설계 공간은 거대하며, 자연스럽게 워크플로 설계를 탐색 문제로 생각할 수 있다. 따라서 수작업으로만 만들지 않고 알고리즘으로 좋은 해법을 찾을 수 있어야 한다. 이 방향을 따라 에이전트형 시스템 자동 설계(ADAS; Hu et al. 2025)는 에이전트 설계 자체를 최적화 문제, 즉 메타 에이전트가 에이전트형 워크플로의 새 설계를 제안하는 “메타 에이전트 탐색”으로 정식화한다.
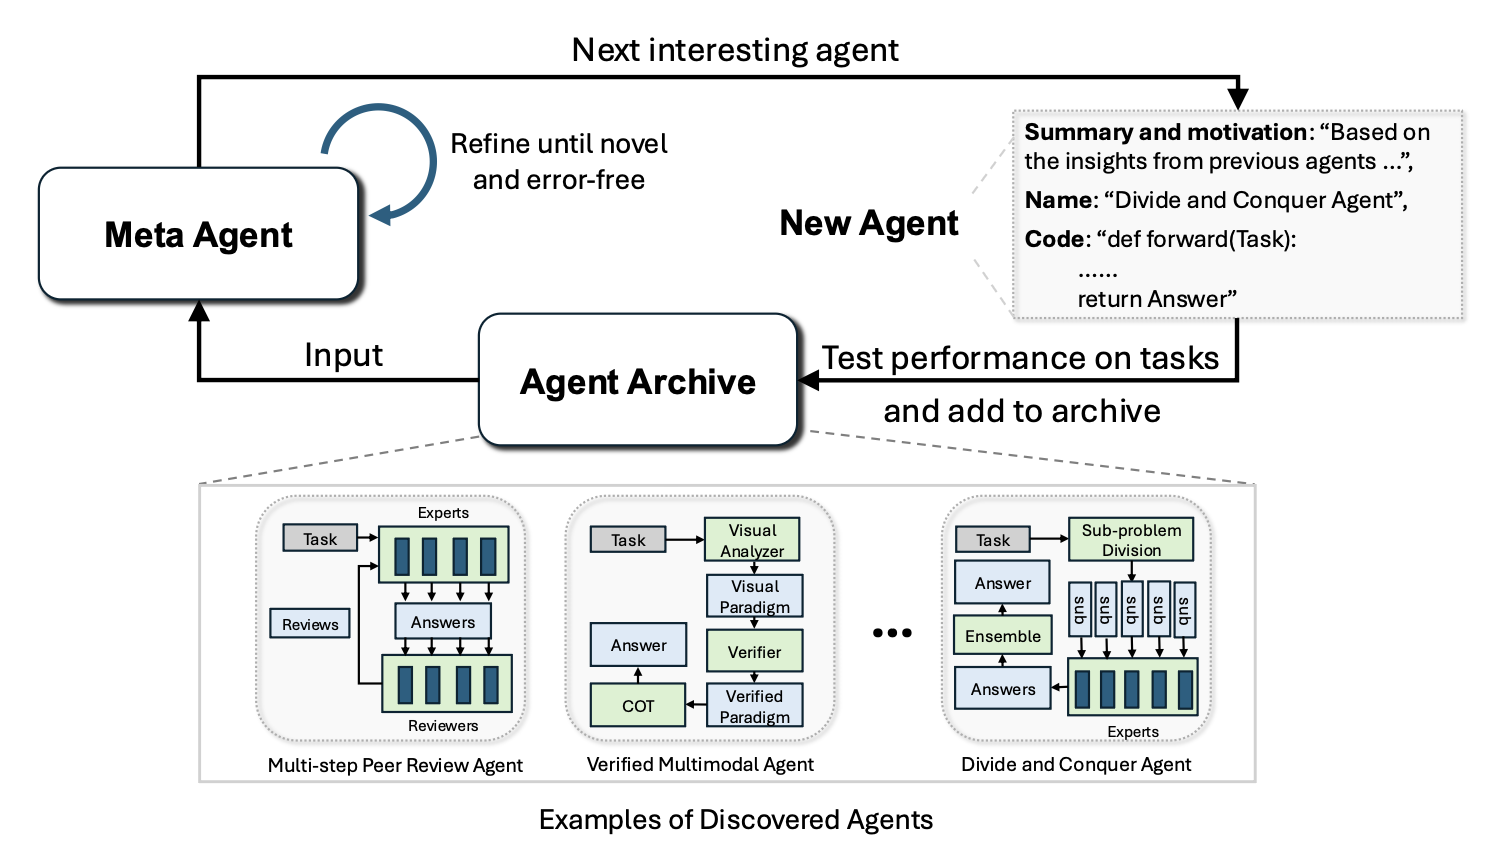
에이전트형 시스템 자동 설계(ADAS)의 예시.
(이미지 출처: Hu et al. 2025)
AFlow(Zhang et al. 2025)는 에이전트형 워크플로를 그래프로 표현한다. 노드는 LLM 호출 행동을 나타내고 간선은 코드로 논리 연산을 구현한다. 워크플로 최적화는 MCTS(몬테카를로 트리 탐색)에 의존한다.
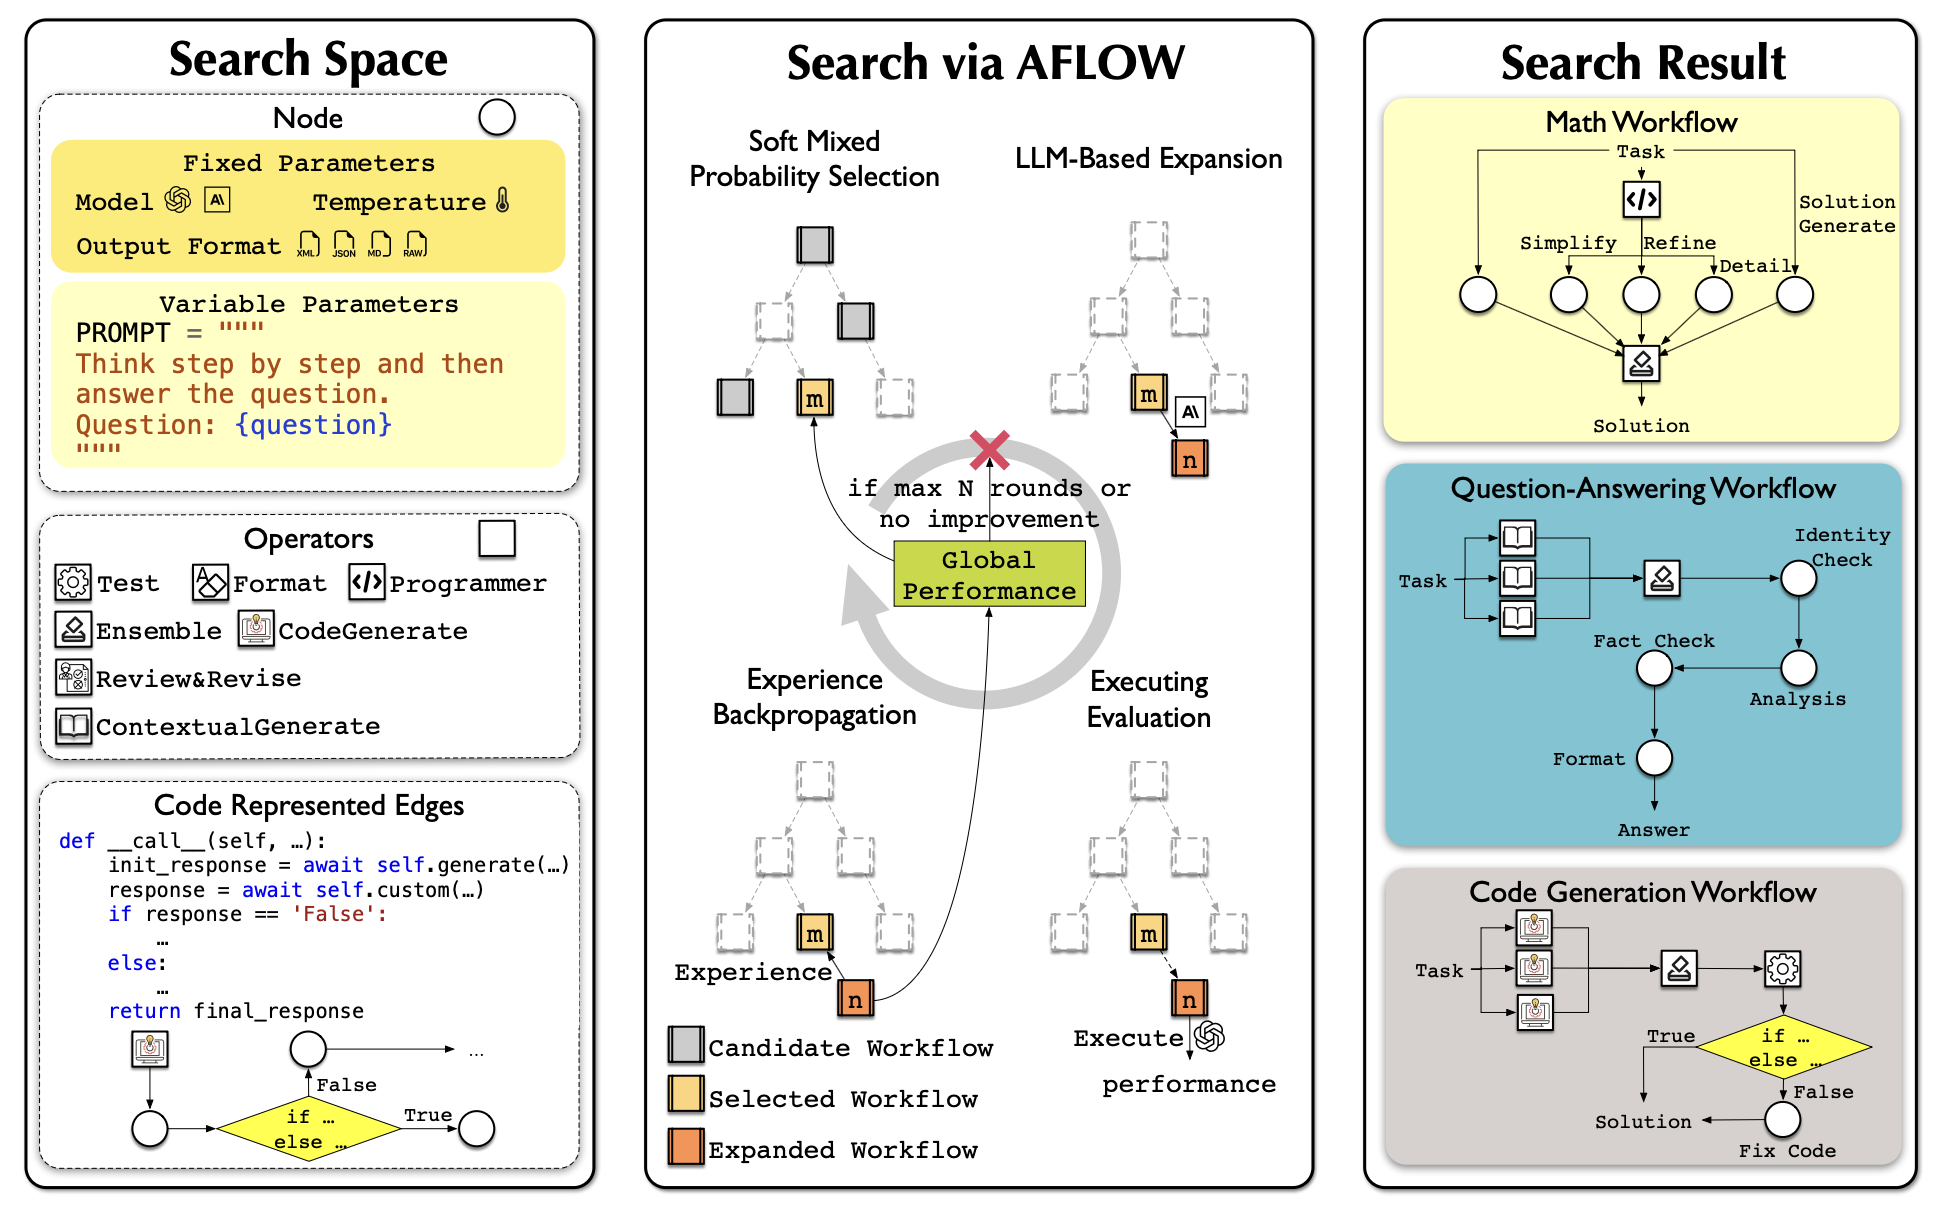
워크플로 후보 트리에 대한 AFlow 최적화 과정. (이미지 출처: Zhang et al. 2025)
질의응답, 코드, 수학 과제에서의 AFlow 실험은 수작업 설계 워크플로와 ADAS보다 꽤 괜찮은 향상을 보였다.
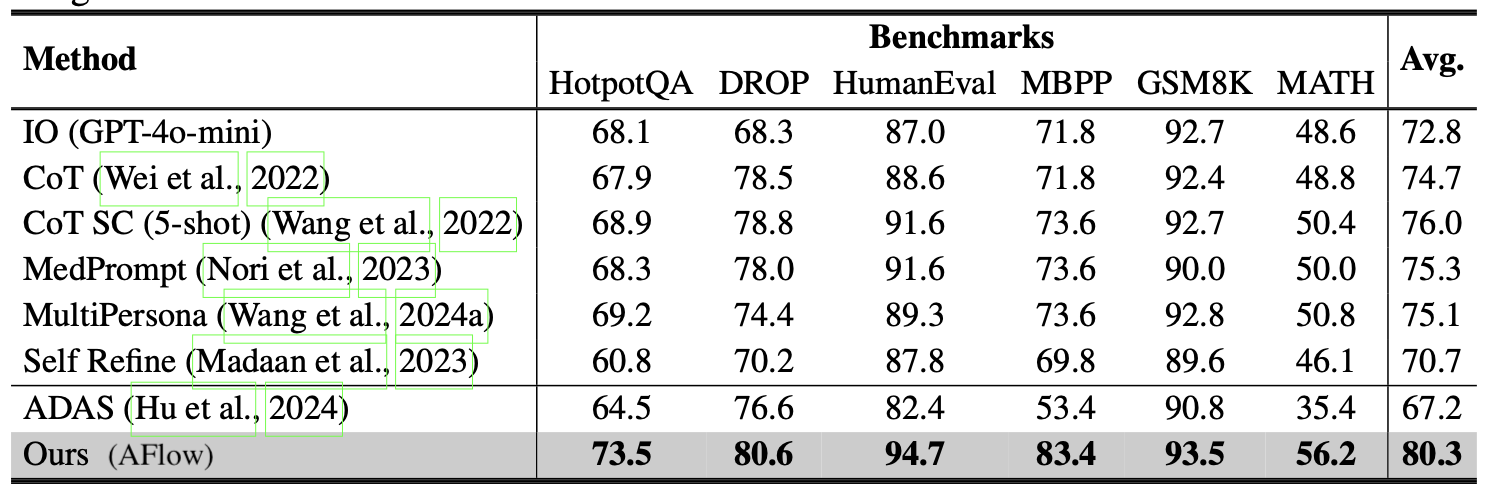
수작업 방법 및 ADAS와 비교한 AFlow 실험. (이미지 출처: Zhang et al. 2025)
맥락 엔지니어링이나 워크플로 설계는 하니스의 한 부분일 뿐이다. 맥락 관리 논리, 워크플로, 권한 및 다른 많은 하니스 구성 요소를 함께 최적화하려면 전체 설계 공간을 탐색해야 한다. Meta-Harness, ADAS, AFlow 같은 연구에서 보았듯 **✨코드✨**는 프로그램과 시스템을 정의하는 보편 언어다. 간단히 말해 하니스는 프롬프트, 도구 호출, 하위 에이전트, 제어 흐름, 메모리, 워크플로 논리가 함께 작동하는 방식을 프로그래밍하는 코드다. LLM이 에이전트를 실행하는 코드를 최적화할 수 있다면 수작업 프롬프트보다 _훨씬 더 큰 설계 공간_에 접근할 수 있다.
자기 학습 최적화기(STOP; Zelikman et al. 2023)는 재귀적 스캐폴딩 개선의 초기 사례 가운데 하나다. STOP의 목표는 직접 개선하는 것이 아니라 _개선기 자체를 개선하는 것_이다.
먼저 메타 효용을 하위 과제 모음에 대한 주어진 개선 함수의 평균 효용으로 정의한다.
개선 함수를 개선하는 것 자체가 최적화 문제이므로, 메타 효용으로 측정한 성능을 바탕으로 자기개선 갱신을 통해 새 버전을 재귀적으로 얻을 수 있다.
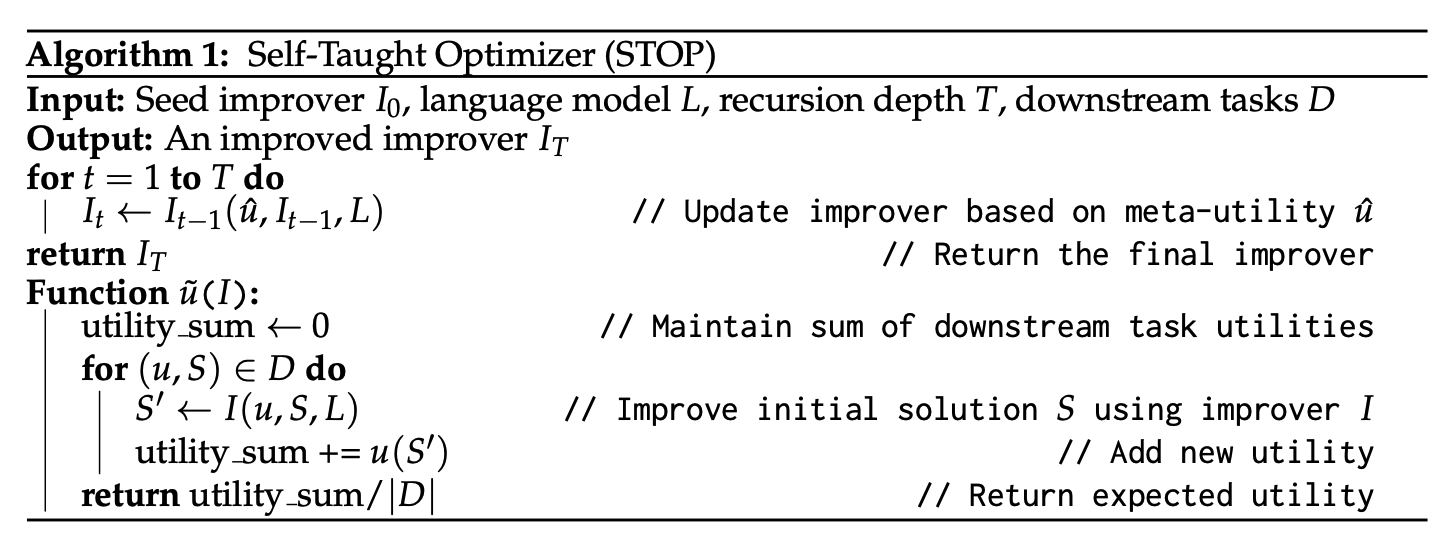
자기 학습 최적화기(STOP)의 알고리즘. (이미지 출처: Zelikman et al. 2023)
실험에서 개선된 개선기는 유전 알고리즘, 부분 분해 및 개선, 다중 무장 프롬프트 밴딧, 모의 담금질, 온도 변화, 빔/트리 탐색 같은 다양한 전략을 발견했다. 이는 하니스 워크플로를 최적화 대상 객체로 표현할 수 있는 방식과 유사하다.
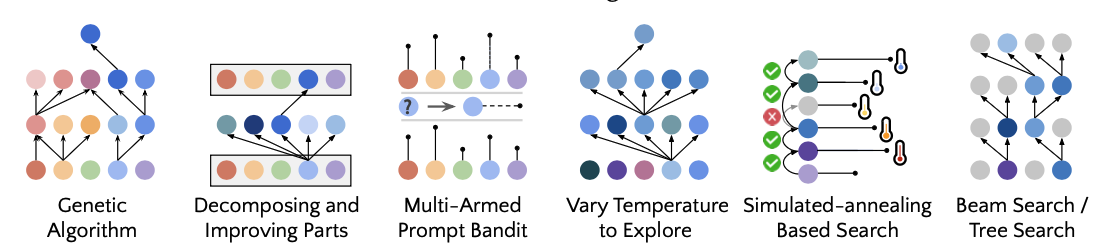
STOP가 발견한 자기개선 전략의 예시. (이미지 출처: Zelikman et al. 2023)
Zelikman et al. (2023)의 발견에서 주의할 결과는 STOP가 GPT-4에서는 반복에 걸쳐 평균 하위 과제 성능을 개선했지만 GPT-3.5와 Mixtral 같은 약한 모델에서는 성능이 저하되었다는 점이다. 재귀 구조만으로는 충분하지 않다. 기반 모델은 메커니즘을 개선할 수 있을 만큼 충분히 유능해야 한다. 이는 하니스 개선이 모델의 더 나은 배포를 가능하게 하지만 지능은 여전히 핵심임을 시사한다.
Lin et al. (2026)은 하니스 진화가 모델 역량에 의존하는 양상을 더 자세히 조사했다. 이들은 두 축을 분리했다. (1) _하니스 갱신_은 유용한 하니스 편집을 만들어 내는 역량이고, (2) _하니스 이득_은 갱신된 하니스를 활용하여 더 나은 과제 해결을 이루는 역량이다. 흥미롭게도 Qwen3.5-9B부터 Claude Opus 4.6까지 크기와 핵심 지능이 다른 여러 모델이 실험에서 유사한 하니스 갱신 역량을 보였다. 9B 하니스 제안자/진화자는 절차적으로 Opus와 동형인 기술을 작성할 수 있었다. 하니스를 최대한 활용하려면 모델은 기술/도구를 정확하고 시의적절하게 호출하고 장기 지평 명령 따르기에 능해야 한다.
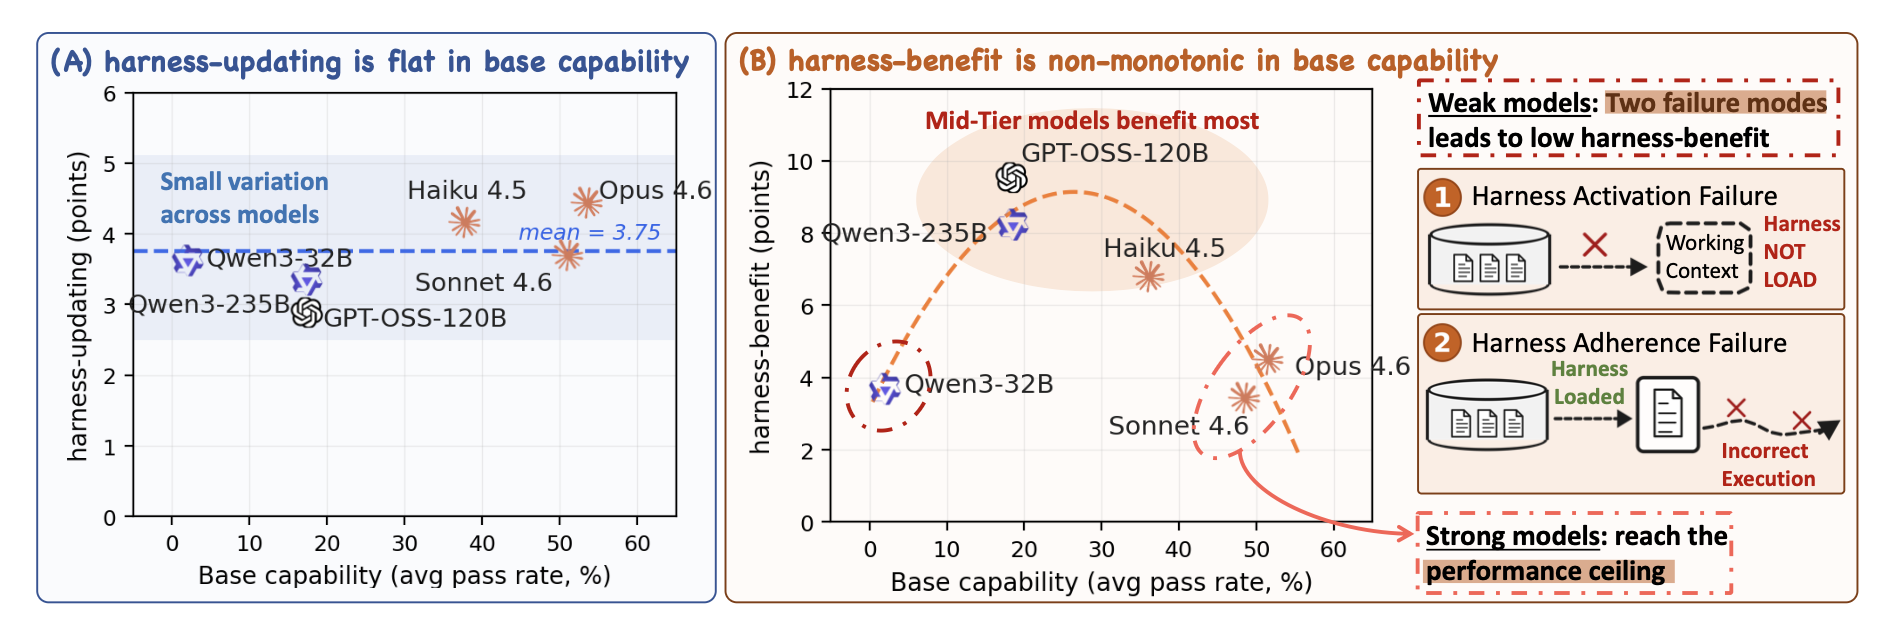
주요 결과: (A) 하니스 갱신 역량은 Qwen2-32B부터 Opus 4.6까지의 모델 범위에서 평탄하게 측정된다. (B) 하니스 이득 역량은 중간급 모델이 가장 큰 이득을 얻는 비단조적 양상을 보인다. (이미지 출처: Lin et al. 2026)
더 최근 연구인 Self-Harness(Zhang et al. 2026)는 LLM 에이전트가 제안-평가-수용 루프를 통해 자신의 하니스를 개선하도록 한다.
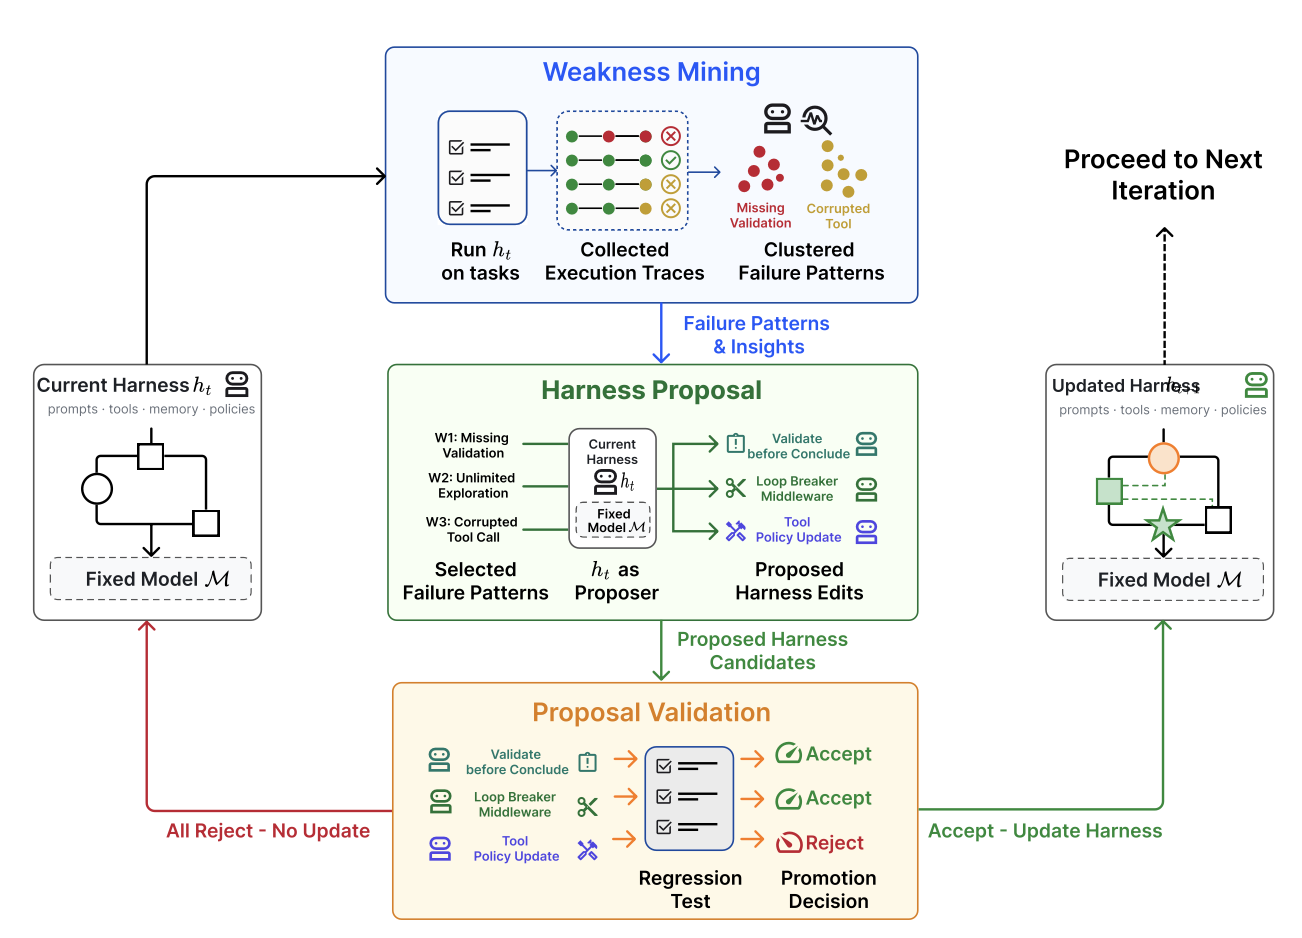
Self-Harness는 약점 탐색, 제한된 하니스 제안, 검증의 루프로 하니스를 갱신한다. (이미지 출처: Zhang et al. 2026)
Self-Harness의 루프는 세 단계로 구성된다.
MiniMax M2.5, Qwen3.5-35B-A3B, GLM-5를 Terminal-Bench-2에서 실행했을 때 Self-Harness는 서로 다른 기반 모델의 서로 다른 약점을 겨냥하는 모델별 하니스 지침을 학습하고 외부 보류 통과율을 높이는 것으로 나타났다.
자기 하니스 유형의 연구는 프로그램이 운영체제 시스템을 편집하도록 허용되면 추상화 경계가 무너진다는 우려를 낳는다. 편집 가능 표면은 적절히 설계되어야 하며 권한 제어와 보안 계층은 이 루프 바깥에 존재해야 한다. 보상 해킹을 둘러싼 모든 과제는 여전히 남아 있다.
에이전트형 하니스 엔지니어링(AHE; Lin et al. 2026)은 하니스 진화의 병목이 관측 가능성에 있다고 본다. 즉 롤아웃이 실패할 때 어떤 구성 요소가 원인인지 알아야 하며, 모든 편집은 증거에 근거해야 한다.
프레임워크는 세 가지 관측 가능성 기둥으로 폐루프를 만든다.
Terminal-Bench-2에서 AHE는 Hard 등급을 제외하고 인간 설계 하니스(OpenCode, Terminus-2, Codex) 및 일부 자기진화 기준선(ACE, TF-GRPO)보다 더 나은 성능을 달성했다. 추가 진화 없이 동일한 동결 하니스가 SWE-bench-verified로 전이되며, 진화한 하니스가 벤치마크 특화 최적화가 아니라 하니스 구성 요소에 엔지니어링 경험을 인코딩할 수 있음을 보여 준다.
진화적 탐색은 자연 선택에서 영감을 받은 최적화 방법이다(진화 알고리즘에 관한 내 오래된 글 참조). 해법 개체군을 변이시키고 그중 “적합도”가 높은 것만 남겨 진화시킨다. 진화적 탐색은 (1) 탐색 공간이 광범위하거나 기이한 형태이고, (2) 그래디언트로 직접 최적화하기는 어렵지만 해법을 평가하기는 쉬울 때 유용하다. 하니스 탐색은 여기에 잘 맞는 듯하다.
과거 연구에서는 프롬프트 엔지니어링에 진화적 탐색이 사용되었다. Promptbreeder(Fernando et al. 2023)는 풍부한 변이 연산 집합으로 과제별 프롬프트를 최적화하며, 흥미롭게도 변이 프롬프트 자체도 진화를 통해 개선된다. GEPA(Agrawal et al. 2025)는 성찰 기반 프롬프팅과 진화적 탐색을 결합하고 시행착오 궤적에 대한 자연어 성찰로 프롬프트 갱신을 제안한다.
Novikov et al. (2025)는 후보 프로그램 풀을 저장하고 동결된 LLM에 개선을 위한 차이를 생성하도록 요청하는 코딩 에이전트 진화 탐색 시스템 AlphaEvolve를 도입했다. 시스템이 자식 프로그램을 반복적으로 평가하고 성공한 것을 보존하면서 시간이 지나 더 나은 해법을 발견한다.
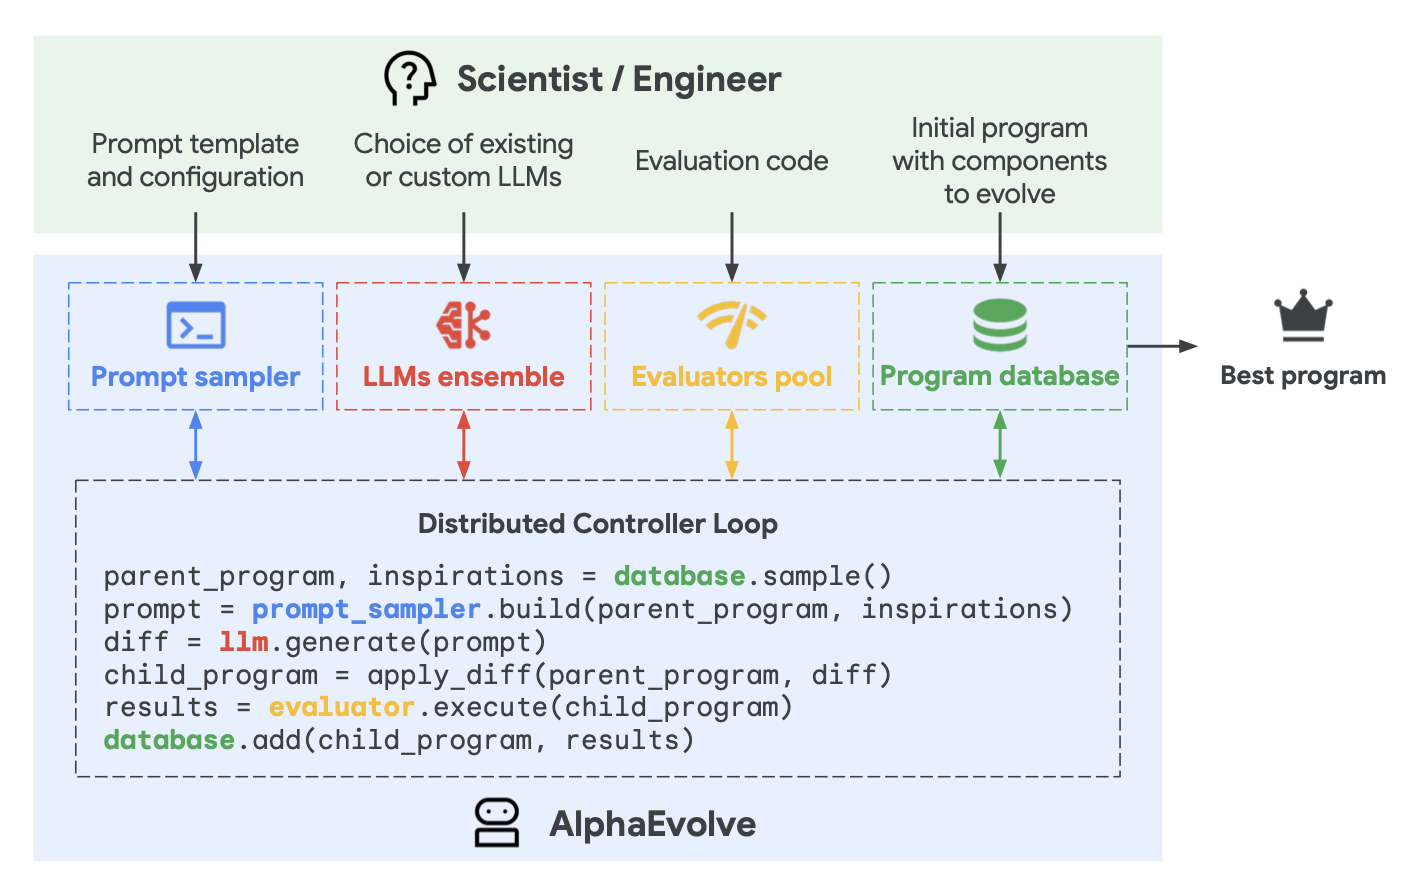
AlphaEvolve의 작동 방식. (이미지 출처: Novikov et al. 2025)
AlphaEvolve 설계에서는 몇 가지 세부 사항이 중요하다.
# EVOLVE-BLOCK-START와 # EVOLVE-BLOCK-END로 명시적으로 표시된다.절제 연구는 진화 절차, 프롬프트의 맥락, 메타 프롬프트, 전체 파일 진화, 더 강한 LLM 사용의 가치를 보여 준다.
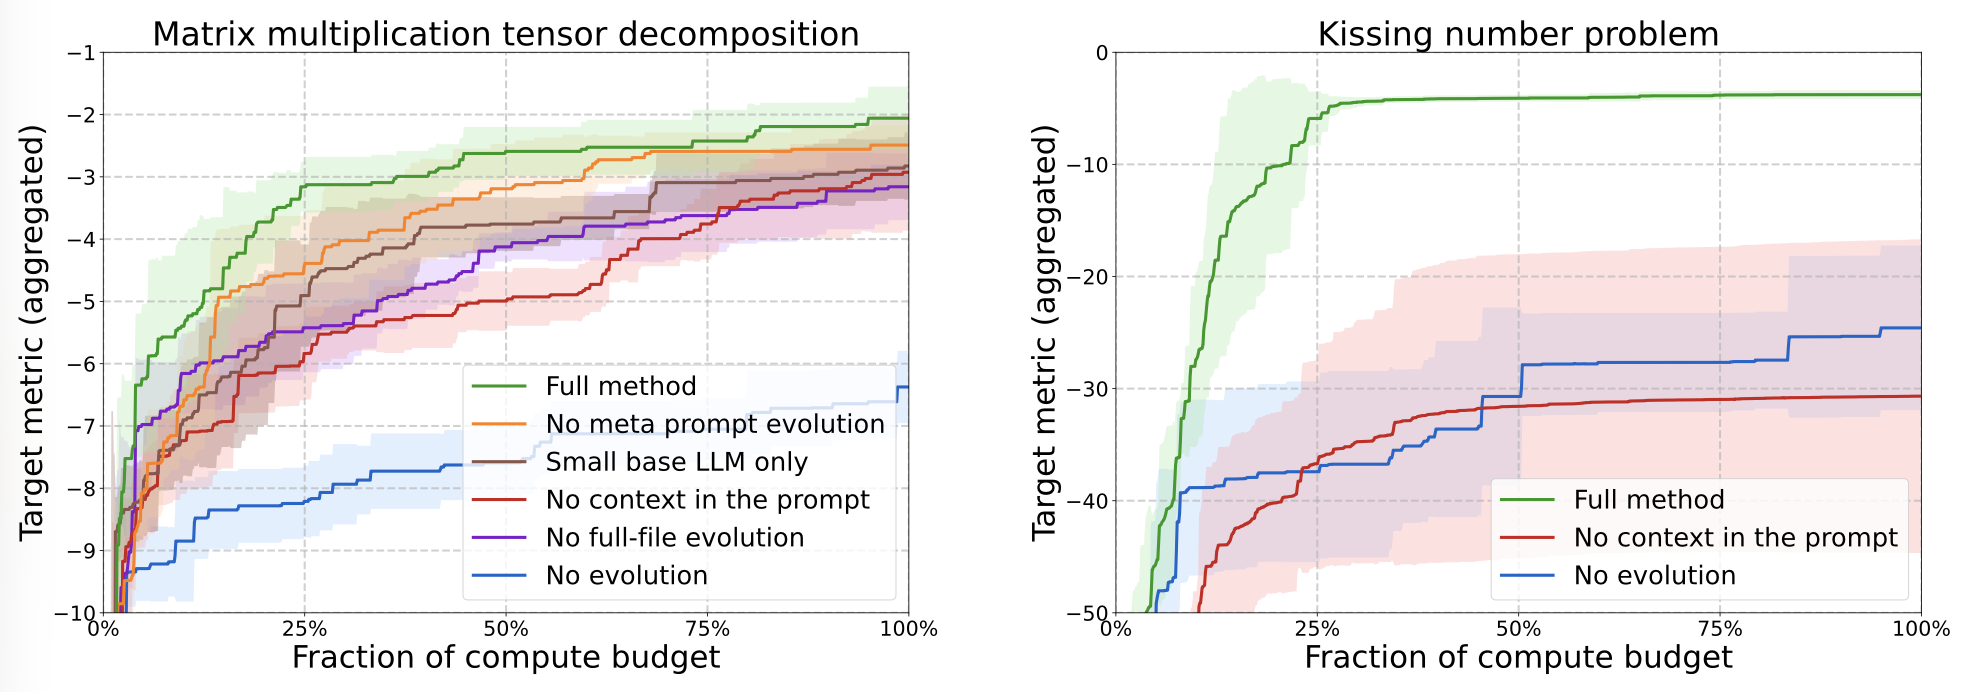
절제 연구는 AlphaEvolve의 여러 설계가 지닌 가치를 보여 준다. (이미지 출처: Novikov et al. 2025)
ThetaEvolve(Wang et al. 2025) 같은 최근 변형은 진화적 탐색을 강화학습 및 문맥 내 학습과 결합하며, DemoEvolve(Che, et al. 2026)는 하니스 수준 진단과 편집을 위한 참조 경험으로 인간 전문가 시연을 자기 롤아웃 아카이브에 추가한다. 한편 ShinkaEvolve(Lange et al. 2025)는 LLM 표본 효율을 높이기 위해 세 가지 새 구성 요소를 도입했다.
해법 개선에 초점을 둔 위 방법들과 달리, Darwin Gödel Machine(DGM; Zhang et al. 2025)은 LLM 기반 코딩 에이전트로 편집 가능한 하니스 코드 저장소의 진화를 명시적으로 목표로 한다. 정확히 말해 이 에이전트는 자신의 하니스를 수정할 수 있다. Hyperagents에 관한 후속 연구(Zhang et al. 2026)는 새 에이전트를 만들기 위해 기존 과제 에이전트를 수정하는 방식을 제어하는 메타 에이전트를 도입했다.
<bash_command>), (2) 편집기(인수: view/create/edit <file_path>).DGM은 고정된 모델 아래의 하니스 진화다. Claude 3.5 Sonnet을 기반 LLM으로, 단순한 초기 하니스 구성으로 한 실험에서 DGM이 발견한 에이전트는 SWE-bench Verified에서 수작업 에이전트와 비슷하거나 이를 능가했고(20%에서 50%), Polyglot에서도 그랬다(14.2%에서 30.7%).
이 방법군은 행렬 곱셈, GPU 커널 최적화, 알고리즘 경연, 데이터센터 일정 관리처럼 후보 해법을 자동 평가할 수 있고 후보 적합도를 쉽게 정량화할 수 있을 때 잘 작동한다. 평가는 느리거나, 모호하거나, 주로 휴리스틱 기반인 영역에서는 어려움을 겪는다. 진화의 계산 효율과 효과성도 우려 사항이다.
하니스 진화는 모델 주변의 비매개변수 시스템을 바꾼다. 완전한 자기개선을 가능하게 하려면 모델이 동시에 자신의 가중치를 갱신하도록 완전히 허용할 수 있다. 가중치 갱신은 모델 훈련 파이프라인 개선이나 시험 시점 지속 학습을 통해 구현될 수 있다. 지속 학습이라는 주제는 나중에 별도의 글로 다룰 가치가 있다.
SIA(Hebbar et al. 2026)는 동일한 최적화 루프에서 하니스 개선과 모델 매개변수 갱신을 결합하려는 초기 시도로, 설계에 세 구성 요소를 둔다.
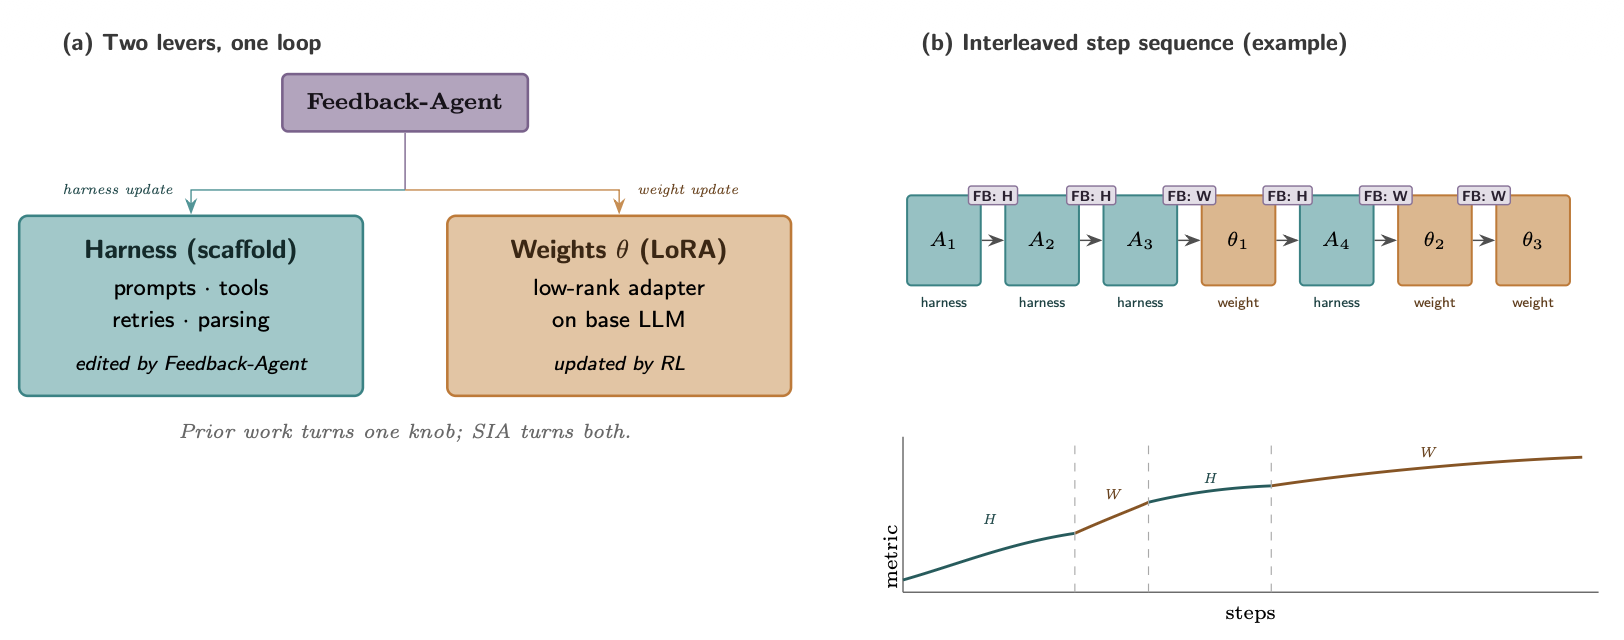
SIA의 피드백 에이전트는 다음 반복 유형을 결정한다. (이미지 출처: Hebbar et al. 2026)
SIA 실험에는 결과를 해석하기 어렵게 만드는 몇 가지 교란 선택이 있다. 예를 들어 과제별 에이전트는 메타 에이전트와 피드백 에이전트에 사용된 모델보다 훨씬 약하며(gpt-oss-120b 대 Claude Sonnet 4.6), 기준선도 관련 방법과 명확히 교차 검증하기에는 너무 약하다. 이 방향은 흥미롭다고 보지만 증거는 잠정적이다. 훈련 안정성이나 굿하트 효과 같은 많은 과제도 여전히 열려 있다.
Continual Harness(Karten et al. 2026)는 장기 지평 게임플레이 환경에서 하니스 갱신과, 낮은 보상 궤적에서 강한 교사 모델의 레이블을 증류하여 정책 모델을 공동 학습하는 방식을 실험했다.
AI Scientist 계열 연구는 전문가가 설계한 하니스가 연구 논문 작성이라는 형태로 실험된 자동 연구 루프의 큰 부분을 조율할 수 있음을 강력하게 보여 준다. 그러나 논문 생산은 과학적 발견과 동일하지 않다. 시스템은 그럴듯한 원고를 쓸 수 있지만 날조된 인용, 구현 이탈, 약한 실험 결과를 여전히 가질 수 있다.
Trehan & Chopra (2026)는 LLM이 최소한의 스캐폴딩과 기본 도구(read_file, write_file, llm_search, list_files)로 연구 아이디어에서 논문까지 갈 수 있는지 시험했다. 각 아이디어에는 에이전트가 맥락의 일부로 문서를 생성하고 읽을 수 있는 전용 작업 공간이 있었다. 세 분야(세계 모델, 다중 에이전트 강화학습, AI 안전성 및 정렬)에서 실험했으며, 각 분야에는 새 아이디어에 영감을 줄 45~50개의 고품질 시드 문서가 있었다. 인간 전문가가 전체 파이프라인을 통과시킬 아이디어는 네 개만 선택했고, 그중 논문으로 완전히 실행된 것은 하나뿐이었다. 실험에서 다음 여섯 가지 반복적 실패 양상을 관찰했다.
완전한 RSI를 향해 연구자들은 실제 진전을 이루었지만, 여러 병목이 남아 있다.
1. 약하고 모호한 평가자. 많은 연구 주장은 빠르고 정확한 검증자가 없으며, 많은 현실 세계 과제도 마찬가지다. 현재의 자기개선 루프는 강화학습의 작동 방식과 비슷하게 평가 지표가 측정 가능하고 객관적인 과제에서 가장 잘 작동한다.
연구 안목, 새로움, 장기 과학적 가치는 측정하기 훨씬 어렵다. 예를 들어 연구 안목은 흔히 문제 구성, 실험 설계, 어떤 놀라운 결과를 추구할 가치가 있는지와 어떤 실패 사례를 재시도할 가치가 있는지에 대한 판단을 섞는다.
2. 맥락과 메모리 수명 주기. AI 에이전트가 더 자율적이고 독립적이 됨에 따라 메모리는 늘어난다. 유용한 하니스는 장기 지평 과제의 성공을 최대화하면서 장문맥 생성의 기존 한계를 보완하도록 맥락과 메모리를 관리해야 한다. 인간이 평생 동안 메모리를 유지할 수 있으므로, 맥락 엔지니어링은 소프트웨어 시스템 계층에 머무르지 않고 지능의 핵심 부분이 될 것이며 되어야 한다는 유비를 본다.
3. 부정적 결과. 연구자는 성공적인 결과를 출판할 유인을 가지므로 문헌은 성공 쪽으로 편향된다. 방대한 데이터로 훈련된 LLM은 적어도 지금은 대부분 인간이 만든 데이터이므로, 데이터에서 성공 사례와 실패 사례의 불균형 때문에 언제 가설을 포기하고, 부정적 결과를 보고하며, 실패를 인정해야 하는지 판단하는 데 서툴 수 있다. 실패에서 배우는 일은 과제 탐색 공간을 줄이는 최선의 방법이므로, 연구 하니스는 실패한 시도를 쉽게 보존할 수 있어야 한다.
4. 다양성 붕괴. 진화 및 강화학습 루프는 알려진 고보상 패턴을 활용하는 경향이 있다. 개체군이 동일한 해법의 변형으로 붕괴하지 않도록 메커니즘이 필요하다. 이는 특히 개방형 연구에서 중요하며, 최선의 경로가 처음에는 현재 평가자 아래에서 더 나빠 보일 수 있다.
5. 보상 해킹. 자기개선 루프는 주어진 신호가 무엇이든 최적화한다. 보상이 단위 시험에서 오면 에이전트는 시험에 과적합할 수 있다. 심판 모델에서 오면 해당 심판에 특화된 보상 해킹 요령을 학습할 수 있다. 벤치마크 점수에서 오면 벤치마크 인공물을 악용할 수 있다.
평가자와 권한 제어는 하니스를 진화시키는 루프 바깥에 있어야 할 가능성이 크며, 보류 시험, 추적 감사, 중요한 결정 지점의 인간 검토가 필요하다. 감독을 얼마나 확장하고 자동화할 수 있는지는 열린 연구 영역으로 남아 있다.
6. 장기 성공. 외재적 최적화 루프는 훈련 샌드박스에서 시뮬레이션할 수 있는 개별 롤아웃 외부의 보상에 작동한다.
코딩 에이전트를 예로 들면, 코딩 에이전트는 이미 소프트웨어 엔지니어링의 일상 생산성을 높였지만 많은 최적화 목표는 여전히 너무 단기적이다. 당면 과제를 완료하는 경우가 많지만, 수백 또는 수천 명의 엔지니어가 공동 유지하는 저장소의 장기 건전성을 어떻게 보호해야 하는지는 덜 명확하다. 표준 샌드박스 기반 RLVR 스타일 훈련은 유지보수성, 소유권 경계, 마이그레이션 비용, 하위 호환성, 미래 디버깅 부담을 거의 포착하지 못한다.
7. 인간의 역할. 인간은 루프에서 제거되는 대신 스택 위로 올라가야 한다. 즉 인간은 올바른 시점과 올바른 추상화 수준에서 감독을 제공해야 하며, 시스템 설계는 그러한 접점을 언제 어떻게 설정할지 고려해야 한다.
위에 열거한 많은 과제에는 인간의 피드백과 조정이 필요하다. 결국 우리는 다른 방향이 아니라 인류의 더 나은 미래를 위한 기술을 만들고 있다.
이 글을 다음과 같이 인용해 달라.
Weng, Lilian. “Harness Engineering for Self-Improvement”. Lil’Log (Jul 2026). https://lilianweng.github.io/posts/2026-07-04-harness/
또는 다음 BibTeX 인용을 사용하라.
@article{weng2026harness,
  title = {Harness Engineering for Self-Improvement},
  author = {Weng, Lilian},
  journal = {lilianweng.github.io},
  year = {2026},
  month = {July},
  url = "https://lilianweng.github.io/posts/2026-07-04-harness/"
}
PaperBench: 논문 기여 이해, 코드베이스 개발, 실험의 성공적 실행을 포함해 20편의 ICML 2024 Spotlight 및 Oral 논문을 처음부터 재현한다.
Claude 3.5 Sonnet, 약 21%)은 ML 박사보다 뛰어나지 못한다.CORE-Bench: 출판된 연구의 계산적 재현성을 평가한다.
GPT-4o 및 GPT-4o-mini)는 가장 어려운 과제에서 정확도 21%에 그쳤다.ScienceAgentBench: 데이터 주도 과학 발견을 위한 LLM 에이전트를 평가한다.
RE-Bench: 현실적인 ML 연구 엔지니어링 환경에서 최전선 AI 에이전트를 인간 전문가와 비교 평가한다.
MLE-bench: 오프라인 Kaggle 대회에서 ML 엔지니어링 에이전트를 평가한다.
o1-preview는 대회의 16.9%에서 최소 Kaggle 동메달 수준에 도달했다.KernelBench: 생성된 GPU 커널의 정확성과 속도를 평가한다.
[1] Good, I. J. “최초의 초지능 기계에 관한 추측.” Advances in Computers, 6:31–88, 1965.
[2] Yudkowsky, Eliezer. “재귀적 자기개선.” LessWrong, 2008.
[3] Choi, et al. “코드 수리를 위한 앵커링된 자기대전.” ICML 2026.
[4] Zhao, et al. “절대 영: 데이터 없는 강화 자기대전 추론.” arXiv 사전출판 arXiv:2505.03335, 2025.
[5] Yuan, et al. “자기 보상 언어 모델.” arXiv 사전출판 arXiv:2401.10020, 2024.
[6] Chen, et al. “자기대전 미세조정은 약한 언어 모델을 강한 언어 모델로 바꾼다.” ICML 2024.
[7] Zhang, et al. “에이전트형 맥락 엔지니어링: 자기개선 언어 모델을 위한 진화하는 맥락.” ICLR 2026.
[8] Ye, et al. “에이전트형 기술 진화를 통한 메타 맥락 엔지니어링.” arXiv 사전출판 arXiv:2601.21557, 2026.
[9] Lee, et al. “메타 하니스: 모델 하니스의 종단 간 최적화.” arXiv 사전출판 arXiv:2603.28052, 2026.
[10] Lu, et al. “AI 연구의 종단 간 자동화를 향하여.” Nature, 651:914–919, 2026.
[11] Meng, et al. “ScientistOne: 증거 사슬을 통한 인간 수준 자율 연구를 향하여.” arXiv 사전출판 arXiv:2605.26340, 2026.
[12] Kulikov, et al. “Autodata: 고품질 합성 데이터를 만드는 에이전트형 데이터 과학자.” arXiv 사전출판 arXiv:2606.25996, 2026.
[13] Hu, Lu, and Clune. “에이전트형 시스템 자동 설계.” ICLR 2025.
[14] Madaan, et al. “Self-Refine: 자기 피드백을 통한 반복 정제.” NeurIPS 2023.
[15] Zhang, et al. “AFlow: 에이전트형 워크플로 생성 자동화.” ICLR 2025.
[16] Zelikman, et al. “자기 학습 최적화기(STOP): 재귀적으로 자기개선하는 코드 생성.” COLM 2024.
[17] Zhang, et al. “Self-Harness: 스스로를 개선하는 하니스.” arXiv 사전출판 arXiv:2606.09498, 2026.
[18] Fernando, et al. “Promptbreeder: 프롬프트 진화를 통한 자기참조적 자기개선.” arXiv 사전출판 arXiv:2309.16797, 2023.
[19] Agrawal, A. et al. “GEPA: 성찰적 프롬프트 진화는 강화학습을 능가할 수 있다.” arXiv 사전출판 arXiv:2507.19457, 2025.
[20] Novikov, et al. “AlphaEvolve: 과학적 및 알고리즘적 발견을 위한 코딩 에이전트.” arXiv 사전출판 arXiv:2506.13131, 2025.
[21] Lange, Imajuku, and Cetin. “ShinkaEvolve: 개방형 및 표본 효율적 프로그램 진화를 향하여.” arXiv 사전출판 arXiv:2509.19349, 2025.
[22] Wang, et al. “ThetaEvolve: 개방 문제에서의 시험 시점 학습.” arXiv 사전출판 arXiv:2511.23473, 2025.
[23] Zhang, et al. “Darwin Gödel Machine: 자기개선 에이전트의 개방형 진화.” arXiv 사전출판 arXiv:2505.22954, 2025.
[24] Zhang, et al. “Hyperagents.” arXiv 사전출판 arXiv:2603.19461, 2026.
[25] Yuksekgonul, et al. “시험 시점에 발견을 학습하기.” arXiv 사전출판 arXiv:2601.16175, 2026.
[26] Riaz, et al. “시험 시점 발견을 위한 인식론적 불확실성.” arXiv 사전출판 arXiv:2605.11328, 2026.
[27] Hebbar, et al. “SIA: 하니스 및 가중치 갱신을 통한 자기개선 AI.” arXiv 사전출판 arXiv:2605.27276, 2026.
[28] Trehan and Chopra. “LLM은 왜 아직 과학자가 아닌가: 네 차례의 자율 연구 시도에서 얻은 교훈.” arXiv 사전출판 arXiv:2601.03315, 2026.
[29] Bubeck, et al. “GPT-5를 활용한 초기 과학 가속 실험.” arXiv 사전출판 arXiv:2511.16072, 2025.
[30] Starace, et al. “PaperBench: AI 연구를 재현하는 AI의 능력 평가.” ICML 2025.
[31] Wijk, et al. “RE-Bench: 인간 전문가에 맞선 언어 모델 에이전트의 최전선 AI 연구개발 역량 평가.” ICML 2025.
[32] Chan, et al. “MLE-bench: 기계학습 엔지니어링에서 기계학습 에이전트 평가.” arXiv 사전출판 arXiv:2410.07095, 2024.
[33] Chen, et al. “ScienceAgentBench: 데이터 주도 과학 발견을 위한 언어 에이전트의 엄밀한 평가를 향하여.” ICLR 2025.
[34] Siegel, et al. “CORE-Bench: 계산적 재현성 에이전트 벤치마크를 통한 출판 연구의 신뢰성 증진.” TMLR 2024.
[35] Ouyang, et al. “KernelBench: LLM은 효율적인 GPU 커널을 작성할 수 있는가?” arXiv 사전출판 arXiv:2502.10517, 2025.
[36] Lin, et al. “하니스 갱신은 하니스 이득이 아니다: 자기진화 LLM 에이전트에서 진화 역량 분리.” arXiv 사전출판 arXiv:2605.30621, 2026.
[37] Lin, et al. “에이전트형 하니스 엔지니어링: 관측 가능성 주도 코딩 에이전트 하니스의 자동 진화.” arXiv 사전출판 arXiv:2604.25850, 2026.
[38] Karten, et al. “Continual Harness: 자기개선 기반 에이전트를 위한 온라인 적응.” arXiv 사전출판 arXiv:2605.09998, 2026.
[39] Che, et al. “DemoEvolve: 시연으로 에이전트형 하니스 진화의 희소 피드백 극복.” arXiv 사전출판 arXiv:2605.24539, 2026.
