의존성 없는 순수 Python 200줄짜리 단일 파일로 GPT를 학습하고 추론하는 microgpt의 구성 요소와 원리를 안내합니다.
이 글은 의존성 없이 순수 Python 200줄로 작성된 단일 파일 microgpt라는 새 아트 프로젝트를 간략히 안내합니다. 이 파일은 GPT를 학습하고 추론합니다. 문서 데이터셋, 토크나이저, 자동미분 엔진, GPT-2와 유사한 신경망 아키텍처, Adam 옵티마이저, 학습 루프, 추론 루프까지 필요한 알고리즘적 내용을 모두 담고 있습니다. 그 밖의 모든 것은 효율성에 관한 것입니다. 이보다 더 단순하게 만들 수는 없습니다. 이 스크립트는 여러 프로젝트(micrograd, makemore, nanogpt 등)와 LLM을 가장 본질적인 요소로 단순화하려는 10년간의 집착이 맺은 결과이며, 아름답다고 생각합니다 🥹. 심지어 3개 열로도 완벽하게 나뉩니다:
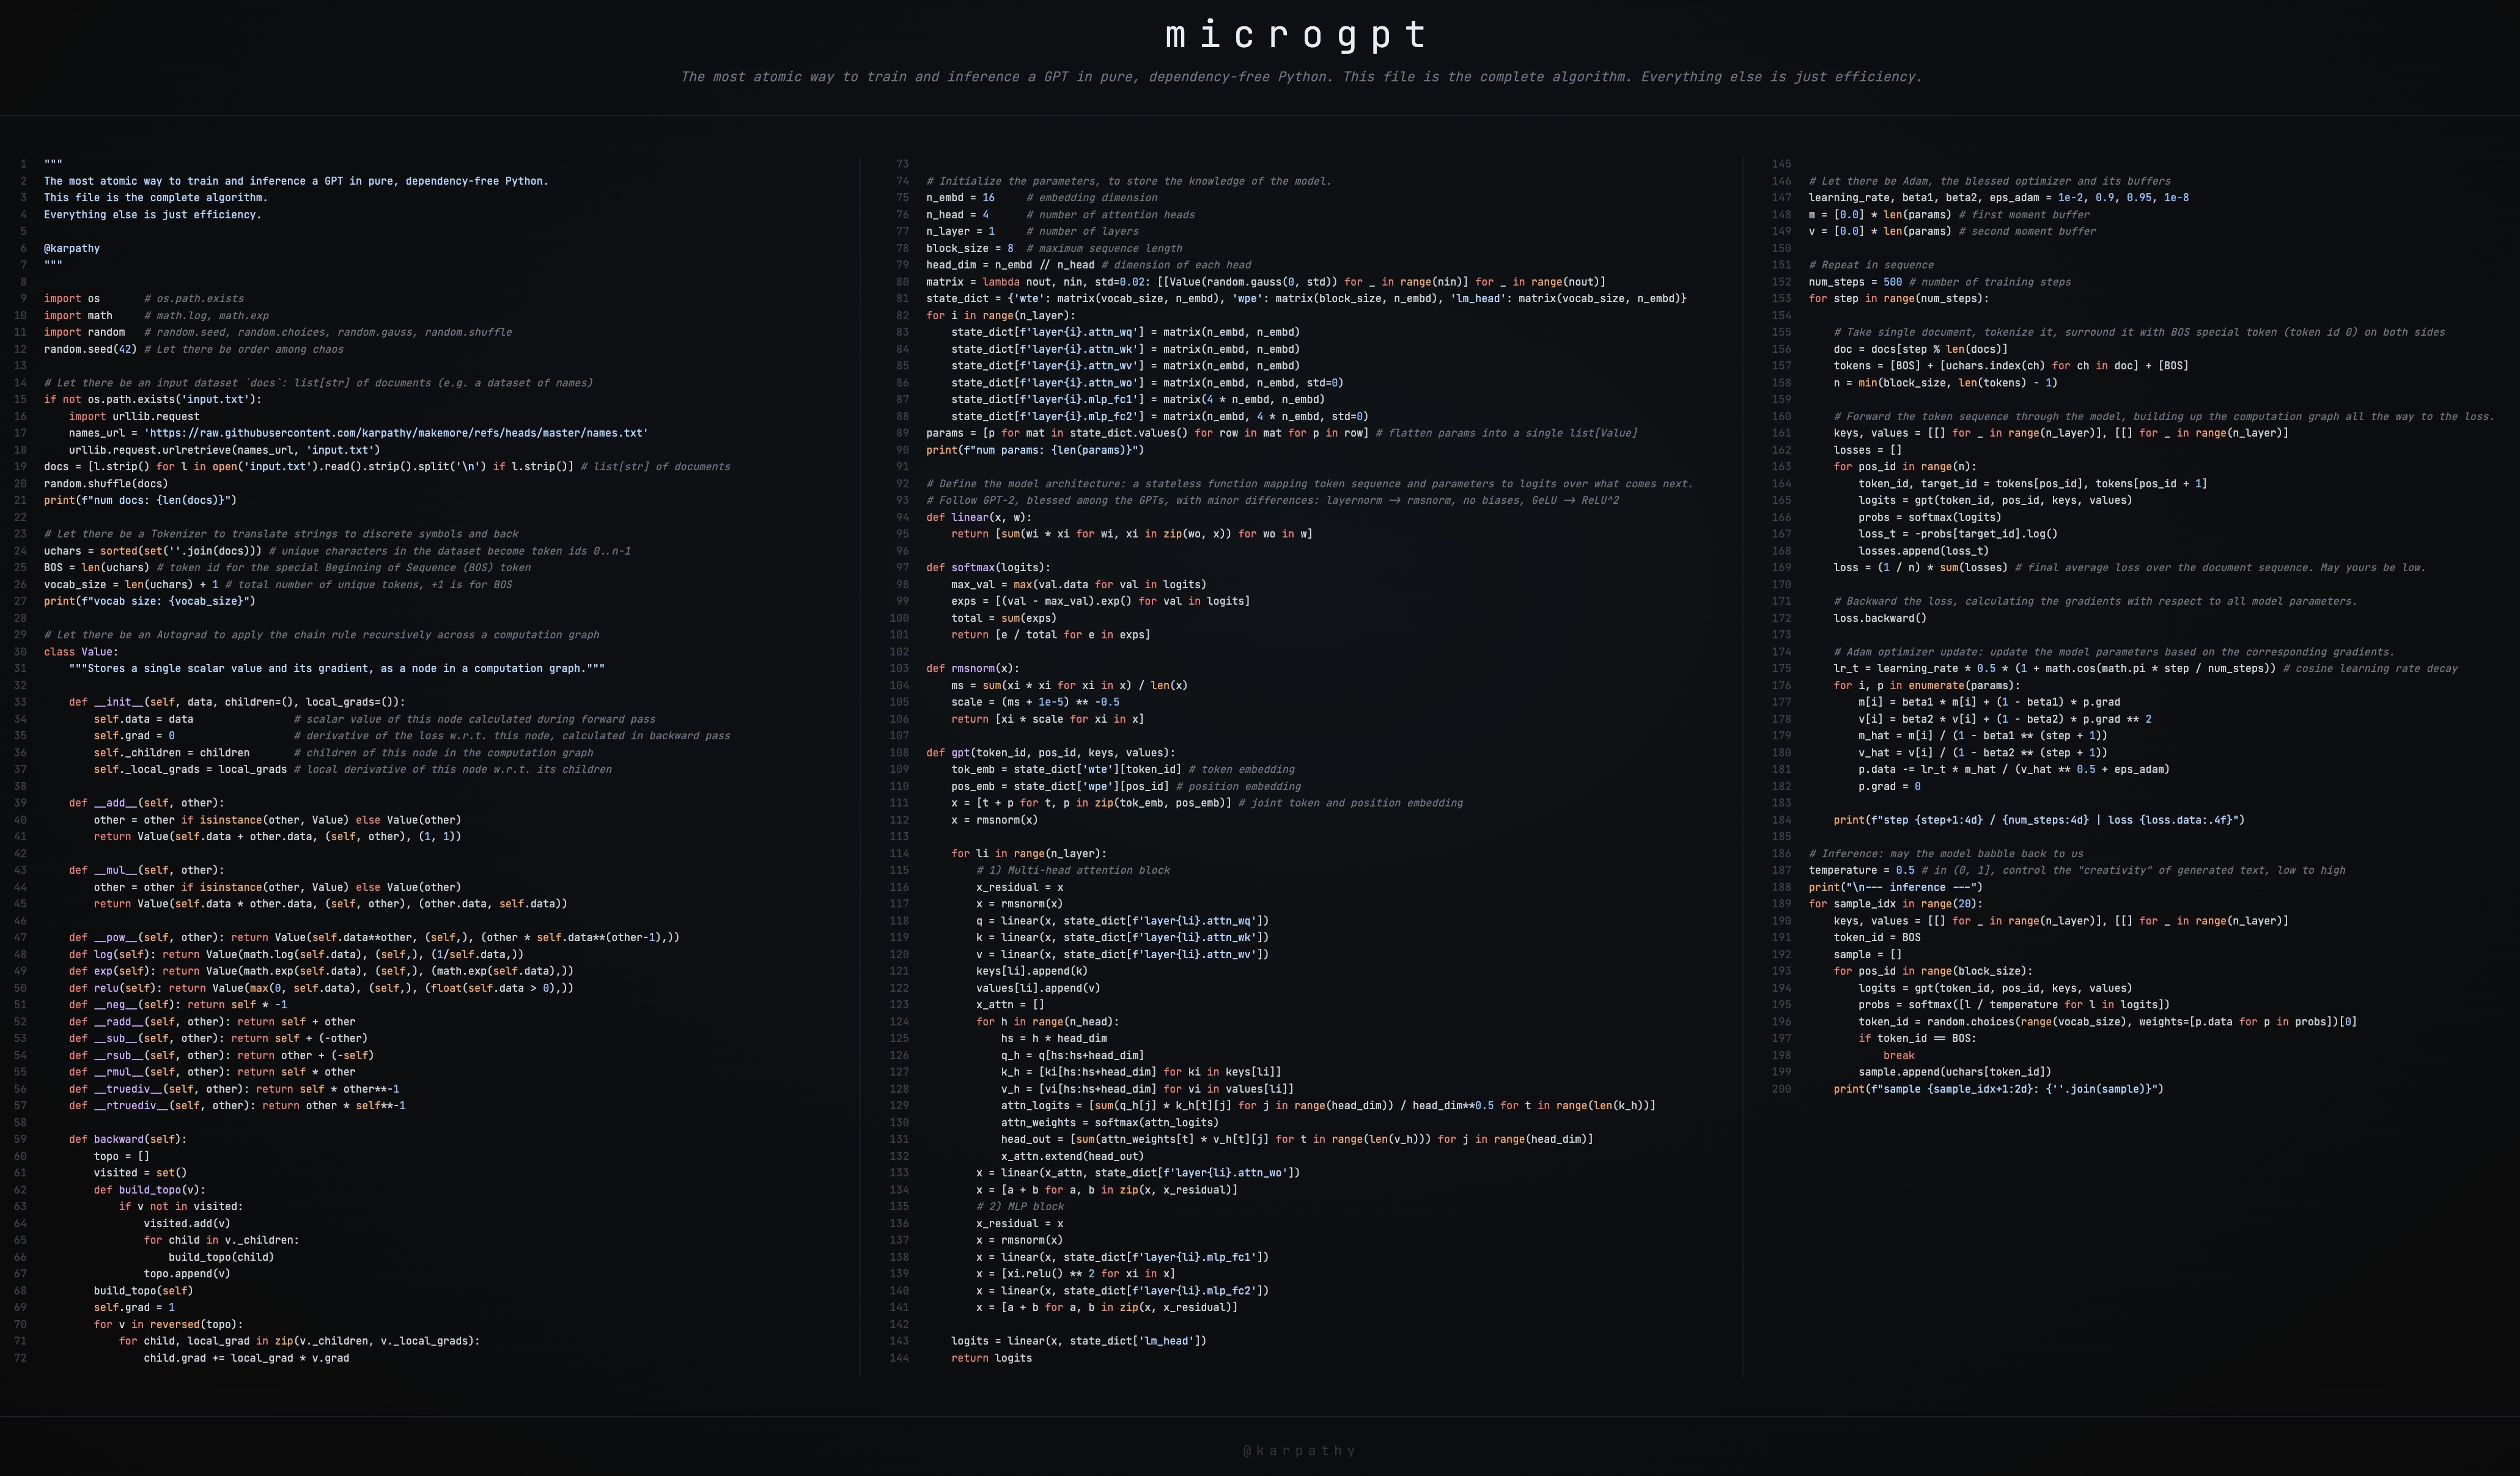
찾을 수 있는 곳:
아래는 관심 있는 독자가 코드를 단계별로 따라갈 수 있도록 만든 안내입니다.
대규모 언어 모델의 연료는 텍스트 데이터의 흐름이며, 선택적으로 여러 문서로 구분됩니다. 실제 서비스급 애플리케이션에서는 각 문서가 인터넷 웹 페이지가 되겠지만, microgpt에서는 한 줄에 하나씩 있는 이름 32,000개라는 더 단순한 예를 사용합니다:
# Let there be an input dataset `docs`: list[str] of documents (e.g. a dataset of names)
if not os.path.exists('input.txt'):
    import urllib.request
    names_url = 'https://raw.githubusercontent.com/karpathy/makemore/refs/heads/master/names.txt'
    urllib.request.urlretrieve(names_url, 'input.txt')
docs = [l.strip() for l in open('input.txt').read().strip().split('\n') if l.strip()] # list[str] of documents
random.shuffle(docs)
print(f"num docs: {len(docs)}")
데이터셋은 다음과 같습니다. 각 이름이 하나의 문서입니다:
emma
olivia
ava
isabella
sophia
charlotte
mia
amelia
harper
... (~32,000 names follow)
모델의 목표는 데이터의 패턴을 학습하고, 그 안의 통계적 패턴을 공유하는 비슷한 새 문서를 생성하는 것입니다. 미리 보면, 스크립트 마지막에는 모델이 그럴듯하게 들리는 새 이름을 생성(“환각”!)합니다. 앞부분을 건너뛰면 다음을 얻습니다:
sample  1: kamon
sample  2: ann
sample  3: karai
sample  4: jaire
sample  5: vialan
sample  6: karia
sample  7: yeran
sample  8: anna
sample  9: areli
sample 10: kaina
sample 11: konna
sample 12: keylen
sample 13: liole
sample 14: alerin
sample 15: earan
sample 16: lenne
sample 17: kana
sample 18: lara
sample 19: alela
sample 20: anton
대단해 보이지 않을 수도 있지만, ChatGPT 같은 모델의 관점에서 여러분과의 대화는 그저 조금 재미있게 생긴 “문서”일 뿐입니다. 프롬프트로 문서를 시작하면, 모델의 응답은 그 관점에서 단지 통계적 문서 완성입니다.
내부적으로 신경망은 문자가 아니라 숫자를 다루므로, 텍스트를 정수 토큰 식별자 시퀀스로 변환하고 되돌리는 방법이 필요합니다. GPT-4가 사용하는 tiktoken 같은 실제 토크나이저는 효율성을 위해 문자 조각 단위로 동작하지만, 가능한 가장 단순한 토크나이저는 데이터셋의 각 고유 문자에 정수 하나를 할당합니다:
# Let there be a Tokenizer to translate strings to discrete symbols and back
uchars = sorted(set(''.join(docs))) # unique characters in the dataset become token ids 0..n-1
BOS = len(uchars) # token id for the special Beginning of Sequence (BOS) token
vocab_size = len(uchars) + 1 # total number of unique tokens, +1 is for BOS
print(f"vocab size: {vocab_size}")
위 코드에서는 데이터셋 전체의 고유 문자를 모으고(여기서는 소문자 a-z 전체), 정렬한 뒤 각 문자는 인덱스로 식별자를 받습니다. 정수값 자체에는 전혀 의미가 없다는 점에 유의하세요. 각 토큰은 그저 별개의 이산 기호입니다. 0, 1, 2 대신 서로 다른 이모지가 와도 마찬가지입니다. 또한 구분자 역할을 하는 BOS(시퀀스 시작)라는 특수 토큰을 하나 더 만듭니다. 이는 모델에 “여기서 새 문서가 시작하거나 끝난다”라고 알려 줍니다. 이후 학습 중 각 문서는 양쪽이 BOS로 감싸집니다: [BOS, e, m, m, a, BOS]. 모델은 BOS가 새 이름을 시작하고, 또 다른 BOS가 이름을 끝낸다는 것을 학습합니다. 따라서 최종 어휘는 27개입니다(가능한 소문자 a-z 26개와 BOS 토큰 1개).
신경망 학습에는 기울기가 필요합니다. 모델의 각 파라미터에 대해 “이 숫자를 조금 올리면 손실이 오르는가, 내려가는가, 그리고 얼마나 변하는가?”를 알아야 합니다. 계산 그래프에는 많은 입력(모델 파라미터와 입력 토큰)이 있지만, 하나의 스칼라 출력인 손실로 모입니다(손실이 정확히 무엇인지 아래에서 정의합니다). 역전파는 이 단일 출력에서 시작해 그래프를 거꾸로 따라가며 모든 입력에 대한 손실의 기울기를 계산합니다. 이는 미적분의 연쇄 법칙에 의존합니다. 실제 환경에서는 PyTorch 같은 라이브러리가 이를 자동으로 처리합니다. 여기서는 Value라는 단일 클래스에서 처음부터 구현합니다:
class Value:
    __slots__ = ('data', 'grad', '_children', '_local_grads')

    def __init__(self, data, children=(), local_grads=()):
        self.data = data                # scalar value of this node calculated during forward pass
        self.grad = 0                   # derivative of the loss w.r.t. this node, calculated in backward pass
        self._children = children       # children of this node in the computation graph
        self._local_grads = local_grads # local derivative of this node w.r.t. its children

    def __add__(self, other):
        other = other if isinstance(other, Value) else Value(other)
        return Value(self.data + other.data, (self, other), (1, 1))

    def __mul__(self, other):
        other = other if isinstance(other, Value) else Value(other)
        return Value(self.data * other.data, (self, other), (other.data, self.data))

    def __pow__(self, other): return Value(self.data**other, (self,), (other * self.data**(other-1),))
    def log(self): return Value(math.log(self.data), (self,), (1/self.data,))
    def exp(self): return Value(math.exp(self.data), (self,), (math.exp(self.data),))
    def relu(self): return Value(max(0, self.data), (self,), (float(self.data > 0),))
    def __neg__(self): return self * -1
    def __radd__(self, other): return self + other
    def __sub__(self, other): return self + (-other)
    def __rsub__(self, other): return other + (-self)
    def __rmul__(self, other): return self * other
    def __truediv__(self, other): return self * other**-1
    def __rtruediv__(self, other): return other * self**-1

    def backward(self):
        topo = []
        visited = set()
        def build_topo(v):
            if v not in visited:
                visited.add(v)
                for child in v._children:
                    build_topo(child)
                topo.append(v)
        build_topo(self)
        self.grad = 1
        for v in reversed(topo):
            for child, local_grad in zip(v._children, v._local_grads):
                child.grad += local_grad * v.grad
이 부분이 수학적으로나 알고리즘적으로 가장 복잡하다는 점을 알고 있으며, 이를 다룬 2.5시간짜리 영상이 있습니다: micrograd 영상. 간단히 말하면, Value는 하나의 스칼라 숫자(.data)를 감싸고 그 값이 어떻게 계산되었는지 추적합니다. 각 연산을 작은 레고 블록으로 생각하세요. 입력을 받아 출력(순전파)을 만들고, 각 입력에 대해 출력이 어떻게 변하는지(국소 기울기)를 알고 있습니다. 이것이 각 블록에서 자동미분이 필요로 하는 모든 정보입니다. 나머지는 블록들을 잇는 연쇄 법칙일 뿐입니다.
Value 객체로 수학 연산(덧셈, 곱셈 등)을 할 때마다 결과는 입력(_children)과 해당 연산의 국소 도함수(_local_grads)를 기억하는 새 Value가 됩니다. 예를 들어 __mul__은 ∂(a⋅b)∂a=b와 ∂(a⋅b)∂b=a를 기록합니다. 레고 블록 전체는 다음과 같습니다:
| 연산 | 순전파 | 국소 기울기 |
|---|---|---|
a + b | a+b | ∂∂a=1,∂∂b=1 |
a * b | a⋅b | ∂∂a=b,∂∂b=a |
a ** n | a n | ∂∂a=n⋅a n−1 |
log(a) | ln(a) | ∂∂a=1 a |
exp(a) | e a | ∂∂a=e a |
relu(a) | max(0,a) | ∂∂a=1 a>0 |
backward() 메서드는 그래프를 역위상 순서로(손실에서 시작해 파라미터에서 끝나도록) 순회하며, 각 단계에서 연쇄 법칙을 적용합니다. 손실이 L이고 노드 v에 국소 기울기 ∂v∂c를 갖는 자식 c가 있다면 다음과 같습니다:
∂L∂c+=∂v∂c⋅∂L∂v 이 미적분에 익숙하지 않다면 조금 무섭게 보일 수 있지만, 직관적으로는 문자 그대로 두 숫자를 곱하는 것뿐입니다. 다음처럼 볼 수 있습니다. “자동차가 자전거보다 두 배 빠르고, 자전거가 걷는 사람보다 네 배 빠르다면, 자동차는 사람보다 2 x 4 = 8배 빠르다.” 연쇄 법칙도 같은 생각입니다. 경로를 따라 변화율을 곱합니다.
손실 노드에서 self.grad = 1로 시작합니다. ∂L∂L=1이기 때문입니다. 손실이 자신에 대해 변하는 비율은 자명하게 1입니다. 이후에는 연쇄 법칙이 파라미터로 돌아가는 모든 경로를 따라 국소 기울기를 곱합니다.
+=에 유의하세요(대입이 아니라 누적입니다). 하나의 값이 그래프 내 여러 장소에서 사용되면(즉, 그래프가 분기되면), 기울기는 각 분기를 따라 독립적으로 되돌아오며 합쳐져야 합니다. 이는 다변수 연쇄 법칙의 결과입니다. c가 여러 경로를 통해 L에 기여한다면, 전체 도함수는 각 경로의 기여를 합한 값입니다.
backward()가 완료된 후 그래프의 모든 Value에는 ∂L∂v를 담은 .grad가 있으며, 이는 그 값을 조금 움직일 경우 최종 손실이 어떻게 변하는지 알려 줍니다.
구체적인 예를 보겠습니다. a는 두 번 사용되므로(그래프가 분기되므로) 그 기울기는 두 경로의 합입니다:
a = Value(2.0)
b = Value(3.0)
c = a * b       # c = 6.0
L = c + a       # L = 8.0
L.backward()
print(a.grad)   # 4.0 (dL/da = b + 1 = 3 + 1, via both paths)
print(b.grad)   # 2.0 (dL/db = a = 2)
이는 PyTorch의 .backward()가 제공하는 결과와 정확히 같습니다:
import torch
a = torch.tensor(2.0, requires_grad=True)
b = torch.tensor(3.0, requires_grad=True)
c = a * b
L = c + a
L.backward()
print(a.grad)   # tensor(4.)
print(b.grad)   # tensor(2.)
이는 PyTorch의 loss.backward()가 실행하는 것과 같은 알고리즘입니다. 텐서(스칼라 배열)가 아니라 스칼라에서 실행할 뿐입니다. 알고리즘적으로 동일하지만 훨씬 작고 단순하며, 물론 훨씬 덜 효율적입니다.
위의 .backward()가 무엇을 주는지 풀어 보겠습니다. 자동미분은 L = a*b + a, a=2, b=3일 때 a.grad = 4.0이 a가 L에 미치는 국소적 영향을 알려 준다고 계산했습니다. 입력 a를 조금 움직이면 L은 어느 방향으로 변할까요? 여기서 L의 a에 대한 도함수는 4.0입니다. 즉 a를 아주 조금(가령 0.001) 증가시키면 L은 그 약 4배(0.004) 증가합니다. 마찬가지로 b.grad = 2.0은 b에 같은 변화를 주면 L이 약 2배(0.002) 증가한다는 뜻입니다. 다시 말해 이 기울기는 각 개별 입력이 최종 출력(손실)에 미치는 영향의 방향(부호에 따라 양 또는 음)과 가파름(크기)을 알려 줍니다. 이로써 신경망 파라미터를 반복적으로 움직여 손실을 낮추고 예측을 개선할 수 있습니다.
파라미터는 모델의 지식입니다. 자동미분을 위해 Value로 감싼 부동소수점 숫자의 큰 모음으로, 무작위로 시작해 학습 중 반복적으로 최적화됩니다. 각 파라미터의 정확한 역할은 아래에서 모델 아키텍처를 정의하면 더 명확해지지만, 지금은 초기화만 하면 됩니다:
n_embd = 16     # embedding dimension
n_head = 4      # number of attention heads
n_layer = 1     # number of layers
block_size = 16 # maximum sequence length
head_dim = n_embd // n_head # dimension of each head
matrix = lambda nout, nin, std=0.08: [[Value(random.gauss(0, std)) for _ in range(nin)] for _ in range(nout)]
state_dict = {'wte': matrix(vocab_size, n_embd), 'wpe': matrix(block_size, n_embd), 'lm_head': matrix(vocab_size, n_embd)}
for i in range(n_layer):
    state_dict[f'layer{i}.attn_wq'] = matrix(n_embd, n_embd)
    state_dict[f'layer{i}.attn_wk'] = matrix(n_embd, n_embd)
    state_dict[f'layer{i}.attn_wv'] = matrix(n_embd, n_embd)
    state_dict[f'layer{i}.attn_wo'] = matrix(n_embd, n_embd)
    state_dict[f'layer{i}.mlp_fc1'] = matrix(4 * n_embd, n_embd)
    state_dict[f'layer{i}.mlp_fc2'] = matrix(n_embd, 4 * n_embd)
params = [p for mat in state_dict.values() for row in mat for p in row]
print(f"num params: {len(params)}")
각 파라미터는 가우스 분포에서 뽑은 작은 무작위 수로 초기화됩니다. state_dict는 이를 이름이 붙은 행렬, 즉 임베딩 테이블, 어텐션 가중치, MLP 가중치, 최종 출력 사영으로 구성합니다(PyTorch의 용어를 빌렸습니다). 또한 옵티마이저가 나중에 순회할 수 있도록 모든 파라미터를 단일 목록 params로 평탄화합니다. 이 작은 모델의 파라미터 수는 4,192개입니다. GPT-2는 16억 개였고, 현대 LLM은 수천억 개를 가집니다.
모델 아키텍처는 상태 없는 함수입니다. 토큰, 위치, 파라미터, 이전 위치의 캐시된 키와 값을 받아 시퀀스에서 다음에 올 토큰이 무엇이어야 한다고 모델이 생각하는지에 대한 로짓(점수)을 반환합니다. 작은 단순화를 적용해 GPT-2를 따릅니다. LayerNorm 대신 RMSNorm, 편향 없음, GeLU 대신 ReLU를 사용합니다. 먼저 작은 보조 함수 세 개입니다:
def linear(x, w):
    return [sum(wi * xi for wi, xi in zip(wo, x)) for wo in w]
linear는 행렬-벡터 곱입니다. 벡터 x와 가중치 행렬 w를 받아 w의 각 행마다 점곱 하나를 계산합니다. 이것이 신경망의 근본 구성 요소인 학습된 선형 변환입니다.
def softmax(logits):
    max_val = max(val.data for val in logits)
    exps = [(val - max_val).exp() for val in logits]
    total = sum(exps)
    return [e / total for e in exps]
softmax는 −∞에서 +∞까지 범위를 가질 수 있는 원시 점수(로짓) 벡터를 확률 분포로 변환합니다. 모든 값은 [0,1] 범위가 되고 합은 1입니다. 수치적 안정성을 위해 먼저 최댓값을 뺍니다(수학적으로 결과는 바뀌지 않지만 exp의 오버플로를 방지합니다).
def rmsnorm(x):
    ms = sum(xi * xi for xi in x) / len(x)
    scale = (ms + 1e-5) ** -0.5
    return [xi * scale for xi in x]
rmsnorm(제곱평균제곱근 정규화)은 값이 단위 제곱평균제곱근을 갖도록 벡터의 크기를 재조정합니다. 이는 활성값이 네트워크를 통과하며 커지거나 작아지는 것을 막아 학습을 안정화합니다. 원래 GPT-2에 쓰인 LayerNorm의 더 단순한 변형입니다.
이제 모델 자체입니다:
def gpt(token_id, pos_id, keys, values):
    tok_emb = state_dict['wte'][token_id] # token embedding
    pos_emb = state_dict['wpe'][pos_id] # position embedding
    x = [t + p for t, p in zip(tok_emb, pos_emb)] # joint token and position embedding
    x = rmsnorm(x)

    for li in range(n_layer):
        # 1) Multi-head attention block
        x_residual = x
        x = rmsnorm(x)
        q = linear(x, state_dict[f'layer{li}.attn_wq'])
        k = linear(x, state_dict[f'layer{li}.attn_wk'])
        v = linear(x, state_dict[f'layer{li}.attn_wv'])
        keys[li].append(k)
        values[li].append(v)
        x_attn = []
        for h in range(n_head):
            hs = h * head_dim
            q_h = q[hs:hs+head_dim]
            k_h = [ki[hs:hs+head_dim] for ki in keys[li]]
            v_h = [vi[hs:hs+head_dim] for vi in values[li]]
            attn_logits = [sum(q_h[j] * k_h[t][j] for j in range(head_dim)) / head_dim**0.5 for t in range(len(k_h))]
            attn_weights = softmax(attn_logits)
            head_out = [sum(attn_weights[t] * v_h[t][j] for t in range(len(v_h))) for j in range(head_dim)]
            x_attn.extend(head_out)
        x = linear(x_attn, state_dict[f'layer{li}.attn_wo'])
        x = [a + b for a, b in zip(x, x_residual)]
        # 2) MLP block
        x_residual = x
        x = rmsnorm(x)
        x = linear(x, state_dict[f'layer{li}.mlp_fc1'])
        x = [xi.relu() for xi in x]
        x = linear(x, state_dict[f'layer{li}.mlp_fc2'])
        x = [a + b for a, b in zip(x, x_residual)]

    logits = linear(x, state_dict['lm_head'])
    return logits
이 함수는 특정 시간 위치(pos_id)의 토큰(식별자 token_id) 하나와 KV 캐시라고 하는 keys, values의 활성값으로 요약된 이전 반복의 문맥을 처리하고, 로짓을 반환합니다. 단계별로 보면 다음과 같습니다:
임베딩. 신경망은 5와 같은 원시 토큰 식별자를 직접 처리할 수 없습니다. 숫자 목록인 벡터로만 작업할 수 있습니다. 따라서 가능한 각 토큰에 학습된 벡터를 연결하고 그것을 신경망적 서명으로 입력합니다. 토큰 식별자와 위치 식별자는 각각의 임베딩 테이블(wte, wpe)에서 행을 조회합니다. 이 두 벡터를 더하면 토큰이 _무엇인지_와 시퀀스 내 _어디에 있는지_를 모두 부호화하는 표현을 모델에 제공합니다. 현대 LLM은 보통 위치 임베딩을 생략하고 RoPE 같은 다른 상대적 위치 방식를 도입합니다.
어텐션 블록. 현재 토큰은 쿼리(Q), 키(K), 값(V)이라는 세 벡터로 사영됩니다. 직관적으로 쿼리는 “나는 무엇을 찾는가?”, 키는 “나는 무엇을 담고 있는가?”, 값은 “선택되면 무엇을 제공하는가?”를 말합니다. 예를 들어 이름 “emma”에서 모델이 두 번째 “m” 위치에 있고 다음에 무엇이 올지 예측할 때, “최근에 어떤 모음이 나왔는가?” 같은 쿼리를 학습할 수 있습니다. 앞선 “e”는 이 쿼리와 잘 맞는 키를 갖기에 높은 어텐션 가중치를 받고, 그 값(모음이라는 정보)은 현재 위치로 흘러갑니다. 이전 위치를 사용할 수 있도록 키와 값은 KV 캐시에 추가됩니다. 각 어텐션 헤드는 자신의 쿼리와 모든 캐시된 키의 점곱을 계산하고(√d h e a d로 스케일링), softmax를 적용해 어텐션 가중치를 얻은 후 캐시된 값의 가중합을 취합니다. 모든 헤드의 출력은 이어 붙여지고 attn_wo를 통과해 사영됩니다. 어텐션 블록은 위치 t의 토큰이 과거 0..t-1의 토큰을 “볼” 수 있는 유일하고 정확한 장소라는 점을 강조할 가치가 있습니다. 어텐션은 토큰 간 통신 메커니즘입니다.
MLP 블록. MLP는 “다층 퍼셉트론”의 줄임말이며, 2층 순방향 신경망입니다. 임베딩 차원의 4배까지 사영하고 ReLU를 적용한 뒤 다시 낮춥니다. 모델이 각 위치에서 대부분의 “사고”를 하는 곳입니다. 어텐션과 달리 이 계산은 시간 t에 완전히 국소적입니다. Transformer는 통신(어텐션)과 계산(MLP)을 교차 배치합니다.
잔차 연결. 어텐션과 MLP 블록은 모두 자신의 출력을 입력에 다시 더합니다(x = [a + b for ...]). 이는 기울기가 네트워크를 직접 통과할 수 있게 하고 더 깊은 모델을 학습 가능하게 만듭니다.
출력. 최종 은닉 상태는 lm_head에 의해 어휘 크기로 사영되어, 어휘 속 토큰마다 하나의 로짓을 생성합니다. 여기서는 숫자 27개입니다. 로짓이 높을수록 모델은 해당 토큰이 다음에 올 가능성이 높다고 생각합니다.
학습 중 KV 캐시를 사용한다는 점이 눈에 띌 수 있는데, 이는 흔치 않은 일입니다. 보통 사람들은 KV 캐시를 추론 전용으로 생각합니다. 그러나 KV 캐시는 개념적으로 학습 중에도 항상 존재합니다. 실제 구현에서는 시퀀스의 모든 위치를 동시에 처리하는 고도로 벡터화된 어텐션 계산 안에 숨겨져 있을 뿐입니다. microgpt는 한 번에 토큰 하나를 처리하므로(배치 차원도, 병렬 시간 단계도 없음) KV 캐시를 명시적으로 만듭니다. 그리고 KV 캐시가 분리된 텐서를 보유하는 일반적인 추론 설정과 달리, 여기서 캐시된 키와 값은 계산 그래프 안의 살아 있는 Value 노드이므로 실제로 그들을 통해 역전파합니다.
이제 모든 것을 연결합니다. 학습 루프는 반복적으로 (1) 문서를 고르고, (2) 해당 토큰에 대해 모델 순전파를 실행하고, (3) 손실을 계산하고, (4) 역전파하여 기울기를 얻고, (5) 파라미터를 갱신합니다.
# Let there be Adam, the blessed optimizer and its buffers
learning_rate, beta1, beta2, eps_adam = 0.01, 0.85, 0.99, 1e-8
m = [0.0] * len(params) # first moment buffer
v = [0.0] * len(params) # second moment buffer

# Repeat in sequence
num_steps = 1000 # number of training steps
for step in range(num_steps):

    # Take single document, tokenize it, surround it with BOS special token on both sides
    doc = docs[step % len(docs)]
    tokens = [BOS] + [uchars.index(ch) for ch in doc] + [BOS]
    n = min(block_size, len(tokens) - 1)

    # Forward the token sequence through the model, building up the computation graph all the way to the loss.
    keys, values = [[] for _ in range(n_layer)], [[] for _ in range(n_layer)]
    losses = []
    for pos_id in range(n):
        token_id, target_id = tokens[pos_id], tokens[pos_id + 1]
        logits = gpt(token_id, pos_id, keys, values)
        probs = softmax(logits)
        loss_t = -probs[target_id].log()
        losses.append(loss_t)
    loss = (1 / n) * sum(losses) # final average loss over the document sequence. May yours be low.

    # Backward the loss, calculating the gradients with respect to all model parameters.
    loss.backward()

    # Adam optimizer update: update the model parameters based on the corresponding gradients.
    lr_t = learning_rate * (1 - step / num_steps) # linear learning rate decay
    for i, p in enumerate(params):
        m[i] = beta1 * m[i] + (1 - beta1) * p.grad
        v[i] = beta2 * v[i] + (1 - beta2) * p.grad ** 2
        m_hat = m[i] / (1 - beta1 ** (step + 1))
        v_hat = v[i] / (1 - beta2 ** (step + 1))
        p.data -= lr_t * m_hat / (v_hat ** 0.5 + eps_adam)
        p.grad = 0

    print(f"step {step+1:4d} / {num_steps:4d} | loss {loss.data:.4f}")
각 부분을 살펴보겠습니다:
토큰화. 각 학습 단계는 문서 하나를 고르고 양쪽을 BOS로 감쌉니다. 이름 “emma”는 [BOS, e, m, m, a, BOS]가 됩니다. 모델의 일은 앞선 토큰이 주어졌을 때 각각의 다음 토큰을 예측하는 것입니다.
순전파와 손실. 토큰을 하나씩 모델에 넣으며 KV 캐시를 쌓습니다. 각 위치에서 모델은 27개 로짓을 출력하고, 이를 softmax로 확률로 변환합니다. 각 위치의 손실은 올바른 다음 토큰의 음의 로그 확률입니다: −log p(target). 이를 교차 엔트로피 손실이라고 합니다. 직관적으로 손실은 오예측의 정도, 즉 실제 다음에 오는 것에 모델이 얼마나 놀랐는지를 측정합니다. 모델이 올바른 토큰에 확률 1.0을 할당하면 전혀 놀라지 않으며 손실은 0입니다. 확률을 0에 가깝게 할당하면 모델은 매우 놀라며 손실은 +∞로 갑니다. 문서 전체에서 위치별 손실을 평균내 하나의 스칼라 손실을 얻습니다.
역전파. loss.backward() 한 번의 호출은 손실에서 softmax와 모델을 거쳐 모든 파라미터까지 전체 계산 그래프를 통한 역전파를 실행합니다. 이 후 각 파라미터의 .grad는 손실을 줄이기 위해 어떻게 바꿔야 하는지 알려 줍니다.
Adam 옵티마이저. 단순히 p.data -= lr * p.grad(경사 하강법)을 수행할 수도 있지만, Adam은 더 영리합니다. 각 파라미터에 대해 두 개의 이동 평균을 유지합니다. m은 최근 기울기의 평균을 추적하며(굴러가는 공 같은 모멘텀), v는 최근 기울기 제곱의 평균을 추적합니다(파라미터별 학습률 적응). m_hat과 v_hat은 m과 v가 0으로 초기화되어 워밍업이 필요하다는 사실을 보정하는 편향 보정값입니다. 학습률은 학습 과정에서 선형으로 감소합니다. 갱신 후 다음 단계를 위해 .grad = 0으로 재설정합니다.
1,000단계에 걸쳐 손실은 약 3.3(27개 토큰 중 무작위 추측: −log(1/27)≈3.3)에서 약 2.37로 감소합니다. 낮을수록 좋고 가능한 최저값은 0(완벽한 예측)이므로 개선의 여지는 남아 있지만, 모델이 이름의 통계적 패턴을 분명히 학습하고 있습니다.
학습이 끝나면 모델에서 새 이름을 샘플링할 수 있습니다. 파라미터는 고정되고, 생성된 각 토큰을 다음 입력으로 다시 넣으며 루프에서 순전파만 실행합니다:
temperature = 0.5 # in (0, 1], control the "creativity" of generated text, low to high
print("\n--- inference (new, hallucinated names) ---")
for sample_idx in range(20):
    keys, values = [[] for _ in range(n_layer)], [[] for _ in range(n_layer)]
    token_id = BOS
    sample = []
    for pos_id in range(block_size):
        logits = gpt(token_id, pos_id, keys, values)
        probs = softmax([l / temperature for l in logits])
        token_id = random.choices(range(vocab_size), weights=[p.data for p in probs])[0]
        if token_id == BOS:
            break
        sample.append(uchars[token_id])
    print(f"sample {sample_idx+1:2d}: {''.join(sample)}")
각 샘플은 모델에 “새 이름을 시작하라”고 알리는 BOS 토큰으로 시작합니다. 모델은 27개 로짓을 만들고, 이를 확률로 변환한 다음 그 확률에 따라 무작위로 토큰 하나를 샘플링합니다. 그 토큰은 다음 입력으로 다시 주입되고, 모델이 다시 BOS를 생성할 때(“끝났다”는 뜻) 또는 최대 시퀀스 길이에 도달할 때까지 반복합니다.
temperature 파라미터는 무작위성을 제어합니다. softmax 이전에 로짓을 온도로 나눕니다. 온도 1.0은 모델이 학습한 분포에서 직접 샘플링합니다. 더 낮은 온도(여기서는 0.5)는 분포를 날카롭게 하여 모델을 더 보수적으로 만들고 최상위 선택지를 고를 가능성을 높입니다. 온도가 0에 가까워지면 항상 가장 가능성 높은 토큰 하나를 선택합니다(탐욕적 디코딩). 더 높은 온도는 분포를 평평하게 하며 더 다양하지만 잠재적으로 덜 일관된 출력을 만듭니다.
필요한 것은 Python뿐입니다(pip 설치도, 의존성도 없음):
python train.py
이 스크립트는 내 macbook에서 약 1분이 걸립니다. 각 단계에서 출력되는 손실을 볼 수 있습니다:
train.py
num docs: 32033
vocab size: 27
num params: 4192
step    1 / 1000 | loss 3.3660
step    2 / 1000 | loss 3.4243
step    3 / 1000 | loss 3.1778
step    4 / 1000 | loss 3.0664
step    5 / 1000 | loss 3.2209
step    6 / 1000 | loss 2.9452
step    7 / 1000 | loss 3.2894
step    8 / 1000 | loss 3.3245
step    9 / 1000 | loss 2.8990
step   10 / 1000 | loss 3.2229
step   11 / 1000 | loss 2.7964
step   12 / 1000 | loss 2.9345
step   13 / 1000 | loss 3.0544
...
약 3.3(무작위)에서 약 2.37을 향해 내려가는 모습을 보세요. 이 숫자가 낮을수록 네트워크가 시퀀스에서 다음에 올 토큰을 이미 더 잘 예측했다는 뜻입니다. 학습 마지막에는 학습 토큰 시퀀스의 통계적 패턴에 관한 지식이 모델 파라미터에 증류됩니다. 이 파라미터를 고정하면 이제 새로 환각한 이름을 생성할 수 있습니다. 다시 다음을 보게 됩니다:
sample  1: kamon
sample  2: ann
sample  3: karai
sample  4: jaire
sample  5: vialan
sample  6: karia
sample  7: yeran
sample  8: anna
sample  9: areli
sample 10: kaina
sample 11: konna
sample 12: keylen
sample 13: liole
sample 14: alerin
sample 15: earan
sample 16: lenne
sample 17: kana
sample 18: lara
sample 19: alela
sample 20: anton
컴퓨터에서 스크립트를 실행하는 대신, 이 Google Colab 노트북에서 직접 실행하고 Gemini에게 이에 관해 질문해 볼 수도 있습니다. 스크립트를 가지고 놀아 보세요! 다른 데이터셋을 시도할 수 있습니다. 또는 더 오래 학습하거나(num_steps 증가) 더 좋은 결과를 위해 모델 크기를 키울 수도 있습니다.
양파 껍질처럼 층층이 코드를 하나씩 쌓아 가는 과정을 보려면, 권장 진행 순서는 대략 다음과 같습니다:
| 파일 | 추가되는 내용 |
|---|---|
train0.py | 바이그램 개수 테이블 — 신경망도 기울기도 없음 |
train1.py | MLP + 수동 기울기(수치적 및 해석적) + SGD |
train2.py | 자동미분(Value 클래스) — 수동 기울기를 대체 |
train3.py | 위치 임베딩 + 단일 헤드 어텐션 + rmsnorm + 잔차 |
train4.py | 멀티헤드 어텐션 + 레이어 루프 — 완전한 GPT 아키텍처 |
train5.py | Adam 옵티마이저 — 이것이 train.py |
build_microgpt.py라는 Gist를 만들었으며, Revisions에서 이 모든 버전과 각 단계 사이의 차이를 볼 수 있습니다. 한 번에 구성 요소 하나를 추가하는 방식으로 코드베이스를 따라가는 데 도움이 될 수 있다고 생각합니다.
microgpt에는 GPT를 학습하고 실행하는 완전한 알고리즘적 본질이 담겨 있습니다. 하지만 이것과 ChatGPT 같은 실제 서비스용 LLM 사이에는 바뀌는 요소가 긴 목록으로 존재합니다. 그 어느 것도 핵심 알고리즘과 전체 배치를 바꾸지는 않지만, 실제로 대규모에서 작동하게 하는 요소들입니다. 같은 섹션 순서대로 살펴보겠습니다:
데이터. 32K개의 짧은 이름 대신 실제 서비스용 모델은 웹 페이지, 책, 코드 등 수조 개 토큰의 인터넷 텍스트로 학습합니다. 데이터는 중복 제거되고, 품질 기준으로 필터링되며, 도메인 전반에서 신중하게 혼합됩니다.
토크나이저. 단일 문자 대신 실제 서비스용 모델은 BPE(Byte Pair Encoding) 같은 서브워드 토크나이저를 사용합니다. 이들은 자주 함께 나타나는 문자 시퀀스를 하나의 토큰으로 병합하도록 학습합니다. “the” 같은 흔한 단어는 단일 토큰이 되고, 드문 단어는 조각으로 분해됩니다. 이는 약 100K 토큰의 어휘를 제공하며, 위치당 더 많은 내용을 보기 때문에 훨씬 효율적입니다.
자동미분. microgpt는 순수 Python의 스칼라 Value 객체로 동작합니다. 실제 시스템은 숫자로 이루어진 큰 다차원 배열인 텐서를 사용하고, 초당 수십억 번의 부동소수점 연산을 수행하는 GPU/TPU에서 실행됩니다. PyTorch 같은 라이브러리는 텐서에 대한 자동미분을 처리하고 FlashAttention 같은 CUDA 커널은 속도를 위해 여러 연산을 융합합니다. 수학은 동일하며, 단지 많은 스칼라가 병렬로 처리되는 것에 해당합니다.
아키텍처. microgpt는 파라미터가 4,192개입니다. GPT-4급 모델은 수천억 개입니다. 전반적으로 매우 비슷하게 생긴 Transformer 신경망이지만, 훨씬 넓고(10,000+의 임베딩 차원) 훨씬 깊습니다(100+ 레이어). 현대 LLM은 레고 블록 몇 가지 유형을 더 도입하고 순서도 바꿉니다. 학습된 위치 임베딩 대신의 RoPE(회전 위치 임베딩), KV 캐시 크기를 줄이는 GQA(그룹 쿼리 어텐션), ReLU 대신 게이트 선형 활성화, 전문가 혼합(MoE) 레이어 등이 예입니다. 그러나 잔차 스트림에서 어텐션(통신)과 MLP(계산)가 교차하는 핵심 구조는 잘 보존됩니다.
학습. 실제 서비스 학습은 단계당 문서 하나 대신 큰 배치(단계당 수백만 토큰), 기울기 누적, 혼합 정밀도(float16/bfloat16), 정교한 하이퍼파라미터 조정을 사용합니다. 최전선 모델 학습에는 수천 대의 GPU가 수개월 동안 실행됩니다.
최적화. microgpt는 단순한 선형 학습률 감소를 적용한 Adam을 사용하며 그게 거의 전부입니다. 규모가 커지면 최적화는 독자적인 분야가 됩니다. 모델은 효율성을 위해 저정밀도(bfloat16 또는 fp8)로, 대규모 GPU 클러스터 전반에서 학습되며, 이는 자체적인 수치적 문제를 일으킵니다. 옵티마이저 설정(학습률, 가중치 감쇠, 베타 파라미터, 워밍업 일정, 감소 일정)은 정밀하게 조정해야 하고, 적절한 값은 모델 크기, 배치 크기, 데이터셋 구성에 따라 달라집니다. 스케일링 법칙(예: Chinchilla)은 고정된 연산 예산을 모델 크기와 학습 토큰 수 사이에 어떻게 배분할지 안내합니다. 이 세부 사항 중 어느 하나라도 대규모에서 잘못 설정하면 수백만 달러의 연산 비용을 낭비할 수 있으므로, 팀은 전체 학습 실행에 투입하기 전에 적절한 설정을 예측하기 위해 광범위한 소규모 실험을 수행합니다.
사후 학습. 학습에서 나온 기본 모델(“사전학습” 모델)은 챗봇이 아니라 문서 완성기입니다. 이를 ChatGPT로 바꾸는 데에는 두 단계가 있습니다. 먼저 SFT(지도 미세 조정)입니다. 문서를 정제된 대화로 교체하고 계속 학습하기만 하면 됩니다. 알고리즘적으로는 아무것도 바뀌지 않습니다. 두 번째는 RL(강화 학습)입니다. 모델이 응답을 생성하고, 사람이든 다른 “심판” 모델이든 알고리즘이든 이를 점수화하며, 모델은 그 피드백으로부터 학습합니다. 근본적으로 모델은 여전히 문서로 학습하지만, 이제 그 문서는 모델 자체에서 나온 토큰으로 구성됩니다.
추론. 수백만 사용자에게 모델을 제공하려면 요청 배치 처리, KV 캐시 관리와 페이징(vLLM 등), 속도를 위한 추측 디코딩, 메모리를 줄이기 위한 양자화(float16 대신 int8/int4로 실행), 여러 GPU에 걸친 모델 분산 등 자체적인 엔지니어링 스택이 필요합니다. 근본적으로는 여전히 시퀀스의 다음 토큰을 예측하고 있지만, 더 빠르게 만들기 위해 많은 엔지니어링이 투입됩니다.
이 모든 것은 중요한 엔지니어링 및 연구 기여이지만, microgpt를 이해한다면 알고리즘적 본질을 이해하는 것입니다.
모델은 무엇인가를 “이해”하나요? 철학적 질문이지만, 기계적으로 말하면 마법 같은 일은 일어나지 않습니다. 모델은 입력 토큰을 다음 토큰에 대한 확률 분포로 매핑하는 큰 수학 함수입니다. 학습 중 파라미터는 올바른 다음 토큰의 확률을 높이도록 조정됩니다. 이것이 “이해”에 해당하는지는 여러분의 판단에 달렸지만, 그 메커니즘은 위의 200줄 안에 완전히 담겨 있습니다.
왜 작동하나요? 모델에는 수천 개의 조정 가능한 파라미터가 있고, 옵티마이저는 손실을 낮추기 위해 매 단계마다 이들을 아주 조금씩 움직입니다. 많은 단계를 거치면서 파라미터는 데이터의 통계적 규칙성을 포착하는 값으로 자리 잡습니다. 이름의 경우 이는 이름이 흔히 자음으로 시작한다거나, “qu”가 함께 나타나는 경향이 있다거나, 이름에 자음이 세 개 연속으로 드문다는 것 등을 의미합니다. 모델은 명시적인 규칙을 학습하는 것이 아니라, 우연히 그 규칙을 반영하는 확률 분포를 학습합니다.
ChatGPT와 어떤 관련이 있나요? ChatGPT는 대화형으로 만들기 위한 사후 학습을 더한, 엄청나게 규모를 키운 동일한 핵심 루프(다음 토큰 예측, 샘플링, 반복)입니다. 대화할 때 시스템 프롬프트, 여러분의 메시지, 모델의 답변은 모두 시퀀스 안의 토큰일 뿐입니다. 모델은 microgpt가 이름을 완성하듯 한 번에 하나의 토큰으로 문서를 완성합니다.
“환각”이란 무엇인가요? 모델은 확률 분포에서 샘플링하여 토큰을 생성합니다. 진실이라는 개념은 없고, 학습 데이터가 주어졌을 때 어떤 시퀀스가 통계적으로 그럴듯한지만 압니다. microgpt가 “karia” 같은 이름을 “환각”하는 것은 ChatGPT가 틀린 사실을 자신 있게 말하는 것과 같은 현상입니다. 둘 다 실제가 아닐 뿐 그럴듯하게 들리는 완성입니다.
왜 이렇게 느린가요? microgpt는 순수 Python에서 한 번에 스칼라 하나를 처리합니다. 학습 단계 하나에 몇 초가 걸립니다. GPU에서 같은 수학을 수행하면 수백만 스칼라를 병렬로 처리해 자릿수 차이만큼 더 빠르게 실행합니다.
더 좋은 이름을 생성하게 할 수 있나요? 네. 더 오래 학습하거나(num_steps 증가), 모델을 더 크게 만들거나(n_embd, n_layer, n_head), 더 큰 데이터셋을 사용하세요. 이는 대규모에서도 중요한 동일한 조절 장치입니다.
데이터셋을 바꾸면 어떻게 되나요? 모델은 데이터에 있는 어떤 패턴이든 학습합니다. 도시 이름, Pokemon 이름, 영어 단어, 짧은 시가 담긴 파일로 바꾸면 모델은 그 대신 그런 것을 생성하도록 학습합니다. 나머지 코드는 바꿀 필요가 없습니다.
