Rust에서 상속 대신 트레이트 기반 합성을 활용하는 방법과 더 나은 계약을 설계하는 원칙을 살펴봅니다.
Rust는 상속보다 합성을 선호합니다. 분명 이전에도 들어 보셨겠지만, 실제로 이것이 무엇을 의미하는지 설명하는 경우는 드뭅니다. 또한 이 모델이 Rust에 알맞은 선택인 이유는 무엇일까요?
한 걸음 물러나 예를 들어 봅시다. collect()가 왜 그런 방식으로 동작하는지 스스로 물어본 적이 있나요?
let doubled: Vec<_> = numbers.iter().map(|x| x * 2).collect();
collect는 여기서 어떻게 Vec를 만들어야 한다는 것을 알까요? 답하려면 먼저 Iterator::collect의 시그니처를 살펴봅시다.
fn collect<B: FromIterator<Self::Item>>(self) -> B
where
    Self: Sized,
{
    FromIterator::from_iter(self)
}
여기에는 Vec가 전혀 언급되지 않는다는 점에 주목하세요.
사실 이것은 어떤 컬렉션 타입이나 다른 어떤 타입에 대해서도 “알지” 못합니다. 이것이 알고 있는 것은 원하는 타입이 이터레이터로부터 자신을 구성할 수 있어야 한다는 점입니다. 그리고 우연히 Vec<_>는 그렇게 할 수 있는 타입입니다. 또한 벡터의 요소 타입도 지정하지 않았다는 점에 주목하세요. 컴파일러는 문맥으로부터 그것을 추론할 만큼 영리합니다!
이 메커니즘은 해시 맵, 문자열, 또는 이터레이터의 항목 타입에 대해 FromIterator를 구현하는 한 여러분이 선택한 사용자 정의 컬렉션 타입처럼, 지원되는 다른 모든 타입에도 동일하게 적용됩니다.
그리고 “수집”이 무엇을 뜻하는지도 타입 자체가 정의합니다. 예를 들어 String은 문자를 수집할 수 있습니다.
let chars = ['a', 'b', 'c'];
let string: String = chars.iter().collect(); // "abc"
또한 HashMap은 키-값 쌍을 수집할 수 있습니다.
let pairs = [("a", 1), ("b", 2), ("c", 3)];

// {"a": 1, "b": 2, "c": 3}
let map: HashMap<_, _> = pairs.iter().cloned().collect();
인터페이스가 공유 계약도 표현할 수 있다는 점은 언급할 만합니다. 여기서 독립적으로 정의된 두 구현은 공유된 항목 타입을 통해 연결됩니다. 이것이 “계약을 통한 합성”입니다.
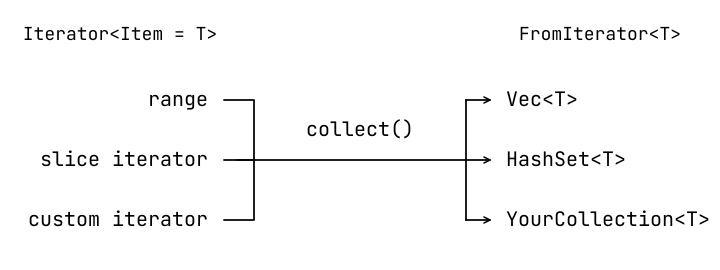
경계 조건이 충족되기만 하면 이 이터레이터들 중 어느 것이든 이 컬렉션들 중 어느 것으로든 공급할 수 있습니다. 예를 들어 HashSet<T>에는 T: Eq + Hash도 필요합니다.
여기서 생산자는 Iterator 트레이트를 통해 어떤 타입 T의 값을 산출합니다. 반대편에서 컬렉션은 FromIterator<T>를 구현하여 그 값들로부터 자신을 구성하는 방법을 설명합니다. 공유된 항목 타입 T가 두 계약을 연결하고, collect()는 그 사이의 다리입니다. 이는 목적지가 이터레이터가 산출하는 항목들로 구성될 수 있기만을 요구합니다.
첫 번째 예제에서 Vec<_> 어노테이션은 목적지 타입을 선택합니다. Vec<T>가 FromIterator<T>를 구현하므로, 컴파일러는 그 목적지를 이터레이터에 연결하는 방법을 압니다. collect()는 이터레이터를 해당 구현에 전달하는 접착제이며, 그 구현이 벡터를 만들고 채웁니다.
어느 쪽도 반대편의 구체 타입을 알 필요가 없다는 점에 주목하세요. 이터레이터는 벡터가 요소를 저장하는 방법을 알 필요가 없습니다. 벡터도 항목이 어디서 왔는지는 알 필요 없이, 그 항목을 순회하는 방법만 알면 됩니다.
이는 양쪽을 독립적으로 확장할 수 있음을 뜻합니다. 새 이터레이터는 기존 컬렉션에 공급할 수 있고, FromIterator<T>를 구현하는 새 컬렉션은 T를 산출하는 기존 이터레이터를 받을 수 있습니다. 생산자-컬렉션 쌍마다 별도의 변환이 필요하지 않습니다. 구현 하나만 있으면 되며, collect()가 모든 것을 한데 이어 주는 접착제입니다.
간단한 Rust 의사 코드로 호출을 단계별로 펼쳐 볼 수 있습니다.
// 호출:
iterator.collect::<Vec<T>>()

// collect()는 다음에 위임:
Vec::<T>::from_iter(iterator)

// 개념적으로는 다음과 같이 펼쳐짐:
let mut vector = Vec::new();
while let Some(item) = iterator.next() {
    vector.push(item);
}
vector
추상화의 가치는 그 사용자의 사이에 더는 존재할 필요가 없는 코드입니다.
클래스 상속은 “~이다” 관계를 모델링합니다. 예를 들어 Java에서 SSLSocket은 Socket의 하위 클래스입니다. 암호화된 소켓도 결국 소켓이기 때문입니다. 하지만 모든 소켓 연산이 그것에 적합할까요?
Socket.shutdownOutput()은 TCP 연결이 수신을 계속하면서 송신을 중단하게 하며, 이 기능은 “반쪽 닫기”라고 불립니다. 따라서 소켓을 사용하는 코드는 다음과 같이 할 수 있습니다.
void finishSending(Socket socket) throws IOException {
    socket.shutdownOutput();
}
Android API 레벨 21부터 23까지에서 플랫폼의 SSLSocket 구현은 UnsupportedOperationException으로 이 연산을 거부했습니다. 이로 인해 OkHttp 5.2.0에서 실제 충돌이 발생했습니다. 현대 OpenJDK는 TLS 인식 종료를 지원하므로, 이는 TLS의 보편적 한계가 아니라 역사적인 불일치입니다. 그래도 Socket 타입은 해당 구현이 그것을 지원하는지 호출자에게 알려 주지 않은 채 연산을 노출했습니다.
합성을 사용하면 TLS 연결은 소켓의 모든 연산을 노출하지 않고도 내부에 소켓을 보유할 수 있습니다. 읽기와 쓰기를 제공하고, 지원되는 경우 반쪽 닫기를 위한 별도 기능을 제공할 수 있습니다. 전송 계층의 전체 인터페이스를 상속하지 않고도 이를 재사용할 수 있습니다.
상속을 인터페이스나 트레이트로 단순히 바꾼다고 잘못 선택된 계약이 해결되지는 않습니다. 중요한 것은 계약이 구현의 능력과 일치하는지입니다.
Rust는 트레이트 기반 합성을 코드 재사용의 중심에 둡니다. Rust에서는 타입이 무엇을 할 수 있는지를 묻지, 그것이 무엇인지를 묻지 않습니다. 다시 말해 트레이트는 분류 체계가 아니라 능력을 설명합니다.
다음은 표준 라이브러리의 핵심 I/O 트레이트 두 개를 단순화한 버전입니다.
trait Read {
    fn read(&mut self, buf: &mut [u8]) -> io::Result<usize>;
}
trait Write {
    fn write(&mut self, buf: &[u8]) -> io::Result<usize>;
}
이 둘은 독립된 트레이트라는 점에 주목하세요. 타입은 Read를 구현할 수도, Write를 구현할 수도, 둘 다 또는 어느 것도 구현하지 않을 수도 있습니다. 관련 없는 메서드 묶음을 상속하지 않고 타입이 지원하는 연산을 선언하는 것입니다. 이 능력들은 직교합니다.
예를 들면 다음과 같습니다.
&[u8])는 Read를 구현하지만 Write는 구현하지 않습니다.std::io::sink()가 반환하는 Sink는 Write를 구현하지만 Read는 구현하지 않습니다.TcpStream은 둘 다 구현합니다.트레이트 구현은 구체적인 값이 아니라 _타입_에 속합니다. 예를 들어 std::fs::File을 보세요. 이는 Read와 Write를 모두 구현하지만, 읽기 전용 모드로 연 파일은 쓰기를 시도하면 여전히 런타임에 실패합니다. 쓰기용으로 연 파일조차 디스크가 가득 차면 실패할 수 있습니다. 트레이트 구현은 타입이 تلك 연산을 지원한다는 약속이지만, 모든 연산이 런타임에 성공한다고 보장할 수는 없습니다.
컴파일 시점에 읽기 전용 핸들과 쓰기 가능 핸들을 구분하고 싶다면 ReadOnlyFile과 WritableFile을 정의하고 각각에 적절한 트레이트만 구현할 수 있습니다. 그러면 API에서 지원되지 않는 연산을 배제할 수 있지만, I/O가 실패하지 않게 되는 것은 아닙니다.
Rust는 컨테이너가 내용물이 가진 경우에만 능력을 갖는다는 것을 표현할 수 있습니다. 예를 들어 Vec<T>는 T가 Clone을 구현할 때 Clone을 구현합니다. 이 기법 덕분에 복제 가능한 것과 불가능한 것으로 나뉜 서로 다른 두 Vec 타입이 생기지 않습니다.
다음은 직접 정의할 수 있는 작은 래퍼에 같은 패턴을 적용한 것입니다.
struct Batch<T> {
    items: Vec<T>,
}

impl<T: Clone> Clone for Batch<T> {
    fn clone(&self) -> Self {
        Self {
            items: self.items.clone(),
        }
    }
}
Batch<String>은 String이 복제 가능하므로 복제 가능합니다. TcpStream은 Clone을 구현하지 않으므로 Batch<std::net::TcpStream>은 그렇지 않습니다. 그 배치에서 .clone()을 호출하면 코드는 컴파일되지 않습니다. 복제 불가능한 항목을 배치에 저장할 수는 있지만, 그 배치를 복제할 수는 없습니다.
이 래퍼에는 #[derive(Clone)]를 사용하여 조건부 구현을 자동으로 생성할 수 있습니다. 경계는 Batch 자체가 아니라 구현에 속한다는 점에 유의하세요. 타입을 복제 가능하게 하려면 T: Clone이 필요하지만, 그와 별개로 Batch<T>는 복제 불가능한 요소에도 여전히 완전히 유효한 타입입니다. 컴파일러는 구성 요소 타입의 능력으로부터 어떤 연산을 사용할 수 있는지 판별합니다.
조건부 구현은 특정 래퍼 하나가 아니라 트레이트 경계를 충족하는 모든 타입에도 적용할 수 있습니다. 이를 _블랭킷 구현_이라고 합니다. 예를 들어 표준 라이브러리는 Display를 구현하는 모든 타입에 대해 ToString을 구현합니다.
impl<T: std::fmt::Display + ?Sized> ToString for T {
    // 구현 생략.
}
.to_string() 메서드를 얻기 위해 할 일은 타입에 Display를 구현하는 것뿐입니다. 컴파일러가 자동으로 ToString 구현을 생성합니다.
이 규칙은 표준 라이브러리 자체보다 한참 뒤에 작성된 타입에도 적용됩니다. 이는 능력 사이의 재사용 가능한 함의를 표현하는 우아한 방식입니다. “타입을 표시할 수 있다면 문자열로 바꿀 수 있다.”
같은 생각은 변환에도 나타납니다. From<T> for U를 구현하면 블랭킷 구현을 통해 자동으로 Into<U> for T가 제공된다는 것을 알고 있을 수 있습니다. 그래서 보통 대응하는 Into 구현을 직접 작성하기보다 From을 구현합니다.
조건부 구현은 한 값을 다른 값으로 감싸 동작을 추가하게도 해 줍니다. 이것은 다른 종류의 합성, 즉 “값의 합성”입니다. 래퍼는 다른 값을 보유하고 그 능력을 기반으로 확장합니다. 앞서 본 Read 트레이트를 살펴봅시다.
File은 Read를 구현합니다.BufReader로 감싸면 버퍼링이 추가되고, 결과는 여전히 Read를 구현합니다..take(limit)을 호출하면 산출하는 바이트 수가 제한되며, 결과는 여전히 Read를 구현합니다.File
→ BufReader<File>
→ Take<BufReader<File>>
따라서 R: Read를 받는 파서는 파일, 버퍼링된 파일, 길이가 제한된 버퍼링 파일을 각각 따로 지원할 필요가 없습니다. 그저 바이트를 읽으면 됩니다!
파서에 어느 쪽도 가르치지 않고 버퍼링과 바이트 제한을 추가할 수 있습니다. 파서는 입력이 어떻게 조립되었는지 이해할 필요가 없습니다.
이는 각 래퍼가 다음 조각에 필요한 계약을 보존하기 때문에 작동합니다. R이 Read를 구현할 때 BufReader<R>도 Read를 구현하며, Take<R>도 마찬가지입니다. 한 합성의 결과가 다음 합성을 위한 구성 요소가 됩니다.
이터레이터 체인에서도 같은 생각을 볼 수 있습니다.
.map()은 기반 이터레이터 I의 각 항목에 함수를 적용하는 Map<I, F> 이터레이터를 만듭니다..filter()는 술어 P를 만족하는 I의 항목만 산출하는 Filter<I, P> 이터레이터를 만듭니다..take()는 처음 n개 항목까지만 산출하는 Take<I> 이터레이터를 만듭니다.각 타입이 Iterator를 구현하므로 이들을 체인으로 연결할 수 있습니다.
자신만의 이터레이터를 작성하면 타입이 이 방대한 어댑터 생태계에 연결됩니다. 제공해야 할 것은 연관 Item 타입과 next() 메서드뿐입니다. map, filter, fold, collect에는 추가 경계가 충족될 때 사용할 수 있는 기본 구현이 이미 있습니다. 이것이 기반 클래스 없이 코드를 재사용하는 방법입니다. 기본 메서드는 구현하는 트레이트 안에서 동작을 제공하며, 블랭킷 구현은 다른 트레이트가 자동으로 적용되게 할 수 있습니다.
그러나 어댑터가 하나의 경직된 계약에만 한정될 필요는 없습니다. 풍부한 추가 능력도 제공할 수 있습니다.
예를 들어 Map<I, F>는 입력 이터레이터가 구현할 때 DoubleEndedIterator를 구현하며, 매핑 함수에 적절한 트레이트 경계를 둡니다.
let values: Vec<_> = (0..5)
    .map(|n| n * 2)
    .rev()
    .collect();

assert_eq!(values, [8, 6, 4, 2, 0]);
따라서 map 어댑터는 DoubleEndedIterator에 대한 조건부 구현을 가지므로 입력을 역방향으로 순회하는 능력을 보존합니다. 기본적인 순회에만 제한되지 않습니다.
그리고 구체적인 이터레이터 타입을 알고 있으므로 컴파일러는 전체 어댑터 체인을 하나의 루프로 최적화하고 인라인화할 수 있습니다. 최적화된 이터레이터 코드는 손으로 작성한 루프와 비슷한 성능을 낼 수 있습니다. 따라서 이터레이터 패턴을 완전히 수용해도 런타임 비용은 없습니다.
잠깐, Rust에는 “서로 관련된 여러 종류의 것”을 표현하는 또 다른 방법인 열거형이 있습니다! 이는 가능한 경우의 전체 목록을 미리 알고 있는 상황에서 유용합니다.
enum InputSource {
    File { path: PathBuf },
    Http { url: String, timeout: Duration },
    Stdin,
}
거의 항상 한곳에서 모든 배리언트를 처리하고 싶다면 열거형이 좋습니다. 서로 다른 타입이 같은 동작을 구현하고 현재 모든 타입을 알 수 없다면 트레이트가 더 나은 모델입니다. 다시 말해 열거형은 닫힌 배리언트 집합이고, 트레이트는 열린 구현 집합입니다.
열거형 정의를 바꾸지 않고는 새 배리언트를 추가할 수 없습니다. 하지만 트레이트는 개방-폐쇄 원칙을 가능하게 합니다. 기존 코드를 수정하지 않고 새 구현을 추가할 수 있습니다. 덕분에 다른 크레이트가 여러분의 코드를 수정하지 않고도 라이브러리를 확장할 수 있습니다.
라이브러리가 Record와 FetchError 타입을 정의하며, 사용자가 서로 다른 소스에서 레코드를 가져올 방법을 제공하고 싶다고 상상해 봅시다.
pub trait DataSource {
    fn fetch(&self) -> Result<Vec<Record>, FetchError>;
}
라이브러리에서 PostgresSource와 RedisSource에 DataSource를 구현합니다.
그러나 이제 사용자는 자신의 CsvFileSource나 CustomApiSource에도 이를 구현할 수 있습니다. 심지어 이 타입들이 존재한다는 것을 알 필요조차 없습니다. 그런데도 계약은 유지됩니다. DataSource를 구현하는 모든 타입은 레코드를 가져오는 데 사용할 수 있습니다.
반대도 마찬가지입니다. 외부 기여자는 여러분이 알지 못하는 사이에 확장 트레이트를 정의하고 여러분의 타입에 구현할 수 있습니다. 표준 라이브러리의 타입에도 그렇게 할 수 있습니다.
trait ScreamingCase {
    fn screaming_case(&self) -> String;
}

impl ScreamingCase for String {
    fn screaming_case(&self) -> String {
        self.to_uppercase()
    }
}
트레이트가 스코프에 있는 한 String에서 메서드를 호출할 수 있습니다.
let text = String::from("hello");
assert_eq!(text.screaming_case(), "HELLO");
String을 수정하거나 ScreamingString 하위 클래스를 만들 필요가 없습니다. 이 구현이 허용되는 이유는 우리 크레이트에서 ScreamingCase를 정의했기 때문입니다. Rust의 일관성 규칙은 외부 트레이트와 타입이 모두 관련된 구현을 제한합니다. 예를 들어 트레이트와 타입 어느 것도 우리의 것이 아니므로 표준 라이브러리의 Display 트레이트를 Vec<String>에 직접 구현할 수는 없습니다.
이는 동작 수준의 합성입니다. 기존 타입과 독립적으로 정의된 능력을 결합합니다. 타입과 트레이트는 서로를 알 필요가 없습니다. 같은 타입은 관련 없는 다른 트레이트도 구현할 수 있으며, 각 함수는 트레이트 경계로 필요한 능력만 요구할 수 있습니다.
// 이는 `ScreamingCase`를 구현하는 모든 타입에서 작동합니다.
// 예: `Vec<String>`이나 `char`에도 구현하면 어떨까요?
fn scream<T: ScreamingCase>(value: &T) {
    println!("{}", value.screaming_case());
}
이 열린 집합/닫힌 집합 원칙은 언제 열거형을 사용하고 언제 트레이트를 사용할지 생각하는 좋은 방법입니다. 다만 경계가 조금 흐려질 수는 있습니다. 열거형도 트레이트를 구현할 수 있고, 라이브러리는 “봉인된 트레이트”라는 기법으로 트레이트를 구현할 수 있는 주체를 제한할 수 있습니다.
애플리케이션 코드에서는 새 배리언트를 추가할 때 컴파일러가 업데이트해야 할 match 문을 알려 주므로, 열거형의 완전성 검사가 리팩터링을 쉽게 만들 수 있습니다. 타입 전반에 걸쳐 계약을 공유할 타당한 이유가 있을 때 트레이트를 도입하세요.
트레이트가 결합하는 서로 관련 없는 책임이 많을수록 구현하고 재사용하기 어려워집니다. 모든 구현자는 필요하지 않을 수도 있는 연산까지 고려해야 합니다.
다음 애플리케이션 컨텍스트를 보세요.
trait Context {
    fn fetch(&self, key: &str) -> Result<Record, Error>;
    fn store(&mut self, key: &str, record: &Record) -> Result<(), Error>;
    fn run(&mut self) -> Result<(), Error>;
}
스스로 물어보세요. 이 트레이트는 어떤 개념을 포착하나요? 어떤 계약을 강제하나요? 레코드 읽기, 레코드 쓰기, 애플리케이션 실행을 결합합니다.
어쩌면 애플리케이션은 정말로 하나의 타입이 이 모든 것을 제공해야 할 수 있지만, 레코드를 복사하는 함수가 입력에 애플리케이션 실행을 요구해서는 안 됩니다. 능력을 나눠 봅시다.
trait Fetch {
    fn fetch(&self, key: &str) -> Result<Record, Error>;
}

trait Store {
    fn store(&mut self, key: &str, record: &Record) -> Result<(), Error>;
}
이제 읽기 전용 소스는 Fetch를 구현할 수 있고, 쓰기 전용 대상은 Store를 구현할 수 있으며, 실행 런타임은 제외됩니다. 함수도 런타임을 알 필요가 없고, 필요한 정확한 능력을 합성할 수 있습니다.
fn copy_record<S: Fetch, D: Store>(
    source: &S,
    destination: &mut D,
    key: &str,
) -> Result<(), Error> {
    let record = source.fetch(key)?;
    destination.store(key, &record)
}
각 타입은 어느 한 트레이트를 구현할 수 있습니다. 또는 둘 다 구현할 수 있습니다.
이는 독립적인 크레이트가 여러분의 타입과 작동하는 방식도 설명합니다. Serde는 Serialize와 Deserialize를 정의하며, 여러분의 타입은 흔히 파생 매크로를 통해 이를 구현합니다. Serde의 직렬화기는 애플리케이션 구조체를 미리 알 필요가 없습니다. 공유 계약만 사용합니다. Serialize를 구현하는 타입은 직렬화할 수 있습니다. 그 결과 코드의 조합 가능성이 높아집니다. Serde가 직렬화와 역직렬화를 하나의 트레이트로 결합하기로 했다면, 일부 사용 사례는 표현할 수 없었을 것입니다.
이는 테스트에도 아주 좋습니다. 런타임을 만들지 않고 가짜 Fetch 구현과 가짜 Store 구현으로 copy_record를 테스트할 수 있습니다.
목표는 모든 트레이트가 정확히 하나의 메서드만 갖게 하는 것이 아닙니다. Iterator에는 많은 메서드가 있지만, 모두 값의 시퀀스를 순회하는 작업과 엄격하게 관련되어 있으며, 하나(next())를 제외한 전부에 기본 구현이 있습니다. 같은 계약을 설명한다면 메서드를 함께 두어도 괜찮지만, 호출자에게 독립적인 능력이 필요한지 확신이 없다면 트레이트를 나누세요.
아래는 트레이트 설계에 관한 몇 가지 구체적인 조언입니다.
문제에 접근할 때 코드가 타입에 무엇을 할 수 있기를 요구하는지 물어보세요. 흔히 기존 트레이트가 이미 그것을 표현합니다. 먼저 표준 라이브러리와 널리 쓰이는 크레이트를 확인하세요. 때로는 구체 타입이나 열거형이면 충분합니다.
먼저 구체적으로 코드를 작성하세요. 여러 타입에 걸쳐 비슷한 구현을 복사하고 있다면 공유 계약을 찾으세요. 그러면 추상화를 검증할 구체적인 예제가 생깁니다. 새 트레이트가 필요할 때는 한 문장으로 설명할 수 있는 계약을 부여하세요.
추상화에는 읽는 사람의 비용이 있습니다. 호출을 이해하려면 여러 파일에 걸친 경계와 구현을 따라가야 할 수 있습니다. 때로는 그 간접성이 신경 쓸 필요가 없는 세부 사항을 숨깁니다. 때로는 알아야 할 중요한 세부 사항을 숨깁니다.
Rust의 트레이트 기반 추상화는 흔히 추가 런타임 오버헤드를 전혀 유발하지 않지만, 컴파일 비용도 있습니다. 비용은 트레이트를 사용하는 방식에 따라 달라집니다. 제네릭 코드는 대개 단형화됩니다. 즉 컴파일러가 이를 사용하는 구체 타입을 위한 코드를 생성합니다. 이는 정적 디스패치와 인라인화를 가능하게 하지만, 많은 인스턴스화는 여전히 컴파일 시간과 바이너리 크기를 늘릴 수 있습니다. dyn 호환 트레이트의 경우 dyn Trait를 통한 동적 디스패치는 같은 호출자가 서로 다른 구현을 다루게 하지만, 간접 참조를 도입하고 인라인화를 제한할 수 있습니다. 모든 트레이트가 이를 지원하는 것은 아닙니다. 예를 들어 FromIterator는 dyn 호환이 아닙니다.
트레이트를 도입할 때 이러한 트레이드오프를 염두에 두세요. 공짜 점심은 없습니다.
이제 다시 한번 collect()로 돌아가 봅시다. 지금까지는 목적지 타입으로 컬렉션을 선택했습니다. 그러나 목적지 타입은 제어 흐름도 결정할 수 있습니다. 예를 들어 첫 번째 오류에서 순회를 멈출지, 계속 진행해 오류를 포함한 모든 결과를 수집할지 결정할 수 있습니다.
저는 Karol Kuczmarski의 Result & Option을 위한 순회 패턴에서 이를 처음 배웠으며, 지금도 가장 좋아하는 Rust 글 중 하나입니다.
실제로 동작하는 모습은 다음과 같습니다.
let input = ["10", "oops", "30"];

let every_result: Vec<Result<u32, _>> =
    input.iter().map(|s| s.parse()).collect();

let all_or_error: Result<Vec<u32>, _> =
    input.iter().map(|s| s.parse()).collect();
두 경우 모두 이터레이터 표현식은 동일하다는 점에 주목하세요. 바뀌는 것은 목적지 타입뿐입니다.
Vec<Result<u32, _>>는 모든 파싱 결과를 수집합니다.Result<Vec<u32>, _>는 첫 번째 오류를 반환하고 즉시 이터레이터 진행을 멈춥니다.두 번째 경우에는 "30"이 결코 파싱되지 않습니다. 모든 파싱이 성공하면 두 번째 버전은 값 벡터를 담은 Ok를 반환합니다. 이 동작은 표준 라이브러리의 Result용 FromIterator 구현에서 옵니다. 다음은 그 구현의 골격입니다.
impl<A, E, V> FromIterator<Result<A, E>> for Result<V, E>
where
    V: FromIterator<A>,
{
    // 구현 생략.
}
이는 다음을 말합니다.
Result<A, E>값의 이터레이터는Result<V, E>로 수집될 수 있으며,V가A타입의 값을 수집할 수 있기만 하면 됩니다.
V: FromIterator<A> 경계는 V가 Vec<A> 또는 그러한 값을 수집할 수 있는 다른 어떤 타입일 수 있음을 의미합니다. collect() 자체는 이 중 어느 것도 알 필요가 없습니다. 그저 목적지 타입의 FromIterator 구현을 호출할 뿐입니다.
이 모든 조각이 어떻게 맞물리는지 보이나요? 이것이 트레이트로 사고할 때 얻는 진정한 보상입니다. 하나의 구현으로 타입을 알고리즘, 어댑터, 컬렉션의 전체 생태계에 연결할 수 있습니다.
신중하게 만든 몇 가지 능력은 그 작성자조차 상상하지 못한 방식으로 결합될 수 있습니다. 그것이 전체를 부분의 합보다 크게 만듭니다. 그리고 그것이야말로 훌륭한 API 설계입니다.
