Linux와 FreeBSD에서 프로세스, 액터 모델, 파일 디스크립터 기능, Capsicum, Seccomp를 활용하는 소프트웨어 샌드박싱의 기초를 다룹니다.
메뉴
소프트웨어 샌드박싱의 영역으로 뛰어드는 일은 대부분 미지의 영역으로 뛰어드는 일입니다. 소프트웨어에 훌륭한 샌드박싱을 구현하기 위해 필요한 조각들은 여기저기에 흩어져 있으며, 개척자들은 아직 새 선원들을 잘 이해된 안전한 항로로 안내할 통일된 _mappa mundi_에 충분한 지식을 모아 두지 못했습니다. 이 블로그 글에서는 Emilua의 샌드박싱 지원을 작업하며 얻은 제 경험을 나누겠습니다. 오해를 피하기 위해 지나치게 반복하는 쪽을 택할 것이므로 글의 문체는 조금 희생될 것입니다.
여기 있는 일부 Lua 코드 예제에는 아직 출시되지 않은 Emilua 0.11이 필요하다는 점을 유의하세요(저장소의 개발 브랜치에서 최근 커밋을 가져오면 됩니다).
먼저, 같은 이해를 공유하는지 확인하기 위해 샌드박싱의 비공식적이지만 유용한 정의를 알아보겠습니다. 다음은 Julien Tinnes와 Chris Evans가 Hack In The Box Malaysia 2009에서 사용한 정의입니다.
프로세스의 권한을 제한하는 능력:
- 프로그램적으로;
- 머신에 대한 관리 권한 없이;
- 재량적 권한 축소.
이 정의는 논의를 이어 가기에 매우 좋습니다. 각 항목을 명확히 하기 위해 빠르게 하나씩 살펴보겠습니다. 다만 제가 오늘 가진 견해는 2009년 강연 당시 J. Tinnes와 C. Evans가 가졌던 견해와 조금 다르며(특히 “슈퍼유저 API를 사용해도 괜찮은가?”라는 문제에서), 따라서 제 설명은 조금 다르고 제가 2025년에 더 나은 관행이라고 생각하는 방향으로 안내할 것입니다.
운영체제는 사용자와 소프트웨어 개발자에게 서로 다른 인터페이스를 제공합니다. 시스템 관리자는 전통적으로 파일시스템 권한으로 서비스를 격리합니다(UNIX 데몬). 제3자 프로그램이 그러한 권한을 자유롭게 변경하도록 허용한다면, 애초에 시스템 관리자가 강제하려던 정책은 무력화될 것입니다.
또한 제3자 프로그램은 자체적인 가상 세계를 추상화하며, 대부분의 경우 UNIX 파일시스템 권한은 그러한 가상 세계가 요구하는 보안 정책을 모델링하기에 적합하지 않습니다. 누가 여러분의 Twitter 피드를 볼 수 있는지 또는 Identi.ca에서 여러분에게 메시지를 보낼 수 있는지를 UNIX 권한 모드로 정의합니까? 파일시스템 권한만이 시스템 관리자가 접근 권한을 제한할 수 있는 유일한 조절 장치는 아니지만, 여기서 전개한 논리는 다른 조절 장치에도 적용됩니다.
그럼에도 프로세스는 필연적으로 운영체제 위에서 실행되며, 프로세스가 상호작용하는 커널 노출 자원(예: 파일)이 있습니다. 소프트웨어 개발자에게 중요한 것은 이 인터페이스입니다. Firefox 같은 웹 브라우저는 DRM 플러그인을 실행하며, 그러한 제3자 플러그인이 Firefox가 접근할 수 있는 모든 파일(보통 사용자의 HOME 디렉터리에 있는 모든 파일)에 완전한 접근 권한을 갖지 못하게 실행하는 것이 바람직합니다. setuidgid 같은 전통적 도구는 여기서 도움이 될 수 없으며, 시스템 관리자가 사용하는 인터페이스로서도 유용성이 제한적입니다. setuidgid와 유사한 도구는 소프트웨어 개발자가 사용하도록 의도된 인터페이스가 아닙니다.
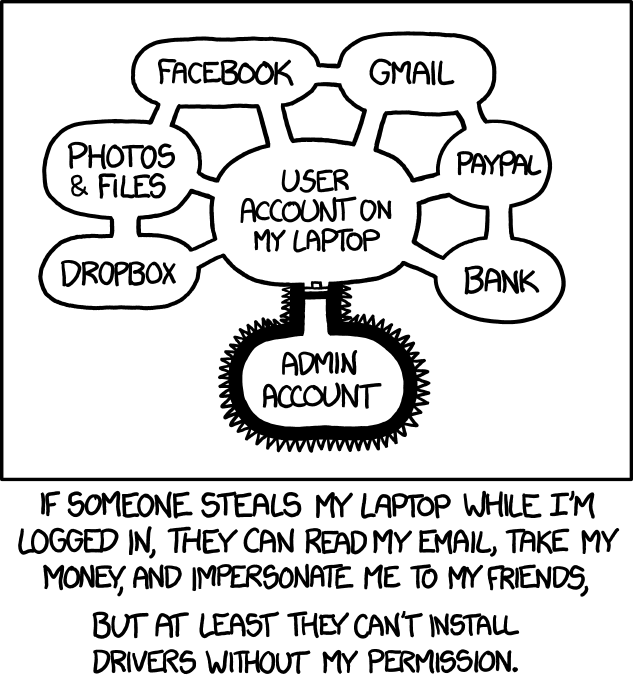
XKCD 1200: 권한 부여
프로그램적 권한 축소에 전통적인 UNIX 인터페이스는 잘 맞지 않으며, 이 간극이 실제로 중요한 운영체제는 전통적인 UNIX를 넘어서는 확장 인터페이스를 제공합니다(예: FreeBSD의 Capsicum 및 Linux의 Seccomp).
샌드박싱을 위한 좋은 인터페이스가 없었을 때, 프로그래머들은 슈퍼유저에게만 제공되는 메커니즘을 남용하여 어쨌든 샌드박스를 만드는 방법을 찾아냈습니다. 이 부류에서 가장 상징적인 기술은 chroot 감옥을 구성하는 보조 suid 바이너리입니다.
이러한 접근법의 명백한 문제는 모든 프로그램에서 사용할 수 없다는 점입니다. 모든 프로그램이 suid 바이너리를 설치하게 허용하면 모든 보안 조치가 무력화됩니다. Suid 바이너리는 일시적으로 시스템에 대한 완전한 관리 권한으로 권한을 올리는 것과 같습니다. 권한은 언제나 줄어들기만 해야 하며, 절대 늘어나서는 안 됩니다(최소 권한 원칙).
여기서 또 다른 관련 우려는 커널 공격 표면을 기하급수적으로 늘려 역효과를 내는 API를 설계하지 않는 것입니다. Docker 붐은 서비스를 저렴하게 격리하는 메커니즘으로 Linux 네임스페이스를 대중화했습니다. 그러나 중첩된 사용자 네임스페이스 안에서 프로세스는 슈퍼유저로 실행되며(그 네임스페이스 안에서), 보통 슈퍼유저에게만 제공되는 커널 내부 코드 경로가 이제 모든 사용자에게 제공됩니다. 우리는 이 전제로 작성된 적이 전혀 없는 10년이 넘는 커널 코드를 갖고 있습니다. 이 결정은 과거에 보안 문제를 일으켰으며, 다시 일어날 수밖에 없습니다. Andy Lutomirski의 말을 인용하면 다음과 같습니다.
CLONE_NEWUSER를 사용하여 어떤 네트워크 네임스페이스에 대해서든CAP_NET_ADMIN을 획득하고, 그에 따라 네트워크 구성 API에 접근할 수 있는 능력은 엄청난 위험이라고 생각합니다. 예를 들어 권한 없는 사용자가 iptables를 프로그래밍할 수 있습니다. 거기에 권한 상승이 없으면 제 모자를 먹겠습니다.
— Andy Lutomirski
https://lore.kernel.org/all/CALCETrWYRvqhyCwx5RX6L3TEYCfW0j6ThFUc+ASL7BpxgO5dEQ@mail.gmail.com/
신뢰할 수 있는 컨테이너화 도구(예: Docker)로 이 인터페이스를 제한하는 한 사용자 네임스페이스를 허용하는 것은 괜찮습니다. 그러나 Linux 네임스페이스는 소프트웨어 샌드박싱을 위한 끔찍한 인터페이스입니다. Landlock 같은 Linux의 새 샌드박싱 인터페이스는 Linux 사용자 네임스페이스에서 보았던 재앙을 피하고자 커널 공격 표면을 기하급수적으로 증가시키지 않도록 신중하게 설계되었습니다. 게다가 Linux 안에서 네임스페이스를 제한하는 새로운 방법은 여전히 개발 중이며, 장기적으로 일반적인 샌드박싱 메커니즘으로 이것들에 의존하는 것은 나쁜 선택입니다.
Emilua에 투입한 소프트웨어 샌드박싱 연구의 첫 몇 년은 오로지 Linux 네임스페이스에 집중했습니다. 많은 좌절 끝에 초점은 다른 해결책으로 옮겨갔습니다. 오늘날 Emilua는 여전히 Linux 네임스페이스를 지원하지만, 이제 의도된 사용 사례는 컨테이너화 도구의 생성입니다. Emilua 안에서 제대로 된 샌드박싱을 하려면 Linux 네임스페이스가 아닌 메커니즘을 사용하게 됩니다.
실제로 샌드박스는 다음과 같이 정의될 수도 있습니다.
잠재적으로 악의적인 소프트웨어가 […] 소프트웨어가 권한을 부여받은 자원 외의 어떠한 시스템 자원에도 접근하지 못하게 하는 제한되고 통제된 실행 환경.
— Committee on National Security Systems (CNSS) Glossary 2022
https://www.cnss.gov/CNSS/issuances/Instructions.cfm
어떤 코드가 샌드박싱된 것으로 간주되기 위해 어떤 특성이 필요한지에 대해서는 실제 합의가 없으며, 정의는 대개 매우 느슨합니다. 이 정의들은 지금까지 논의한 속성을 요구하지 않습니다. 따라서 완전히 다른 용어가 편리할 수 있습니다. J. Tinnes는 “재량적 권한 축소”를 제안했습니다. 이 글에서 살펴볼 샌드박싱이 바로 이 유형입니다.
재량적 권한 축소는 시스템 관리 정책을 대체하지 않습니다. 오히려 서로 보완하며 함께 채택해야 합니다.
이제 같은 이해를 공유하게 되었기를 바랍니다. 여기서 샌드박스는 재량적 권한 축소를 뜻합니다. 기존의 실제 운영체제에서 샌드박싱되지 않은 프로그램을 샌드박싱된 프로그램으로 어떻게 바꿀까요? 오늘날 모든 주류 운영체제에서 권한 경계는 프로세스 수준에 있습니다. 자격 증명은 각 프로세스에 연결되며, 이것이 프로세스가 주변 권한을 사용해 새 자원을 획득할 수 있는지 결정하기 위해 커널이 검사하는 대상입니다.
Linux는 실제로는 스레드 수준에서 자격 증명을 연결하므로 다릅니다. 그러나 스레드 수준에 뿌리를 둔 설계는 작동할 수 없으며, 이것이 커널이 이 점에서 허술하더라도 glibc가 스레드 간 자격 증명을 동기화하기 위해 추가 작업을 하는 이유입니다. GNOME 개발자는 스레드 수준에서 작업할 수 있다고 생각했지만 CVE-2023-43641로 틀렸음이 증명되었습니다.
Adam Langley는 이론상 스레드 수준에서 작동할 수 있지만 실무상 경제적 비용이 너무 크므로 결코 작동하지 않을 것이라고 생각하는 메커니즘을 설명했습니다.
그래서 우리는 이렇게 합니다. 신뢰할 수 없는 각 스레드에는 같은 프로세스에서 실행되는 신뢰할 수 있는 보조 스레드가 있습니다. 이는 신뢰할 수 있는 코드가 실행되기에는 확실히 상당히 적대적인 환경입니다. 우선 CPU 레지스터만 신뢰할 수 있고, 모든 메모리는 적대적이라고 가정해야 합니다. C 코드는 필요할 때 스택으로 값을 흘리고 인수를 스택으로 전달할 수 있으므로, 신뢰할 수 있는 스레드의 모든 코드는 어셈블리로 신중하게 작성되어야 합니다.
신뢰할 수 있는 스레드는 소켓 쌍을 통해 신뢰할 수 없는 스레드로부터 시스템 호출 요청을 받고, 시스템 호출 번호를 검증한 뒤 이를 대신 수행할 수 있습니다. CPU 레지스터만 사용하고 신뢰할 수 없는 코드가
mmap,mprotect등으로 안전하지 않은 방식으로 VM을 조작하지 못하게 거부하면 신뢰할 수 없는 스레드가 탈출하지 못하게 할 수 있습니다.
— https://www.imperialviolet.org/2009/08/26/seccomp.html
어떤 대안 설계가 작동할 수 있는지 이론화하지 맙시다. 오늘날 우리에게 있는 것은 프로세스입니다. 프로그램을 별도 프로세스로 구획화하면 다음 단계로 진행할 수 있습니다.
FreeBSD Capsicum 연구자들은 이미 10년 넘게 샌드박스를 개발할 수 있는 올바른 정신 모델을 갖고 있었습니다.
구획화된 애플리케이션 개발은 필연적으로 분산 애플리케이션 개발이며, 소프트웨어 구성 요소는 서로 다른 프로세스에서 실행되고 메시지 전달로 통신합니다.
— Capsicum: practical capabilities for UNIX
Robert N. M. Watson, Jonathan Anderson, Ben Laurie, and Kris Kennaway
권한을 축소하는 방법은 플랫폼마다 다르므로 지금은 건너뛰고 나중에 돌아오겠습니다. 먼저 분산 애플리케이션 개발 문제에 집중해 봅시다.
액터 모델은 분산 시스템 개발을 위한 가장 잘 알려진 패턴 중 하나입니다. Erlang은 아마도 가장 상징적인 사용자일 것입니다. 하지만 Erlang이 액터 모델에 관심을 두는 이유는 고가용성과 내결함성입니다. 그럼에도 고가용성이나 내결함성에 관심이 없더라도 널리 쓰이는 모델을 살펴보는 일은 유용합니다.
많은 액터 모델 설명은 빠르게 수학의 세계로 들어갑니다(그것은 괜찮습니다). 그러나 많은 설명이 빠르게 추상의 세계에서 길을 잃고 컴퓨터 자체를 완전히 잊습니다(그것은 좋지 않습니다). 그러니 액터 모델에서 우리가 신경 쓰는 요점만 요약해 보겠습니다.
프로그래밍 언어 또는 프레임워크 안의 구체적인 설계 선택으로 액터 모델을 요약하면, 다음이 중요합니다.
Emilua에서 이 설계는 다음 3개 함수로 바뀝니다.
spawn_vm(module) -> actor
actor.send(msg)
inbox.receive() -> msg
단 3개 함수를 배울 수 있다면 액터 모델용 코드를 작성할 수 있습니다. 이제 몇 가지 예를 살펴보겠습니다.
액터 생성
-- `module1.lua` will be the entry-point
-- for the execution of `new_actor1`
local new_actor1 = spawn_vm{
    module = 'module1' }

local new_actor2 = spawn_vm{
    module = 'module2' }
메시지 전송
new_actor1:send(1)
new_actor1:send('ping')
new_actor1:send{ arg1 = 1, arg2 = 2 }
메시지 수신
local inbox = require 'inbox'

while true do
    local msg = inbox:receive()
    handle(msg)
end
주소를 포함한 메시지 전송
new_actor1:send{ arg1 = 1, arg2 = 2, send_result_to = new_actor2 }
new_actor1:send{ arg1 = 3, arg2 = 4, send_result_to = inbox }
샌드박싱에 액터 모델을 쓰기로 결정한다면 각 프로세스는 액터가 됩니다. 액터 메시징에는 UNIX 도메인 소켓을 사용할 수 있습니다. 새 액터를 생성할 때 통신할 수 있도록 소켓 상속을 설정합니다. 소켓은 액터 주소가 됩니다. 다른 액터의 주소도 메시지에 포함할 수 있어야 하지만, UNIX 도메인 소켓을 통해 파일 디스크립터를 보낼 수 있으므로 이 역시 해결됩니다. 받은편지함 파일 디스크립터는 다른 액터에게 전송되지 않습니다(즉, MPSC 채널을 갖습니다).
Emilua에는 액터 모델 구현이 여럿 있으므로, 새 액터를 생성할 때 명시적으로 서브프로세스를 사용하라고 지시해야 합니다.
IPC 기반 액터 생성
local new_actor1 = spawn_vm{
    module = 'module1', subprocess = {} }

local new_actor2 = spawn_vm{
    module = 'module2', subprocess = {} }
이 설계는 샌드박싱 문제에서 또 다른 문제도 해결합니다. 즉, 제한된 프로세스에 자원을 넘겨주는 문제입니다. “모든 것은 파일(디스크립터)이다”는 UNIX 문화에서 가장 잘 알려진 문구 중 하나입니다. 파일 디스크립터를 보낼 수 있다면 샌드박싱된 프로세스에서 다룰 수 있는 자원의 범위가 아주 넓어집니다. 몇 가지만 들면 다음과 같습니다.
/dev/random, GPU 통신, …).프로그램을 샌드박싱할 때 우리가 관심을 두는 자원은 이것들입니다. 보안 모델을 개발할 때 고려할 자원도 이것들입니다. 잘못된 액터에 파일 디스크립터가 누출되지 않음을 증명할 수 있다면 액터 모델을 쓸 수 있습니다. 다행히도 이 문제를 해결하는 잘 연구된 모델이 있습니다. 바로 기능 기반 보안입니다. 액터 모델과 기능 기반 보안에 기반한 프로그래밍 언어도 있습니다. Pony 프로그래밍 언어입니다.
두 모델을 결합하기 위해 메워야 할 작은 간극은 하나뿐입니다. 기능 기반 보안은 위조 불가능한 토큰을 가정하지만 액터 모델은 주소를 사용한다는 점입니다(주소는 위조할 수 있습니다). 여기서는 주소 대신 채널을 사용하여 이미 이 문제를 해결했습니다. API는 그대로이며 아무도 알아차리지 못합니다. 이제 다음과 같은 질문을 추론하기 위해 기능을 사용할 수 있습니다.
파일 디스크립터를 기능으로 사용하는 경우의 경험칙은 ioctl을 피하는 것이지만, 이 주제는 나중에 다시 다루겠습니다.
액터 모델은 사용하기 간단하지만 매우 강력합니다. 메시지에 다른 액터의 주소를 포함할 수 있다는 것은 임의로 가변적인 토폴로지를 뜻합니다. 제 프로젝트 대부분에서는 트리 토폴로지로 제한하지만, 트리가 프로젝트에 맞지 않는 순간 쉽게 다른 토폴로지로 바꿀 수 있습니다. 지금까지 액터로 모델링할 수 없는 샌드박싱 애플리케이션을 하나도 만나지 못했습니다.
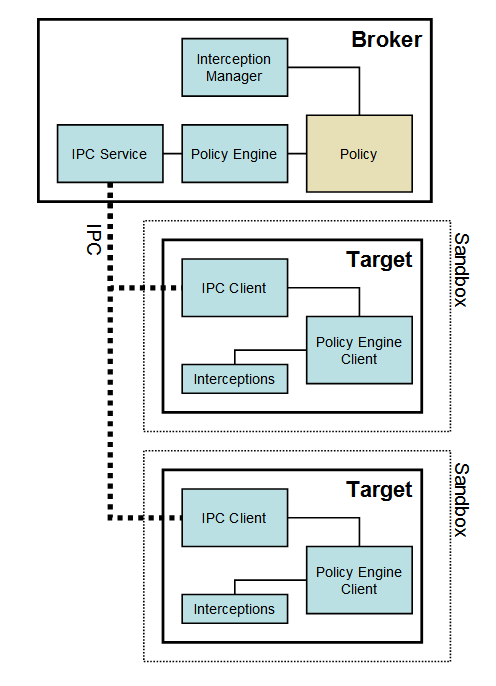
Chromium 샌드박스 토폴로지 다이어그램
액터 모델을 사용해 분산 애플리케이션을 개발하는 지침이 필요하다면, 그에 투입된 수십 년의 연구 개발을 즐길 수 있습니다. 책, 짧은 튜토리얼, 대면 수업, 스터디 그룹 또는 다른 여러 학습 방식을 선호하든 유용한 것을 찾을 가능성이 큽니다.
이제 액터 모델로 메시징을 해결했으니 다시 샌드박싱(보안 모델)으로 넘어갑시다. 객체가 기능으로 모델링되기 위해 갖춰야 하는 다른 속성도 있습니다. 기능은 자원에 대한 참조만이 아니라 연결된 접근 권한이기도 합니다. 기능을 소유한다는 것은 행동을 수행할 접근 권한도 가진다는 것과 같습니다. 이를 염두에 두고 다음을 생각해야 합니다.
일반적으로 UNIX 시스템은 기존 파일 디스크립터를 사용할 때가 아니라 새 파일 디스크립터가 만들어질 때만 접근을 허용하거나 거부하기 위한 권한 검사를 실행합니다. 이 동작은 기능과 호환됩니다. 다음은 예제 프로그램의 코드입니다.
#include <fcntl.h>
#include <stdio.h>

int main()
{
  int fd = open("/root", O_RDONLY);
  if (fd == -1) {
    perror("open");
  } else {
    printf("success\n");
  }
}
프로그램을 root로 실행했을 때의 출력입니다.
success
다른 사용자로 실행했을 때의 출력입니다.
open: Permission denied
이것이 앞서 언급한 UNIX 동작입니다. 이제 root로 셸 명령을 실행해 보겠습니다.
# grep -Ee '^nobody:' </etc/shadow
nobody:!*:19642::::::
그리고 다른 사용자로 같은 명령을 실행합니다.
$ grep -Ee '^nobody:' </etc/shadow
-bash: /etc/shadow: Permission denied
놀랄 일은 없습니다. 같은 동작일 뿐입니다. 이제 권한 없는 사용자로 grep을 실행하되, root가 연 파일 디스크립터를 상속받도록 해 보겠습니다.
# setpriv --reuid=1000 --regid=1000 --init-groups grep -Ee '^nobody:' </etc/shadow
nobody:!*:19642::::::
앞서 말했듯 UNIX 시스템은 일반적으로 기존 파일 디스크립터에서 동작을 수행할 때 권한 검사를 실행하지 않습니다. 그래서 예제에서 grep은 파일 내용을 읽는 데 성공했습니다. 이는 이전 예제(일반 파일에서 읽기 동작)에서는 사실이었지만 언제나 사실일까요? 새 커널 버전을 걱정할 수도 있습니다. 이 관례를 깨는 새 시스템 호출이 언제든 도입될 수 있기 때문입니다. 그러나 UNIX 역사 초기에 suid 바이너리 개념이 도입되었으며, 이 유산은 커널 개발자들이 이 관례를 깨지 않도록 계속 압박할 것입니다. 이제 suid 바이너리를 살펴보겠습니다.
마지막 예제에서는 슈퍼유저가 시스템 호출 setresuid를 사용해 프로세스 자격 증명을 바꿨습니다. 이제 반대 방향으로 가서 권한 없는 프로세스에서 권한 있는 자식 프로세스를 만들겠습니다. 이는 suid 바이너리에만 허용되므로 권한 있는 프로세스는 시스템 관리자가 신뢰하는 프로그램만 실행합니다. 그러한 프로그램 중 하나가 su입니다.
$ setsid su </dev/null 2>&1 | cat
Password: su: Authentication token manipulation error
이 예제는 간단한 fd 상속을 사용해 suid 바이너리가 우리가 가진 임의의 파일 디스크립터에 읽거나 쓰도록 쉽게 속일 수 있음을 보여 줍니다. 이 예제에서 권한 있는 프로세스의 자격 증명으로 다음 문자열을 썼습니다.
Password: su: Authentication token manipulation
error
작성 프로세스의 자격 증명이 시스템 보안에 중요했다면 모든 UNIX 시스템은 이미 깨졌을 것입니다. 그러므로 새 인터페이스는 언제나 작성 프로세스의 자격 증명이 전혀 중요하지 않도록 설계됩니다.
이 점을 더 강조하는 최근 사례로, Linux가 마지막으로 도입한 시스템 호출 중 일부는 파일시스템 마운트와 관련되었습니다. 기여된 패치 모음의 초기 버전은 권한 검사에 호출 프로세스의 자격 증명을 사용하는 동작에서 시스템 호출 write를 사용했기 때문에 거부되었습니다. 결국 기여자는 새 시스템 호출 fsconfig를 사용하도록 설계를 변경했고 패치 모음은 받아들여졌습니다.
커널 개발자는 Linux 배포판에서 suid 바이너리가 허용되는지와 관계없이 이 관례를 지킨다는 점이 중요합니다. 운영체제에서 suid 바이너리를 완전히 막더라도, 공격자가 위험한 쓰기 동작을 수행하는 프록시로 우리 프로세스를 사용하여 새 권한을 얻을 수 없다고 가정할 수 있습니다(공격자는 대신 파일 디스크립터에 직접 쓸 수 있으며 효과는 같았을 것입니다).
이 규칙의 예외는 ioctl입니다. 신뢰할 수 없는 프로세스에서 받은 fd에 ioctl을 수행하는 것은 언제나 위험합니다. Emilua는 비동기 IO에 Boost.Asio를 사용하며, Boost.Asio는 사용하면 안 될 때 FIONBIO에 의존하곤 했습니다. 몇 차례 이메일을 주고받은 뒤 Christopher Kohlhoff를 설득해 이 동작을 바꾸었으며, 이제 적어도 Boost 1.86을 사용한다면 Boost.Asio는 올바르게 동작합니다. 참고로 isatty()조차도 Linux에서는 적어도 ioctl로 구현되므로 비표준 동작에는 정말 주의해야 합니다.
훌륭합니다. 파일 디스크립터를 실제로 기능으로 모델링할 수 있지만, 우리가 이 결론에 처음 도달한 것은 아닙니다.
Capsicum은 파일 디스크립터를 기능으로 더 잘 사용할 수 있도록 지원하는 인터페이스이며 FreeBSD 9.0 릴리스부터 포함되어 있습니다. Capsicum이 제공하는 기능 중 하나는 cap_enter 함수입니다. cap_enter는 주변 권한을 완전히 비활성화하여 프로세스 권한을 축소합니다.
local new_actor3 = spawn_vm{
    module = 'module3',
    subprocess = {
        -- the runtime will run this Lua
        -- code before it attempts to
        -- initialize complex libraries
        -- or acquire system resources
        init = 'C.cap_enter()'
    } }
이것으로 끝입니다. 함수 호출 한 번으로 권한을 축소했습니다. 모든 시스템 접근은 열린 파일 디스크립터를 통해 수행되어야 합니다. 어떤 자원에 아직 접근할 수 없다면 이제 그것을 얻는 유일한 방법은 inbox를 통하는 것입니다. 파일을 열려고 하면 주변 권한이 비활성화되었으므로 open은 실패합니다. 소켓을 어떤 끝점에 연결하려 해도 주변 권한이 비활성화되었으므로 동작은 실패합니다. 이것이 Capsicum의 아름다움입니다. 자원을 참조하는 데 쓸 수 있는 이름 자체를 사용할 수 없게 되므로 외부 자원에 대한 접근을 거부합니다.
Capsicum 연구가 발표되었을 때 다음 표도 제시되었습니다.
표 1. Chromium이 사용한 샌드박싱 메커니즘
| 운영체제 | 모델 | 줄 수 | 설명 |
|---|---|---|---|
| Windows | ACL | 22350 | Windows ACL 및 SID |
| Linux | chroot | 605 | setuid root 도우미가 렌더러를 샌드박싱 |
| Mac OS X | Seatbelt | 560 | 경로 기반 MAC 샌드박스 |
| Linux | SELinux | 200 | 제한된 샌드박스 유형 강제 도메인 |
| Linux | seccomp | 11301 | seccomp 및 사용자 공간 시스템 호출 래퍼 |
| FreeBSD | Capsicum | 100 | cap_enter를 사용한 Capsicum 샌드박싱 |
당시 연구자들은 Chromium이 Capsicum을 사용하도록 수정하고, Chromium 안에서 각 샌드박싱 메커니즘을 사용하는 데 필요한 노력을 비교했습니다. Capsicum에는 겨우 100줄의 코드가 필요했습니다. seccomp의 11301줄이나 Windows의 22350줄과 비교해 보세요. 비교된 다른 메커니즘은 실제로 샌드박스를 유의미하게 제한하지 않았으므로 무시할 수 있습니다. 평생 샌드박싱 메커니즘을 하나만 공부한다면 Capsicum이어야 합니다. 오늘날까지 Capsicum보다 더 나은 샌드박싱 메커니즘은 보지 못했습니다.
Capsicum은 파일 디스크립터에 더 세밀한 접근 제어도 제공합니다. 예를 들어 Capsicum을 사용하면 한 프로세스가 세마포어를 기다릴 수는 있지만 게시하지는 못하도록 할 수 있습니다. 파일 디스크립터는 보통 모든 권한이 할당된 상태로 만들어집니다. 이후 cap_rights_limit 함수를 사용해 이 권한을 줄일 수 있습니다.
local unix = require 'unix'

local in_, out = unix.seqpacket.socket.pair()
out:shutdown('receive')
out = out:release() --< get file descriptor

-- deny shutdown-send so one
-- worker cannot shutdown the
-- channel to everyone
out:cap_rights_limit({'send'})

for i = 1, 20 do
    local worker = spawn_vm{
        module = 'worker',
        subprocess = {
            init = 'C.cap_enter()'} }
    worker:send(out)
end
out:close()

local buf = byte_span.new(512)
while true do
    local nread = in_:receive(buf)
    print(buf:first(nread))
end
open()은 Capsicum 모드에서 작동하지 않지만 openat()은 작동하며, Capsicum은 상대 경로가 주어진 디렉터리 fd 아래의 계층으로만 해석되도록 보장합니다. Linux 시스템 호출이 언제나 RESOLVE_BENEATH를 포함하도록 강제할 수만 있다면 좋겠습니다… 하지만 가능할지도 모릅니다. 이 주제로 돌아올 때까지 계속 읽어 보세요.
Capsicum을 사용하며 실제로 많은 문제를 겪지 않았고, 제가 가진 유일한 불만도 오래전에 고쳐졌습니다. Capsicum에 대해서는 할 말이 많지 않습니다. 시스템은 쓰기 매우 간단하면서도 강력합니다. 이 모델은 운영체제와 관계없이 이 글의 나머지에서 개발하는 모든 샌드박스의 영감이 될 것입니다.
샌드박스에서 파일 디스크립터를 받으면 그것을 조작할 차례입니다. 그러나 이에 부주의하면 스레드가 블록됩니다. 일부 DoS 시도를 피하려면 블로킹 동작을 피해야 합니다. UNIX의 논블로킹 IO를 둘러싼 혼란은 오래전부터 알려져 왔습니다. 여기에도 제가 할 말이 많지만 이 글은 비동기 IO에 관한 글이 아니고 이미 너무 길어지고 있으므로, 알아야 할 내용을 지루하게 요약해서 제시하겠습니다.
close()는 블록될 수 있습니다.close()는 항상 성공한다고 합니다. 여기서는 오류를 확인하느라 애쓰지 마세요.close()를 실행할 스레드를 만들어야 할 수도 있습니다.fstat를 사용하세요.recv()에 MSG_DONTWAIT를 사용하세요. Boost.Asio는 여전히 이를 잘못 처리하지만, 곧 버그 수정을 보낼 시간이 없습니다.AIO_OP2_FOFFSET와 함께 aio_read2()를 사용해 오프셋 없이 읽을 수 있습니다. 다른 접근법은 ENOTCAPABLE로 실패할 가능성이 큽니다. Boost.Asio도 이를 잘못 처리하며, 이 문제도 버그 수정을 보낼 시간이 없습니다.이제 실제로 두 가지 사용 사례가 있음을 이해했을 것입니다.
파일 디스크립터를 신뢰할 수 있는 프로세스가 만들었다면 활용할 수 있는 선택지의 범위가 넓어집니다. 하지만 O_NONBLOCK 같은 상태는 파일 디스크립터의 모든 사본 사이에서 공유되며, 파일 디스크립터가 첫 샌드박싱된 프로세스에 도달하는 순간 문제가 됩니다. Capsicum에서는 적어도 F_SETFL을 금지해 문제를 조금 완화할 수 있지만 이 접근법은 FreeBSD에서만 작동합니다.
이제 미래의 모든 코드를 샌드박싱할 도구를 도구 상자에 충분히 갖추었을 것입니다. 그러나 우리가 코드를 샌드박싱하는 데에는 이유가 있습니다. 프로젝트는 커지고 복잡해져서 코드에 버그가 없음을 보장하는 것이 불가능해집니다. 프로젝트의 수십 개 모듈 중 단 하나의 작은 버그가 해커에게 악용되었을 때 시스템 전체가 완전히 손상되는 결과로 이어져서는 안 됩니다. 피해는 격리되어야 합니다. 코드 외부의 운영체제 도구로 구현한 보안 정책은 프로그램(또는 사용자) 수준에서만 작동할 수 있습니다. 프로그램은 여전히 완전히 손상되고, 해커는 프로그램이 접근할 수 있는 모든 데이터와 자격 증명에 접근할 수 있습니다.
프로그램이 독립적으로 처리할 수 있는 데이터를 다룬다면 더 안전한 접근법을 구현할 기회가 있습니다. 운영체제에서 서로 다른 사용자로 프로그램의 여러 인스턴스를 실행할 수 있다면 기존 보안 해결책을 프로젝트에 사용할 수 있습니다. 그러나 데이터의 정의된 부분을 고정 사용자에게 할당하는 개념이 프로젝트에 맞지 않는다면 더 복잡하거나 맞춤형인 것이 필요할 수 있습니다. 사용자 간 관계가 모호하고 프로젝트가 더 동적인 정책을 요구한다면 샌드박스가 필요할 수 있습니다.
경험칙으로 모든 셸에는 샌드박스가 있어야 합니다. 셸은 인간 운영자와 어떤 가상 세계 사이에 있는 막 역할을 하는 프로그램입니다. 태블릿, 스마트폰, 노트북은 프로그램, 창, 파일과 상호작용하기 위한 그래픽 셸을 표시합니다. 서버는 텍스트 셸을 사용합니다. 마찬가지로 웹 브라우저는 www 세계의 셸 역할을 합니다.
여러분이 아는 재량적 권한 축소를 사용하는 소프트웨어가 Firefox와 Chrome뿐이어도 놀라지 않을 것입니다. 결국 이들은 셸이므로 중요합니다. 그뿐 아니라 아주 자금이 풍부한 프로젝트입니다. 샌드박싱은 과거에 매우 비쌌습니다(특히 FreeBSD 밖에서). 하지만 내장 샌드박싱 지원을 갖춘 소프트웨어가 이들뿐이어서는 안 됩니다. 예를 들어 Telegram을 보세요. 적절한 미디어 파싱 버그 하나로 해커가 내 모든 채팅 기록에 접근할 수 있습니다. 내 아들은 몇 시에 학교에서 나오나? 나는 누구에게 신용카드 정보를 맡기나? 언제 여행을 가서 집을 비우나? Telegram에 샌드박스가 없어서 생길 수 있는 피해의 몇 가지 예일 뿐입니다. Telegram뿐 아니라 모든 인스턴트 메신저는 샌드박스를 사용해야 합니다. 미디어 파싱은 언제나 전용 샌드박스에서 수행되어야 합니다.
이 방향의 첫 단계는 현실 세계 엔지니어링에 현실적으로 접근하는 것입니다. 모든 코드를 처음부터 다시 작성하지 맙시다. 괜찮습니까? 앞에서 배운 요령은 여전히 유용하지만, 이제부터는 기존 실제 코드에 적용하는 요령을 공유하겠습니다. Capsicum 사용자는 수정하지 않은 코드를 샌드박스 안에서 실행하는 능력을 망각적 샌드박싱이라고 부릅니다. 망각적 샌드박싱 기법은 대부분 재량적 권한 축소와 아무 관계가 없으며, 방금 언급한 문제를 해결할 수 없습니다. 하지만 같은 프로젝트 안에서 두 세계의 접근법을 결합할 수 있으므로 망각적 샌드박싱 기법도 공부하는 것이 중요합니다.
망각적 샌드박싱을 구현하기 위해 살펴봐야 할 곳은 사실 아주 명백합니다. 바로 주변 권한 함수입니다. 실제로 Super Capsicumizer 9000 같은 프로젝트가 하는 일입니다. 이들은 LD_PRELOAD로 동적 라이브러리를 프로세스에 주입해 주변 권한 호출을 가로챕니다. 이 기법은 사실 새로운 소식도 아니며 fakeroot 같은 프로젝트는 수십 년 동안 사용해 왔습니다.
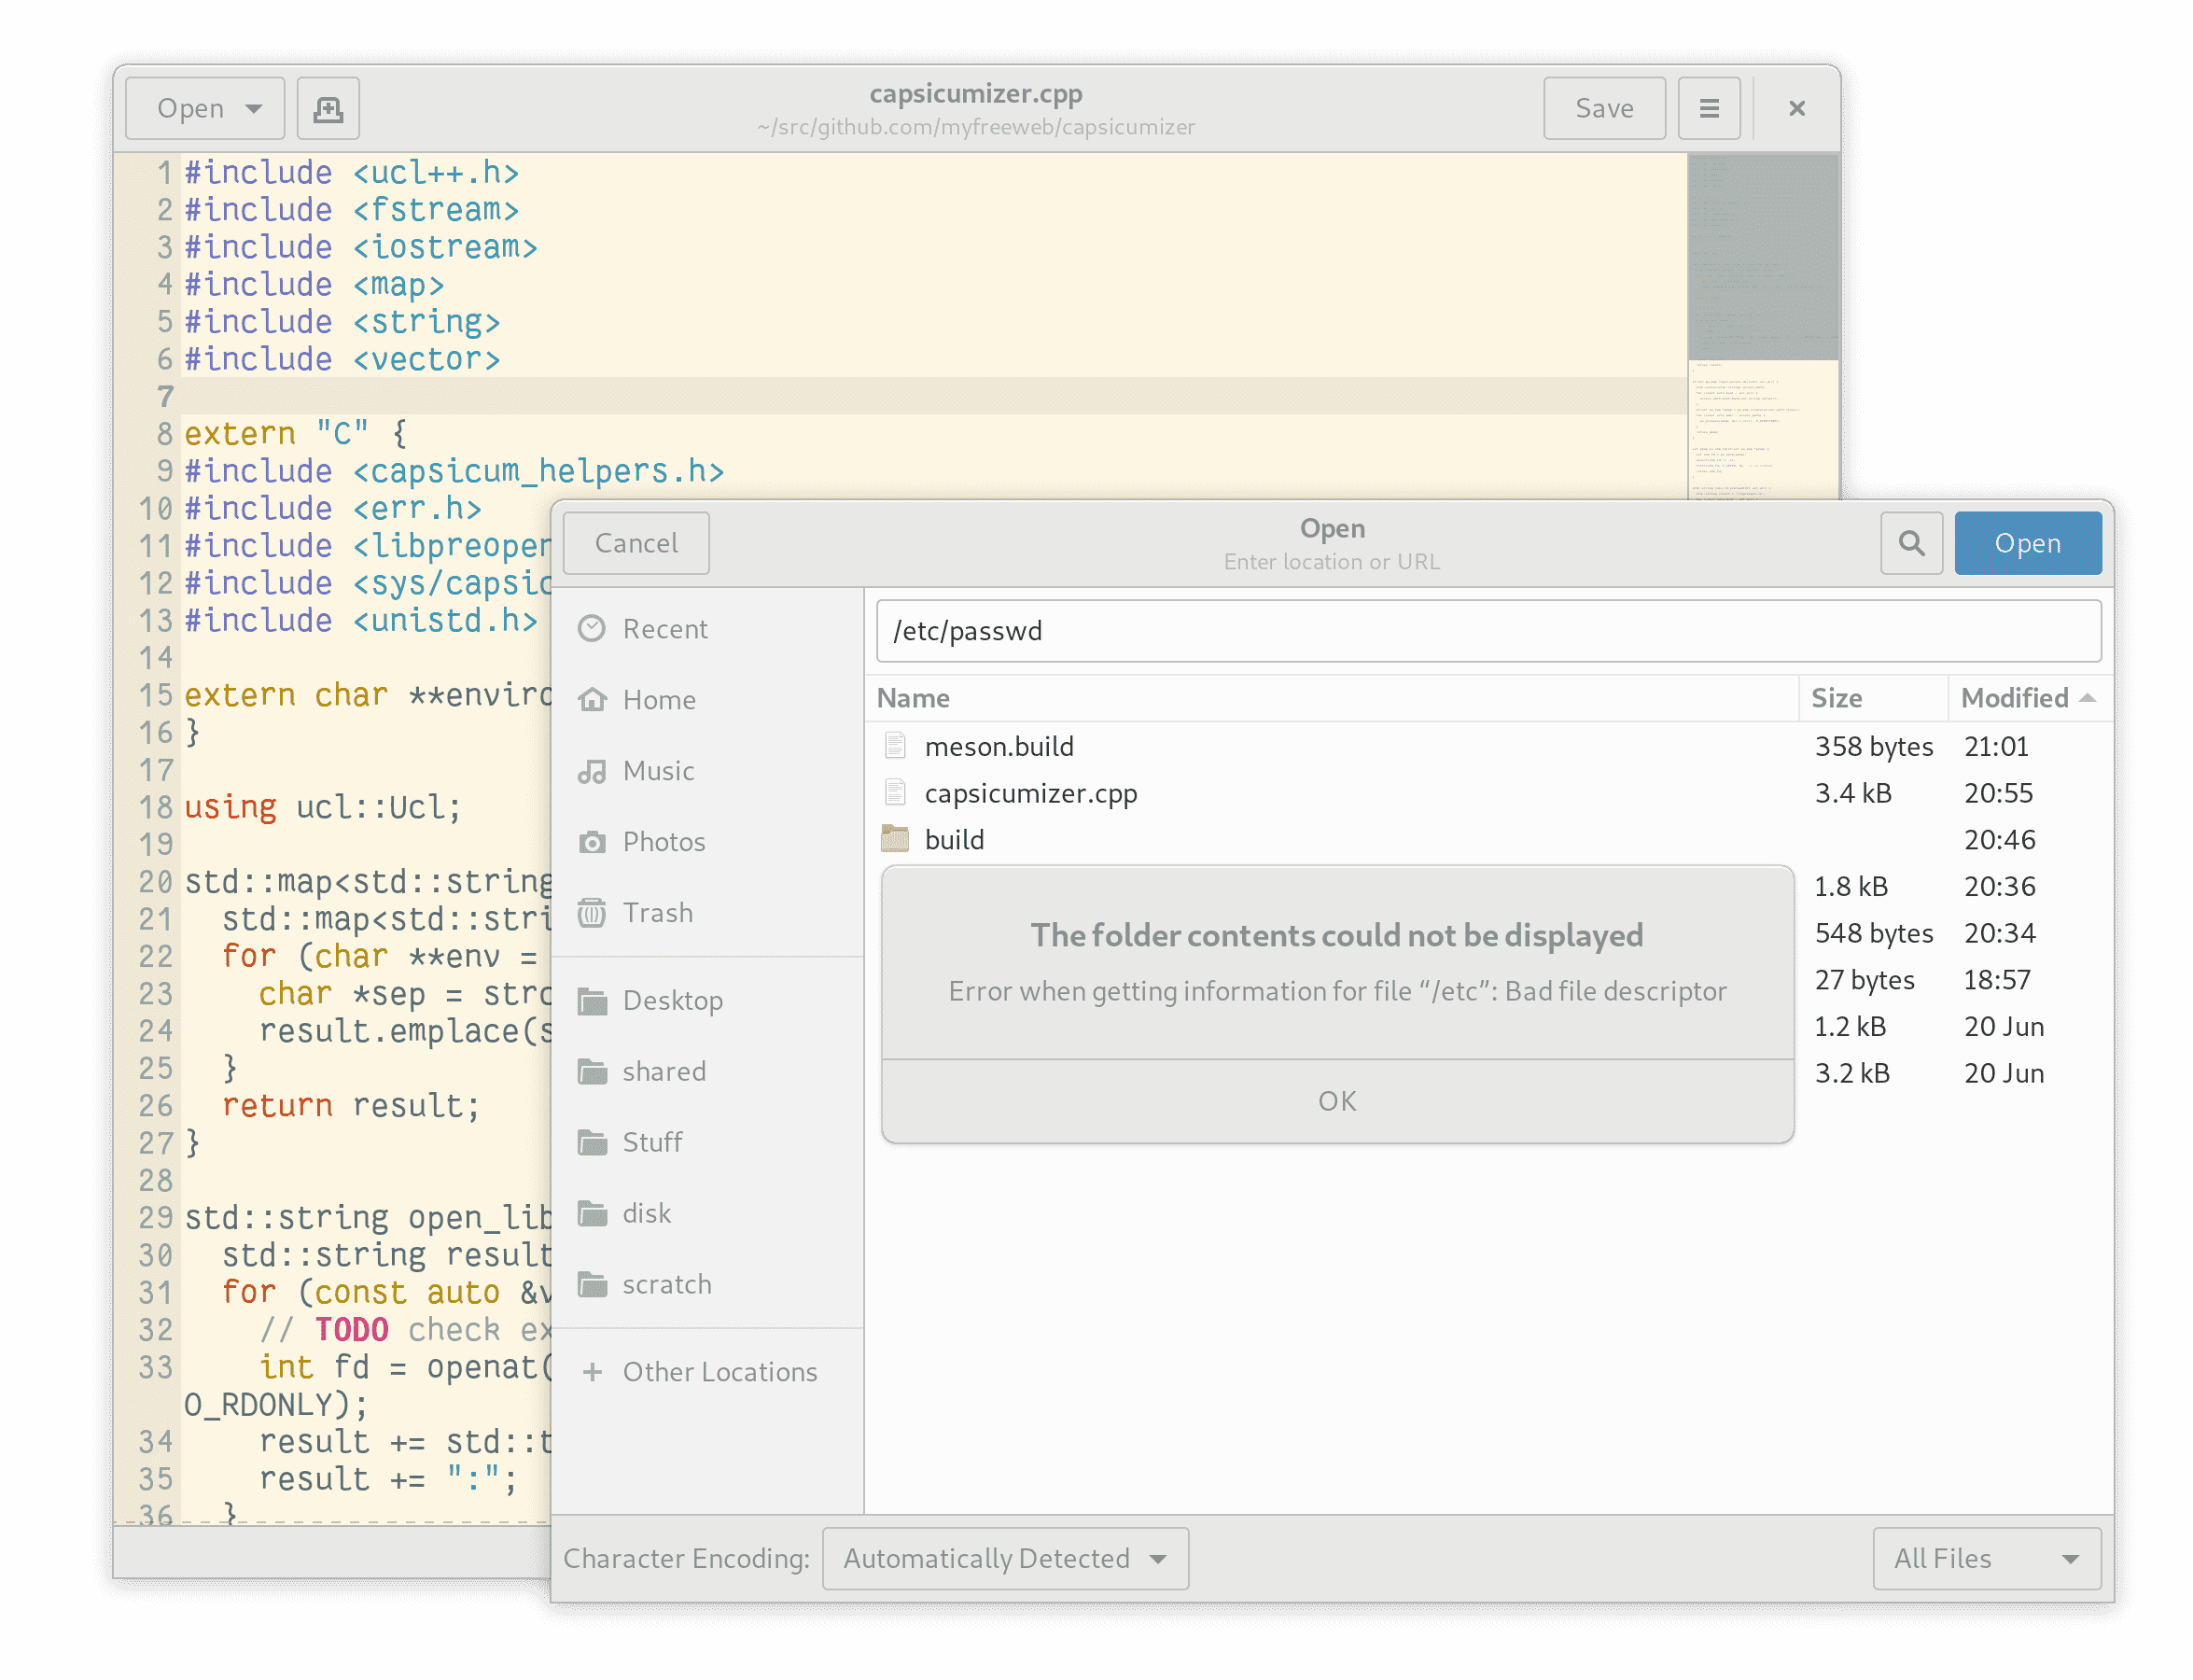
Super Capsicumizer 9000 시연: gedit에서 /etc 열기를 거부함
Super Capsicumizer 9000은 실제로 매우 작은 팀이 급히 만든 작은 실험입니다. 이 실험은 오랜 변화의 역사를 가진 복잡한 라이브러리 위에 구축된 오래된 소프트웨어를 여는 데 성공했습니다. 이는 매우 유망합니다. 주변 권한 접근을 위해 몇 개 함수만 가로채는 단 한 명의 프로그래머도 레거시 코드를 실행하는 데 성공할 수 있다는 신호입니다.
프로그래머는 시스템 호출을 직접 수행하는 일이 거의 없고, 대신 libc가 시스템 호출을 대신 수행하도록 의존합니다. 이것이 이 접근법이 잘 작동하는 이유입니다. 가로채려는 libc 함수의 정의를 작성하기만 하면 됩니다. 동적 libc에 연결한다면 여러분의 함수가 먼저 로드되어 대신 사용됩니다. 정적 libc에 연결한다면 libc 심볼은 약한 심볼일 가능성이 높으므로 정적 링커가 여러분의 정의를 보면 제거됩니다. Emilua는 Linux와 FreeBSD에서 동적 및 정적 실행 파일을 지원하기 위해 이 접근법을 사용해 왔으며, 지금까지 약한 심볼 속성이 없는 주변 권한 함수는 getaddrinfo뿐이었습니다(같은 기법 또는 Emilua를 사용해 자체 샌드박스를 만들 계획이라면 연결된 버그 보고서에 의견을 남겨 주세요).
다음 단계는 가로챌 함수를 선택하는 것입니다. FreeBSD libcasper의 함수는 좋은 첫 후보입니다. 그러나 어떤 이유로 libcasper는 대체하려는 함수를 가로채지 않으므로 이름과 매개변수를 그에 맞게 바꿔야 합니다. libcasper 함수(예: cap_getaddrinfo)는 항상 추가 매개변수를 받습니다. 가로챌 함수를 결정하는 또 다른 좋은 영감원은 Super Capsicumizer 9000이 사용하는 라이브러리인 libpreopen입니다. 복잡한 프로젝트에서도 대부분 몇 개 함수만 가로채면 됩니다.
Chromium 렌더러는 권한을 거의 필요로 하지 않습니다. 시스템에서 글꼴을 찾아 해당 글꼴 파일을 열기 위해 fontconfig에 접근할 필요가 있습니다.
— https://www.imperialviolet.org/2009/08/26/seccomp.html
Emilua 0.11은 이 모든 세부 사항을 libc_service 모듈로 추상화합니다. 아래 예제는 서브프로세스가 /dev/null을 열려고 할 때 불량 파일 디스크립터를 반환하도록 open의 동작을 이 모듈로 재정의하는 방법을 보여 줍니다. 간결성을 위해 실제 샌드박싱 설정(즉, 새 서브프로세스 안의 권한 축소)은 생략했습니다. 또한 새 서브프로세스가 실행할 Lua 코드를 가져오기 위해 파일시스템을 조회하지 않도록 코드 캐시를 미리 채우는 방법도 보여 줍니다.
local libc_service = require 'libc_service'
local stream = require 'stream'
local pipe = require 'pipe'
local fs = require 'filesystem'

local master, slave = libc_service.new()

slave.open = [[
local real_open, path, flag, mode = ...
local res, errno, fd = real_open(path, flag, mode)
if fd then
    return fd
else
    return res, errno
end
]]

local source_tree_cache = {}
source_tree_cache['a.lua'] = [[
local stream = require 'stream'
local file = require 'file'
local fs = require 'filesystem'

local f = file.stream.new()
f:open(fs.path.new('/dev/null'), {'read_only'})
f = stream.scanner.new{ stream = f }
print(f:get_line())
]]

spawn_vm{
    module = fs.path.new('/a.lua'),
    subprocess = {
        source_tree_cache = source_tree_cache,
        libc_service = slave,
        stdout = 'share',
        stderr = 'share',
    }
}

spawn(function() pcall(function()
    while true do
        master:receive()
        if master.function_ ~= 'open' then
            master:use_slave_credentials()
            goto continue
        end
        local p, f, m = master:arguments()
        if p ~= fs.path.new('/dev/null') then
            master:use_slave_credentials()
            goto continue
        end

        local pi, po = pipe.pair()
        pi = pi:release()
        spawn(function()
            stream.write_all(po, '/dev/null contents\n')
            po:close()
        end):detach()
        master:send_with_fds(-2, {pi})
        ::continue::
    end
end) end):detach()
Emilua는 두 프로세스 간 통신에 내부적으로 UNIX 소켓을 사용합니다. 이 접근법으로 완전히 동적인 보안 정책을 구현할 수 있습니다. 예를 들어 Telegram의 tdlib를 사용해 자체 Telegram 클라이언트를 구현하려 한다면 보안 정책에 다음 규칙을 둘 수 있습니다.
pluto.web.telegram.org로만 해석합니다.샌드박싱된 쪽에서 실행하도록 보내는 작은 Lua 스크립트는 호출 지점에 간단한 호출 보정을 적용하여 다룰 수 있는 사용 사례를 더 넓힐 수 있다는 뜻입니다. 예를 들어 샌드박싱된 코드가 /tmp/.X11-unix/X0에 연결해 GUI를 열려 할 때, 관련 없는 디스플레이 서버에 대한 새 파일 디스크립터를 보내고 호출 지점 Lua 스크립트의 dup2를 사용하여 원래 요청의 소켓을 새 소켓으로 바꿀 수 있습니다. 실제로 할 수 있습니다.
local libc_service = require 'libc_service'
local stream = require 'stream'
local system = require 'system'
local pipe = require 'pipe'
local unix = require 'unix'
local fs = require 'filesystem'

local preload_libc_path
do
    local pi, po = pipe.pair()
    po = po:release()
    pi = stream.scanner.new{ stream = pi }

    system.spawn{
        program = 'pkg-config',
        arguments = {'pkg-config', '--variable=libpath', 'emilua_preload_libc'},
        environment = system.environment,
        stdout = po,
    }
    po:close()

    preload_libc_path = tostring(pi:get_line())
end

local xephyrconnep
for i = 1, 20 do
    local pi, po = pipe.pair()
    po = po:release()
    pi = stream.scanner.new{ stream = pi }

    local xephyr = system.spawn{
        program = 'Xephyr',
        arguments = { 'Xephyr', ':' .. i, '-displayfd', '3' },
        environment = system.environment,
        extra_fds = {
            [3] = po,
        },
    }
    po:close()

    if pcall(function()
        local nr = tostring(pi:get_line())
        xephyrconnep = '/tmp/.X11-unix/X' .. nr
        return true
    end) then
        break
    end
end
if not xephyrconnep then
    print('Failed to start Xephyr')
    system.exit(1)
end

local master, slave = libc_service.new()

slave.connect_unix = [[
local real_connect, fd, path = ...
local res, errno, fd2 = real_connect(fd, path)
if fd2 then
    C.dup2(fd2, fd)
    C.close(fd2)
end
return res, errno
]]

local guiappenv = system.environment
guiappenv.DISPLAY = ':0'
guiappenv.LD_PRELOAD = preload_libc_path
guiappenv.EMILUA_LIBC_SERVICE_FD = '3'
local guiapp = system.spawn{
    program = 'xterm',
    arguments = { 'xterm' },
    environment = guiappenv,
    stdout = 'share',
    stderr = 'share',
    extra_fds = {
        [3] = slave,
    },
}
scope_cleanup_push(function() guiapp:wait() end)

spawn(function() pcall(function()
    while true do
        master:receive()
        if
            master.function_ == 'connect_unix' and
            (
                master:arguments() == fs.path.new('\0/tmp/.X11-unix/X0') or
                master:arguments() == fs.path.new('/tmp/.X11-unix/X0')
            )
        then
            local xephyrconn = unix.stream.dial(xephyrconnep)
            master:send_with_fds(0, {xephyrconn:release()})
        else
            master:use_slave_credentials()
        end
    end
end) end):detach()
이 예제는 Emilua가 xterm 같은 기존 프로그램에서 libc 가로채기를 수행하기 위해 LD_PRELOAD를 사용할 수 있음을 보여 주기도 합니다.
프로젝트에 유용할 수 있는 또 다른 흥미로운 접근법은 보안 정책에서 kcmp를 사용하는 것입니다. 이 기법은 각 파일 디스크립터에 서로 다른 하위 정책을 구현함으로써 정책의 세분성을 한층 더 높일 수 있게 합니다.
그런데 이제 Linux에서 openat()을 가로채 FreeBSD의 기능 모드처럼 작동하게 만들 수 있습니다(하지만 평소처럼 실제 시스템 호출을 금지하는 것을 잊지 마세요).
local libc_service = require 'libc_service'

local master, slave = libc_service.new()

slave.openat = [[
local real_openat, dirfd, path, flags, mode, resolve = ...
local res, errno, fd = real_openat(dirfd, path, flags, mode, resolve)
if fd then
    return fd
else
    return res, errno
end
]]

local worker = spawn_vm{
    module = 'module4',
    subprocess = {
        libc_service = slave,
    },
}

pcall(function()
    while true do
        master:receive()
        if master.function_ == 'openat' then
            local path, flags, mode = master:arguments()
            flags[#flags + 1] = 'resolve_beneath'
            local dirfd = master:descriptors()
            local ok, res = pcall(function()
                return dirfd:openat(path, flags, mode)
            end)
            if ok then
                master:send_with_fds(-1, {res})
            else
                master:send(-1, res)
            end
        else
            master:use_slave_credentials()
        end
    end
end)
이 기법들은 아마 여러분에게 필요한 것보다도 많지만, 공유할 요령이 몇 개 더 있으니 계속 진행하겠습니다.
샌드박스 위협 모델의 공통 주제는 처음에 신뢰했던 코드가 손상되면 악의적이 된다고 가정하는 것입니다. 예를 들어 ffmpeg 개발자가 선의이며 프로젝트에 백도어를 넣지 않았다고 신뢰할 수 있습니다. 하지만 ffmpeg는 복잡한 프로젝트이며 합법적인 버그가 발견되기만을 기다리며 숨어 있습니다. 이 버그 중 일부는 해커가 악용할 수 있습니다. 이 경우 실행 파일에 ffmpeg를 라이브러리로 가져오고 외부 데이터에 대해 ffmpeg 함수를 호출하기 직전에만 샌드박스를 설정할 수 있습니다.
그러나 코드를 처음부터 손상된 것으로 가정한다면 샌드박싱 단계를 어떻게 접근할까요? Telegram의 tdlib를 예로 들어 봅시다. tdlib를 전혀 신뢰하지 않는다고 가정해 보세요. 이 위협 모델에서는 라이브러리를 로드하는 행위조차 위험합니다. 이 시나리오에서는 먼저 안전한 환경(예: FreeBSD의 jail, Linux의 네임스페이스)에서 tdlib를 빌드해야 합니다. 빌드된 플러그인을 얻으면 다음 과제로 갈 수 있습니다.
코드를 샌드박싱하기 위해 주변 권한을 비활성화하면 dlopen()은 파일시스템에 접근하지 못합니다. 이 문제를 해결하려면 파일 디스크립터로 dlopen할 수 있습니다. FreeBSD에서는 fdlopen을 쓸 수 있습니다. Linux에서는 파일 디스크립터를 절대 닫지 않아 다른 플러그인이 경로를 재사용하지 않게 하는 한 /proc/self/fd/의 경로를 전달할 수 있습니다(glibc는 경로로 플러그인을 중복 제거합니다). 완벽한 해결책은 아니지만 시작점입니다.
이전 예제에서 정책이 파일시스템 질의를 피하도록 지시하는 Emilua 방식으로 코드 캐시 미리 채우기를 보았습니다. Emilua는 플러그인에도 같은 흐름을 따르며, 네이티브 플러그인 캐시를 미리 채울 native_modules_cache를 제공합니다.
spawn_vm{
    module = 'some_module',
    subprocess = {
        native_modules_cache = {
            'some_plugin'
        } } }
플러그인의 가장 큰 문제는 아직 로드되지 않은 동적 라이브러리에 의존할 수 있으며 dlopen이 이를 로드하지 못한다는 점입니다. 이전 절에서 본 libc-service의 우회책을 써볼 수 있지만, 이 문제에는 더 깔끔한 해결책이 있습니다. Linux에서는 Landlock을 사용하면 됩니다. 어차피 /proc/self/fd/ 요령에도 Landlock이 필요합니다. FreeBSD에서는 rtld_set_var와 LIBRARY_PATH_FDS를 사용할 수 있습니다.
spawn_vm{
    module = 'some_module',
    subprocess = {
        native_modules_cache = {
            'some_plugin'
        },
        ld_library_directories = library_path_fds,
    } }
다행히 Tdlib에서는 이를 걱정할 필요가 없으므로 코드가 조금 간단해집니다. 그러나 다음 질문이 생깁니다. tdlib를 신뢰하지 않는다면 어쨌든 왜 데이터는 신뢰하는가? 여기서의 질문은 위협 모델 자체가 타당한지 평가하는 것입니다. tdlib의 경우 tdlib 개발자(Telegram 개발자)에게 그들이 이미 갖지 않은 것은 아무것도 주지 않습니다(Telegram 서버의 데이터). 플러그인 안에서 tdlib를 실행하면 Telegram 회사가 시스템의 데이터에 제한 없이 접근하는 것을 막을 수 있습니다. tdlib의 답은 간단할 수 있지만, 이 이야기에서 중요한 것은 그것이 아닙니다. 여기서 얻어야 할 교훈은 위협 모델이 타당한지 평가해야 한다는 것입니다.
다른 위협 모델 이야기를 살펴봅시다. Linux 커널은 압축된 initramfs 이미지를 로드할 수 있습니다. Linux 커널이 initramfs 이미지를 압축 해제하기 위해 잘 알려진 익스플로잇으로 가득한 버그 많은 유지 관리되지 않는 라이브러리를 사용하더라도 전혀 중요하지 않습니다! 이 라이브러리는 신뢰할 수 있는 사용자가 생성한 데이터에만 사용합니다. 적대적 행위자가 우리가 로드하는 initramfs 이미지를 제어했다면 압축 해제 라이브러리에 악용 가능한 버그가 하나도 없더라도 이미 원하는 모든 피해를 줄 수 있었습니다. 그러나 라이브러리에 백도어가 있었다면 이야기는 완전히 달라집니다. 때로는 확실히 신뢰할 수 없는 사람이 작성한 겉보기에는 더 나은 코드보다 신뢰할 수 있는 개인이 작성한 감사 가능한 코드가 더 중요합니다.
이 절은 가능한 한 오래 미뤘습니다. 끔찍하기 때문입니다. Seccomp는 재량적 권한 축소를 위한 좋은 메커니즘이 아닙니다. Seccomp는 운영체제 강화에 좋은 메커니즘입니다. Seccomp는 BPF 프로그램에 기반한 간단한 프로그래밍 가능 시스템 호출 필터링 메커니즘입니다. BPF 프로그램은 프로세스가 시도하는 각 시스템 호출에 대해 동작을 선택해야 합니다.
SECCOMP_RET_KILL_PROCESS.SECCOMP_RET_KILL_THREAD.SECCOMP_RET_TRAP.SECCOMP_RET_ERRNO.SECCOMP_RET_USER_NOTIF.SECCOMP_RET_TRACE.SECCOMP_RET_LOG.SECCOMP_RET_ALLOW.이 메커니즘은 이름에서 동작하는 시스템 호출(예: open, bind)을 허용하지 않음으로써 주변 권한에 대한 접근을 거부하는 데 사용할 수 있습니다(예: SECCOMP_RET_ERRNO). 주변 권한을 비활성화하기만 하면 프로세스는 제대로 샌드박싱되며, 이전 절에서 배운 구획화된 애플리케이션 개발의 교훈을 사용할 수 있습니다. 이 메커니즘으로 허용 목록이나 차단 목록을 구현할 수 있습니다. 다음 프로젝트는 시스템 호출 차단 목록을 구현합니다.
차단 목록의 문제는 잘 알려져 있습니다. 새 커널 버전은 새 시스템 호출을 추가할 수 있습니다. 오늘은 내일 어떤 시스템 호출이 추가될지 모릅니다. 오늘은 내일의 시스템 호출이 오늘의 정책을 깨뜨릴지 모릅니다. 하지만 seccomp에서는 문제가 더 나쁩니다. Linux는 다중 아키텍처 시스템을 허용하며 시스템 호출 번호는 아키텍처마다 크게 다릅니다. x86-64 프로그램에서 acct 같은 시스템 호출을 막더라도, 손상된 샌드박스는 x86 실행 파일을 실행하여 시스템 호출 필터를 우회할 수 있습니다. 즐겁게도 Linux는 어떻게든 문제를 더 나쁘게 만듭니다.
arch필드는 모든 호출 규약에 대해 고유하지 않습니다. x86-64 ABI와 x32 ABI는 둘 다 arch로AUDIT_ARCH_X86_64를 사용하고, 같은 프로세서에서 실행됩니다. 대신 시스템 호출 번호의 마스크__X32_SYSCALL_BIT가 두 ABI를 구분하는 데 사용됩니다.즉, 정책은
X32_SYSCALL_BIT가 있는 모든 시스템 호출을 거부하거나,X32_SYSCALL_BIT가 설정된 시스템 호출과 설정되지 않은 시스템 호출을 모두 인식해야 합니다.nr에 기반해 거부할 시스템 호출 목록에X32_SYSCALL_BIT가 설정된nr값도 없으면, 악의적인 프로그램이X32_SYSCALL_BIT를 설정하여 우회할 수 있습니다.
허용 목록으로 옮기더라도 이런 구현 세부 사항은 계속 따라다닙니다. 다음은 허용 목록에 기반한 주목할 만한 프로젝트 몇 가지입니다.
자체 seccomp 정책을 구현하기 위해 이 목록들을 살펴보고 나면 또 다른 문제를 만납니다. Linux 시스템 호출 매개변수 순서는 아키텍처마다 바뀝니다. Docker가 시스템 호출 clone에 여러 규칙을 사용하는 이유가 이것입니다. FreeBSD 사용자는 cap_enter()만 호출해서 10초 만에 하는 일을 하려면 왜 Linux 시스템 호출 규약 전문가가 되어야 할까요? Linux에 오신 것을 환영합니다.
좋은 소식은 이론상 주변 권한을 비활성화하는 단 하나의 함수를 가진 라이브러리를 구현할 수 있고, 그러면 모두가 이 라이브러리를 사용하게 된다는 점입니다. 이 라이브러리를 구현할 몇 가지 아이디어가 있지만, 지금까지 제 고객 중 이 문제에 관심 있는 고객은 없었습니다(동시에 저는 다른 프로젝트로 바쁩니다).
그러나 명심해야 할 주의 사항이 하나 더 있습니다. Linux 사용자 공간은 파일시스템에 지나치게 의존합니다. 레거시 코드와의 호환성을 위해 open을 가로채더라도 중첩 샌드박스가 작동할 때 레거시 코드는 /proc/self에 접근하려다 실패합니다. open을 허용하고 대신 Landlock으로 파일시스템 접근을 필터링하는 것이 더 낫습니다. 이제 문제는 프로세스가 다른 mode로 /proc/self/fd/를 다시 열 수 있다면 파일 디스크립터를 기능으로 모델링할 수 없다는 것입니다. Landlock 개발자는 Capsicum과 호환되는 기능을 노출하는 장기 목표를 공유했으므로, 어쩌면 미래에 이 문제의 해결책을 얻을 수 있을 것입니다.
Seccomp의 복잡성은 구획화된 애플리케이션 개발자를 낙담시킬 수 있지만, Linux 네임스페이스를 살펴보면 상황은 훨씬 나쁩니다. Linux에서 우리가 가진 것은 Seccomp + Landlock입니다.
Kafel은 시스템 호출 필터링 정책을 지정하기 위한 언어 및 라이브러리입니다. 정책은 seccomp-filter와 함께 쓸 수 있는 BPF 코드로 컴파일됩니다.
— https://google.github.io/kafel/
Kafel은 제가 찾아다니며 본 Seccomp 정책 재사용을 가능하게 할 가장 유망한 프로젝트입니다. Kafel을 사용하여 여러분이 관심을 가질 수 있는 몇 가지 정책 그룹을 정의할 수 있었습니다.
Kafel 정책
// These policies are heavily influenced by Docker's default profile. Further
// customization done on top:
//
// - Avoid syscalls that need root anyway. The policies here are mostly meant to
//   be used by unprivileged users (not containers with root inside). The
//   syscalls wouldn't be harmful, but would result in larger BPF programs that
//   in turn incur more overhead.
// - Avoid rarely used syscalls that can be abused for yet more fingerprinting
//   on desktop applications. This category mostly contains syscalls useful for
//   profiling (e.g. mincore, cachestat).
// - Split them into categories inspired by systemD's seccomp filter sets and
//   OpenBSD's pledge promises.

POLICY Aio {
    ALLOW {
        io_cancel, io_destroy, io_getevents, io_pgetevents, io_setup, io_submit
    }
}

POLICY BasicIo {
    ALLOW {
        read, readv, tee, vmsplice, write, writev,

        // ioctl() is definitively not about generic/stream/basic I/O. ioctl()
        // is really a syscall in disguise that device drivers can use for
        // anything. However it's expected that any program doing file I/O or
        // socket I/O or TTY IO will eventually stumble on glibc using ioctl()
        // for some operations so let's go ahead and just include it in the
        // basic IO set to force other IO categories to include it too.
        ioctl
    }
}

POLICY Clock {
    ALLOW {
        clock_getres, clock_gettime, gettimeofday, time, times
    }
}

// Compat quirks. This family of policies is a good candidate to be maintained
// in a different repo.
POLICY CompatX86 {
    ALLOW {
        // important for old ABI emulation
        personality(persona) {
            persona == /*PER_LINUX=*/0 || persona == /*PER_LINUX32=*/8 ||
            persona == /*UNAME26=*/0x0020000 ||
            persona == /*PER_LINUX32|UNAME26=*/0x20008 ||
            persona == 0xffffffff
        },

        // Important for x86 family's ABI. We put it in here instead of
        // c-runtime because other archs don't need it. Ideally Kafel would
        // allow us to write arch_prctl@amd64 in c-runtime and the rule would
        // only be included when we're building for the amd64 arch.
        arch_prctl
    }
}

POLICY CompatDB32 { ALLOW { remap_file_pages } }
POLICY CompatSystemd { ALLOW { name_to_handle_at } }
POLICY CompatWine { ALLOW { modify_ldt } }
POLICY Credentials { ALLOW { getegid, geteuid, getgid, getgroups, getresgid, getresuid, getuid } }
POLICY CredentialsExtra { ALLOW { capget } }
POLICY CredentialsMutation { ALLOW { capset, setfsgid, setfsuid, setgid, setgroups, setregid, setresgid, setresuid, setreuid, setuid } }

POLICY CRuntime {
    ALLOW {
        brk, exit, exit_group, futex, futex_requeue, futex_wait, futex_waitv,
        futex_wake, get_robust_list, get_thread_area, gettid, madvise,
        map_shadow_stack, membarrier, mmap, mprotect, mremap, munmap,
        restart_syscall, rseq, sched_yield, set_robust_list, set_thread_area,
        set_tid_address, getrandom
    }
}

POLICY Debug { ALLOW { kcmp, pidfd_getfd, perf_event_open, process_madvise, process_mrelease, process_vm_readv, process_vm_writev, ptrace } }
POLICY FileDescriptors { ALLOW { close, close_range, dup, dup2, dup3, fcntl } }
POLICY FileIo { ALLOW { copy_file_range, fadvise64, fallocate, flock, ftruncate, lseek, pread64, preadv, preadv2, pwrite64, pwritev, pwritev2, readahead, sendfile, splice } }
POLICY Filesystem { ALLOW { access, chdir, creat, faccessat, faccessat2, fchdir, fgetxattr, flistxattr, fstat, fstatfs, getcwd, getdents, getdents64, getxattr, inotify_add_watch, inotify_init, inotify_init1, inotify_rm_watch, lgetxattr, link, linkat, listxattr, llistxattr, lstat, mkdir, mkdirat, mknod, mknodat, newfstatat, open, openat, openat2, readlink, readlinkat, rename, renameat, renameat2, rmdir, stat, statfs, statx, symlink, symlinkat, truncate, umask, unlink, unlinkat } }
POLICY FilesystemAttr { ALLOW { chmod, chown, fchmod, fchmodat, fchmodat2, fchown, fchownat, fremovexattr, fsetxattr, futimesat, lchown, lremovexattr, lsetxattr, removexattr, setxattr, utime, utimensat, utimes } }
POLICY IoEvent { ALLOW { epoll_create, epoll_create1, epoll_ctl, epoll_ctl_old, epoll_pwait, epoll_pwait2, epoll_wait, epoll_wait_old, eventfd, eventfd2, poll, ppoll, pselect6, select } }
POLICY IoUring { ALLOW { io_uring_enter, io_uring_register, io_uring_setup } }
POLICY Ipc { ALLOW { memfd_create, mq_getsetattr, mq_notify, mq_open, mq_timedreceive, mq_timedsend, mq_unlink, msgctl, msgget, msgrcv, msgsnd, pipe, pipe2, semctl, semget, semop, semtimedop, shmat, shmctl, shmdt, shmget } }
POLICY Memlock { ALLOW { memfd_secret, mlock, mlock2, mlockall, munlock, munlockall } }
POLICY NetworkIo { ALLOW { connect, getpeername, getsockname, getsockopt, recvfrom, recvmmsg, recvmsg, sendmmsg, sendmsg, sendto, setsockopt, shutdown } }
POLICY NetworkServer { ALLOW { accept, accept4, bind, listen } }
POLICY NetworkSocketTcp { ALLOW { socket(domain, type, protocol) { (type & 0x7ff) == /*SOCK_STREAM=*/1 && protocol == 0 && (domain == /*AF_INET=*/2 || domain == /*AF_INET6=*/10) } } }
POLICY NetworkSocketUdp { ALLOW { socket(domain, type, protocol) { (type & 0x7ff) == /*SOCK_DGRAM=*/2 && protocol == 0 && (domain == /*AF_INET=*/2 || domain == /*AF_INET6=*/10) } } }
POLICY NetworkSocketUnix { ALLOW { socket(domain, type, protocol) { domain == /*AF_UNIX=*/1 && protocol == 0 }, socketpair(domain, type, protocol) { domain == /*AF_UNIX=*/1 && protocol == 0 } } }
POLICY Pkey { ALLOW { pkey_alloc, pkey_free, pkey_mprotect } }
POLICY Process { ALLOW { clone, clone3, execve, execveat, fork, getpgid, getpgrp, getpid, getppid, getrusage, getsid, kill, pidfd_open, pidfd_send_signal, prctl, rt_sigqueueinfo, rt_tgsigqueueinfo, setpgid, setsid, tgkill, tkill, vfork, wait4, waitid } }
POLICY Resources { ALLOW { getcpu, getpriority, getrlimit, ioprio_get, sched_getaffinity, sched_getattr, sched_getparam, sched_get_priority_max, sched_get_priority_min, sched_getscheduler, sched_rr_get_interval } }
POLICY ResourcesMutation { ALLOW { ioprio_set, prlimit64, sched_setaffinity, sched_setattr, sched_setparam, sched_setscheduler, setpriority, setrlimit } }
POLICY Sandbox { ALLOW { landlock_add_rule, landlock_create_ruleset, landlock_restrict_self, seccomp } }
POLICY Signal { ALLOW { pause, rt_sigaction, rt_sigpending, rt_sigprocmask, rt_sigreturn, rt_sigsuspend, rt_sigtimedwait, sigaltstack, signalfd, signalfd4 } }
POLICY Sync { ALLOW { fdatasync, fsync, msync, sync, sync_file_range, syncfs } }
POLICY Timer { ALLOW { alarm, getitimer, clock_nanosleep, nanosleep, setitimer, timer_create, timer_delete, timer_getoverrun, timer_gettime, timer_settime, timerfd_create, timerfd_gettime, timerfd_settime } }
이것들은 거의 1년 동안 제가 사용해 온 정책입니다. 지금이라면 몇 가지를 바꾸겠지만 아직 그럴 시간이 없었습니다. 또한 Kafel의 시스템 호출 데이터베이스는 변명의 여지 없이 빈약하므로 위 코드를 작동시키려면 몇 가지 변경(시스템 호출 이름을 번호로 바꾸는 sed 같은 전처리)이 필요하다는 점을 유의하세요. 작동하더라도 Docker처럼 더 나은 시스템 호출 데이터베이스를 사용하는 프로젝트가 처리하는 많은 시스템 호출을 빠뜨립니다. clock_gettime64를 언급하지 않는 것을 보셨나요? Kafel의 시스템 호출 데이터베이스가 너무 빈약하기 때문입니다. Kafel은 이처럼 빈약한 시스템 호출 데이터베이스와 빈약한 다중 아키텍처 지원을 유지하는 한 Docker 같은 프로젝트에 절대 채택되지 않을 것입니다.
그러나 더 나은 시스템 호출 데이터베이스의 부재만이 Kafel에서 개선할 수 있는 것은 아닙니다. 예를 들어 정책 버전 관리와 더 나은 정책 조합 연산자를 보고 싶습니다. 이런 기능을 개발할 의향은 있지만, 다시 말해 현재 제 고객 중 누구도 이 프로젝트에 관심이 없으므로 제 시간은 다른 프로젝트에 쓰일 것입니다.
이 글에서는 Linux와 FreeBSD의 샌드박싱 기초를 조금 넘어서 다루었습니다. 하지만 공유하고 싶은 교훈이 더 있습니다. 이것들은 나중의 글을 위해 남겨 두겠습니다. 다시 블로그 글을 쓸 기분이 든다면 다룰 법한 주제는 다음과 같습니다.
PR_SET_DUMPABLE&/proc/sys/kernel/yama/ptrace_scope.© 2024 Emilua
