벡터 데이터베이스와 Qdrant의 핵심 개념, 장점 및 아키텍처를 알아봅니다.
벡터 데이터베이스는 딥러닝 아키텍처와 같은 불투명한 머신러닝 모델에서 파생된 추상적 데이터 표현과 상호작용하기 위한 비교적 새로운 방식입니다. 이러한 표현은 흔히 벡터 또는 임베딩이라고 하며, 감성 분석, 음성 인식, 객체 감지 등과 같은 작업을 수행하도록 머신러닝 모델을 학습하는 데 사용된 데이터를 압축한 버전입니다.
이러한 새로운 데이터베이스는 시맨틱 검색 및 추천 시스템과 같은 다양한 애플리케이션에서 뛰어난 성능을 발휘합니다. 여기에서는 시장에서 가장 인기 있고 빠르게 성장하는 벡터 데이터베이스 중 하나인 Qdrant에 대해 알아보겠습니다.
Qdrant는 추가 페이로드와 함께 포인트, 즉 벡터를 저장, 검색, 관리할 수 있는 편리한 API를 갖춘 프로덕션 준비 완료 벡터 유사도 검색 엔진입니다. 페이로드는 검색 범위를 좁히고 사용자에게 제공할 유용한 정보를 받는 데 도움이 되는 추가 정보 조각으로 생각할 수 있습니다.
Python qdrant-client를 사용하거나 최신 qdrant 도커 이미지를 내려받아 로컬에서 연결하거나, 완전히 전환할 준비가 될 때까지 Qdrant Cloud의 무료 티어 옵션을 사용해 Qdrant를 시작할 수 있습니다.
이제 벡터 데이터베이스가 무엇인지 알아보겠습니다.
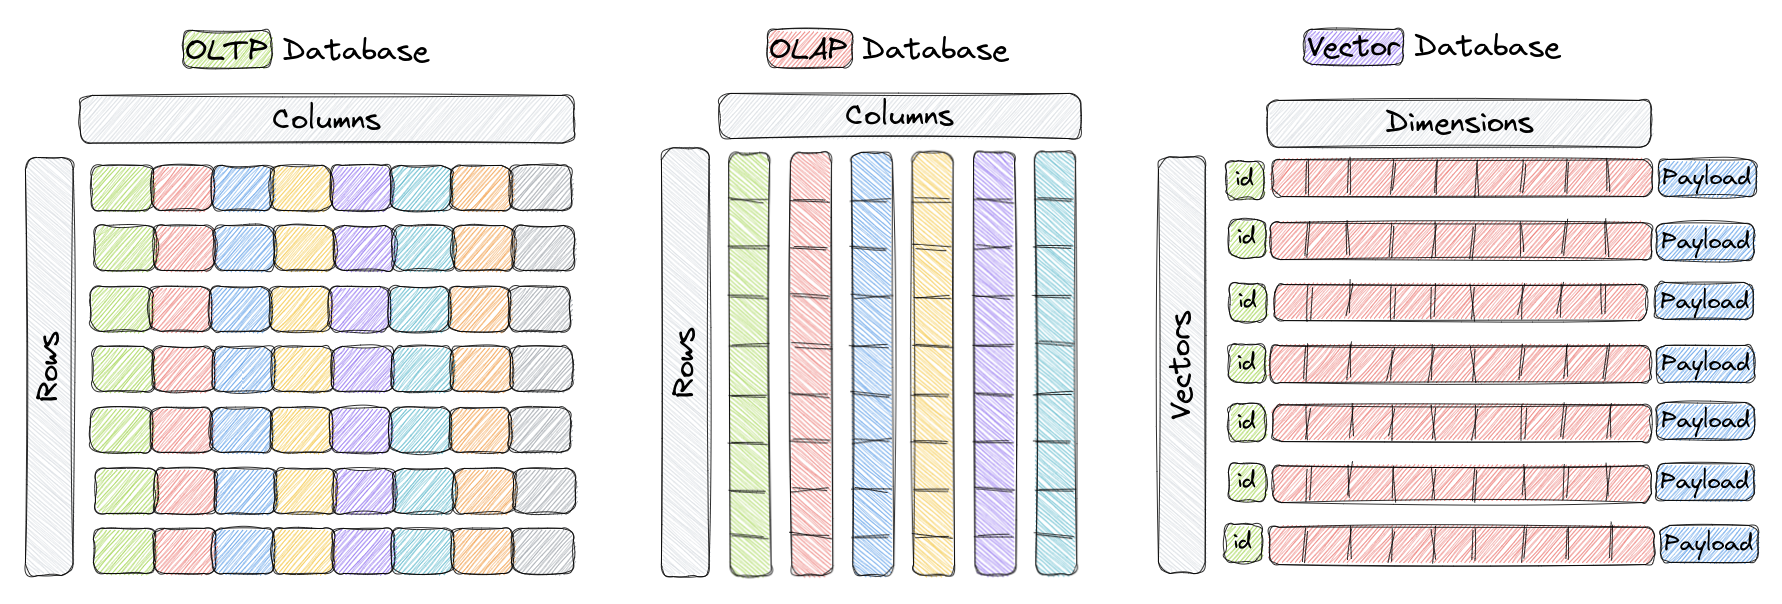
벡터 데이터베이스는 고차원 벡터를 효율적으로 저장하고 쿼리하도록 설계된 데이터베이스 유형입니다. 기존 OLTP 및 OLAP 데이터베이스에서는, 위 이미지에서 볼 수 있듯이, 데이터가 행과 열로 구성되며 이를 테이블이라고 합니다. 쿼리는 이러한 열의 값을 기준으로 수행됩니다. 그러나 이미지 인식, 자연어 처리, 추천 시스템 등의 특정 애플리케이션에서는 데이터가 고차원 공간의 벡터로 표현되는 경우가 많습니다. 이러한 벡터에 ID와 페이로드를 더한 것을 포인트라고 합니다. 이 포인트는 Qdrant와 같은 벡터 데이터베이스 내에서 컬렉션이라고 하는 곳에 저장하는 요소입니다.
이 맥락에서 벡터는 객체 또는 데이터 포인트의 수학적 표현이며, 벡터의 요소는 암시적으로 또는 명시적으로 객체의 특정 특징이나 속성에 대응합니다. 예를 들어 이미지 인식 시스템에서 벡터는 이미지를 나타낼 수 있으며, 벡터의 각 요소는 픽셀 값 또는 해당 픽셀의 기술자나 특성을 나타냅니다. 음악 추천 시스템에서는 각 벡터가 노래를 나타낼 수 있고, 벡터의 요소는 템포, 장르, 가사 등의 노래 특성을 포착합니다.
벡터 데이터베이스는 이러한 고차원 벡터를 효율적으로 저장하고 쿼리하도록 최적화되어 있으며, 계층적 탐색 가능 소형 세계(HNSW)와 같은 특수한 데이터 구조 및 인덱싱 기법을 흔히 사용합니다. HNSW는 근사 최근접 이웃을 구현하는 데 사용됩니다. 그 밖에 곱 양자화도 사용됩니다. 이러한 데이터베이스는 빠른 유사도 및 시맨틱 검색을 지원하며, 사용자는 일부 거리 측정값을 기준으로 주어진 쿼리 벡터에 가장 가까운 벡터를 찾을 수 있습니다. 가장 일반적으로 사용되는 거리 측정값은 유클리드 거리, 코사인 유사도, 내적이며, Qdrant는 이 세 가지를 모두 완전히 지원합니다.
다음은 이 세 가지의 간략한 개요입니다.
이제 벡터 데이터베이스가 무엇이며 다른 데이터베이스와 구조적으로 어떻게 다른지 알았으므로, 왜 중요한지 살펴보겠습니다.
벡터 데이터베이스는 추천 시스템, 콘텐츠 기반 이미지 검색, 개인화된 검색 등 유사도 검색이 필요한 다양한 애플리케이션에서 중요한 역할을 합니다. 효율적인 인덱싱 및 검색 기법을 활용해, 벡터 데이터베이스는 이미 벡터로 표현된 비정형 데이터를 더 빠르고 정확하게 검색할 수 있도록 하며, 사용자의 쿼리와 가장 관련성 높은 결과를 사용자에게 제공하는 데 도움이 됩니다.
또한 벡터 데이터베이스 사용의 다른 이점은 다음과 같습니다.
벡터 데이터베이스 사용의 구체적인 이점은 조직의 사용 사례와 최종적으로 선택하는 데이터베이스의 기능에 따라 달라질 수 있다는 점에 유의하세요.
이제 Qdrant의 아키텍처를 높은 수준에서 살펴보겠습니다.
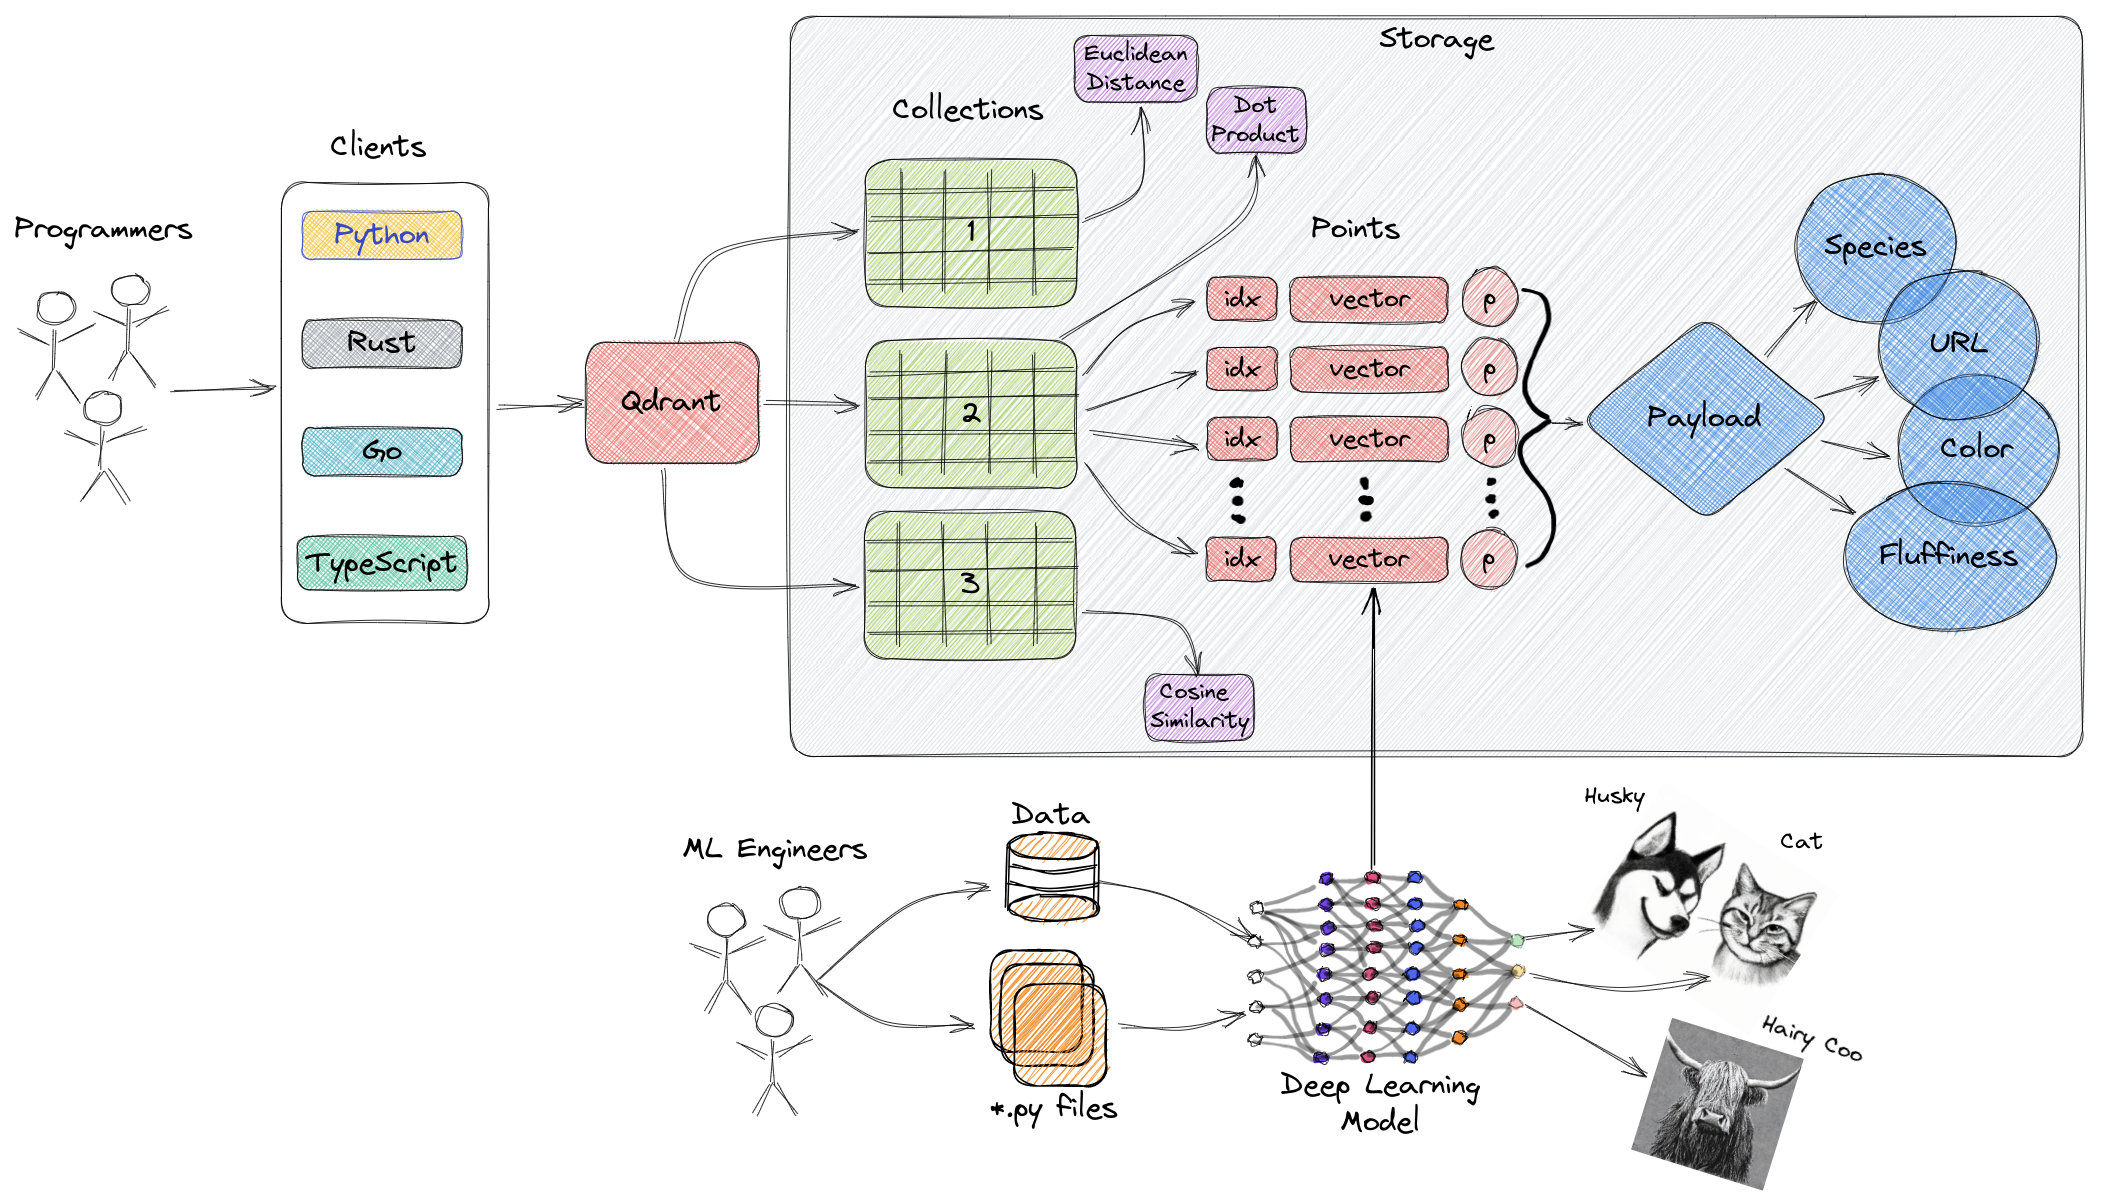
위 다이어그램은 Qdrant의 주요 구성 요소 일부를 높은 수준에서 보여 줍니다. 익숙해져야 할 용어는 다음과 같습니다.
컬렉션: 컬렉션은 검색할 수 있는 포인트, 즉 페이로드가 있는 벡터의 이름이 지정된 집합입니다. 같은 컬렉션 내의 모든 포인트 벡터는 동일한 차원을 가져야 하며 하나의 측정값으로 비교되어야 합니다. 이름이 지정된 벡터를 사용하면 하나의 포인트에 여러 벡터를 둘 수 있으며, 각 벡터는 자체적인 차원 및 측정값 요구 사항을 가질 수 있습니다.
거리 측정값: 벡터 간 유사도를 측정하는 데 사용되며, 컬렉션을 생성할 때 선택해야 합니다. 측정값의 선택은 벡터를 얻은 방식, 특히 새 쿼리를 인코딩하는 데 사용할 신경망에 따라 달라집니다.
포인트: 포인트는 Qdrant가 다루는 핵심 엔터티이며, 벡터와 선택적 ID 및 페이로드로 구성됩니다.
스토리지: Qdrant는 데이터를 디스크에 영속적으로 저장하며, 그중 어느 정도를 메모리에도 유지할지 선택할 수 있습니다. 자주 사용되는 데이터를 RAM에 완전히 유지하려면 pinned, 디스크 캐시를 따뜻하게 유지하려면 cached, 대규모 데이터세트에서 RAM을 절약하려면 cold를 사용합니다.
클라이언트: Qdrant에 연결하는 데 사용할 수 있는 프로그래밍 언어입니다.
이제 벡터 데이터베이스와 Qdrant에 대해 더 잘 알게 되었으므로, 튜토리얼 중 하나를 시작할 준비가 되었습니다. 벡터 데이터베이스를 한 번도 사용해 본 적이 없다면 시작하기 섹션으로 바로 이동하세요. 반대로 이러한 기술 분야의 숙련된 개발자라면 사용 사례와 가장 관련 있는 섹션으로 이동하세요.
튜토리얼을 진행하다 질문이 생기면 여기의 Discord 채널에서 알려 주세요. 😎
