Visual C++ 컴파일러에서 C++ 소스 코드가 최종 바이너리 프로그램으로 변환되는 데이터 흐름과 최적화 과정을 개괄적으로 설명합니다.
이 블로그 시리즈를 중간부터 읽기 시작했다면, 대신 처음부터 시작하는 것이 좋을 수 있습니다.
이 글에서는 C++ 소스 프로그램에서 시작해 그에 대응하는 바이너리 프로그램으로 끝나는 Visual C++ 컴파일러 내부의 데이터 흐름을 설명합니다. 이 글은 쉬운 글입니다. 바다의 얕은 곳에 발을 담그는 정도입니다.
명령줄에서 App.cpp에 저장된 단일 파일 프로그램을 컴파일할 때 어떤 일이 일어나는지 살펴보겠습니다. (Visual Studio 안에서 컴파일을 시작한다면 아래 다이어그램에는 더 상위 수준의 소프트웨어 계층도 포함되어야 합니다. 하지만 결국 이들은 지금부터 설명할 바로 그 명령을 내보냅니다.)
그러면 방금 다음과 같이 입력했다고 가정해 봅시다: CL /O2 App.cpp
CL은 “Compile and Link”의 약자입니다. /O2는 컴파일러에 속도를 위해 최적화하라고 지시합니다. 즉, 가능한 한 빠르게 실행되는 기계어 코드를 생성하라는 뜻입니다. 이 명령은 여러 소프트웨어 구성 요소를 호출하는 “드라이버”인 CL.EXE 프로그램을 실행하는 프로세스를 시작합니다. 이 구성 요소들은 함께 App.cpp의 텍스트를 처리하고, 궁극적으로 App.exe라는 바이너리 파일을 생성합니다. 실행하면 이 바이너리는 원래 소스 파일에 지정한 작업을 수행합니다.
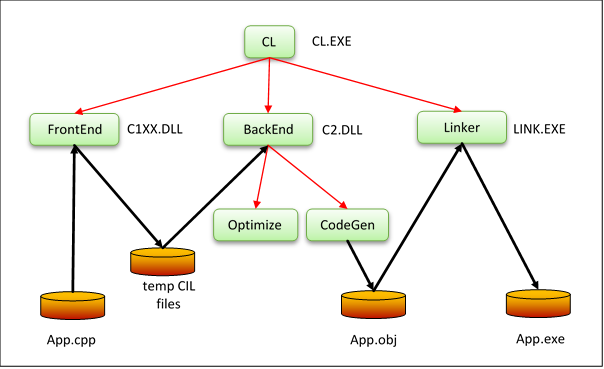
위 다이어그램을 둘러보며 무슨 일이 일어나는지 설명해 보겠습니다.
CL.EXE는 명령줄을 구문 분석하고 타당한지 확인합니다. 이어서 C1XX.DLL에 있는 C++ “프런트 엔드”를 호출합니다. (“CXX”는 “C++”를 연상시키기 위한 이름이지만, 파일 이름에 “+”가 허용되지 않던 시절로 거슬러 올라갑니다.) 프런트 엔드는 C++ 언어를 이해하는 체인의 구성 요소입니다. 프런트 엔드는 App.cpp를 검사하고, 구문 분석하고, 동등한 트리로 변환한 뒤 5개의 임시 파일을 통해 다음 구성 요소에 전달합니다. 이 5개 파일로 표현되는 “언어”는 “C Intermediate Language”의 약자인 “CIL”이라고 합니다. 이를 C# 같은 관리형 언어가 생성하는 중간 코드와 혼동하지 마십시오. 이 코드는 때때로 “MSIL”이라고 불리지만, 안타깝게도 ECMA-335 표준에서는 역시 “CIL”이라는 이름을 사용합니다.
다음으로 CL.EXE는 C2.DLL에 있는 “백 엔드”를 호출합니다. 우리는 백 엔드를 “Universal Tuple Compiler”의 약자인 “UTC”라고 부릅니다. 다만 이 이름은 Visual Studio에 포함된 어떤 바이너리에도 나타나지 않습니다. 백 엔드는 프런트 엔드의 정보를 튜플, 즉 명령의 바이너리 스트림으로 변환하는 것으로 시작합니다. 이를 표시한다면 일종의 고수준 어셈블리 언어처럼 보일 것입니다. 다음과 같은 의미에서 고수준입니다.
/O2 스위치를 통해 컴파일러에 속도 최적화를 요청했으므로, 백 엔드의 Optimize 부분은 튜플을 분석하고 더 빠르게 실행되지만 의미적으로는 동등한, 즉 원래 튜플과 같은 결과를 내는 형태로 변환합니다. 이 단계가 끝나면 튜플은 백 엔드의 CodeGen 부분으로 전달되고, 이 부분이 내보낼 최종 바이너리 코드를 결정합니다.
CodeGen 모듈은 디스크의 파일로 App.obj를 내보냅니다. 마지막으로 링커는 이 파일을 받아 라이브러리에 대한 모든 참조를 해결하고 최종 App.exe 바이너리를 생성합니다.
다이어그램에서 검은색 화살표는 텍스트 또는 바이너리 데이터의 흐름을 나타냅니다. 빨간색 화살표는 제어의 흐름을 나타냅니다.
(시리즈 후반에 /GL 스위치로 컴파일러에 지정하고 /LTCG 스위치로 링커에 지정하는 전체 프로그램 최적화 주제를 다룰 때 이 다이어그램으로 다시 돌아오겠습니다. 같은 상자 집합을 보게 되겠지만, 연결 방식은 달라집니다.)
요약하면 다음과 같습니다.
프런트 엔드는 C++ 소스 코드를 이해합니다. 체인의 다른 부분, 즉 백 엔드와 링커는 원래 소스 언어의 세부 사항으로부터 (대부분) 분리되어 있습니다. 이들은 앞서 언급한, 일종의 고수준 바이너리 어셈블리 언어를 이루는 튜플을 대상으로 작업합니다. 원래 소스 프로그램은 FORTRAN이나 Pascal 같은 어떤 명령형 언어로 작성되었을 수도 있습니다. 백 엔드는 실제로 신경 쓰지 않습니다. 적어도 크게는 그렇습니다.
백 엔드의 Optimize 부분은 튜플을 더 빠르게 실행되는 효율적인 형태로 변환합니다. 우리는 이런 변환을 최적화라고 부릅니다. (실제로는 “개선”이라고 불러야 합니다. 더 빠르게 실행되는 코드를 만드는 다른 개선이 있을 수 있고, 우리는 그 이상에 가까워지려 할 뿐이기 때문입니다. 하지만 수십 년 전 누군가 “최적화”라는 용어를 만들었고, 우리는 그 용어를 그대로 쓰게 되었습니다.) 이러한 최적화에는 수십 가지가 있으며, “상수 폴딩”, “공통 부분식 제거”, “호이스팅”, “불변 코드 이동”, “죽은 코드 제거”, “함수 인라이닝”, “자동 벡터화” 등의 이름이 있습니다. 대부분의 경우 이러한 최적화는 프로그램이 실행될 최종 프로세서와 무관합니다. 즉, “기계 독립적” 최적화입니다.
백엔드의 CodeGen 부분은 런타임 스택(함수 “활성화 프레임”을 구현하는 데 사용됨)을 배치하는 방법, 사용 가능한 기계 레지스터를 최대한 활용하는 방법을 결정하고, 함수 호출 규약을 구현하는 세부 사항을 추가하며, 대상 기계에 관한 상세한 지식을 활용해 코드가 더욱 빠르게 실행되도록 변환합니다. (아주 작은 예로, 어셈블리 코드를 살펴본 적이 있다면, 예를 들어 코드 디버깅 중 Visual Studio의 디스어셈블리 창(Alt+8)을 사용했다면, EAX를 0으로 설정할 때 더 직관적인 move eax,0 대신 xor eax, eax 같은 명령이 사용되는 것을 알아차렸을 수 있습니다. 왜일까요? XOR 형태가 더 작고(5바이트 대신 2바이트) 더 빠르게 실행되기 때문입니다. 이것을 “미세 최적화”라고 부를 수도 있고, 그 수고를 들일 가치가 있는지 의문을 가질 수도 있습니다. 다음 속담을 떠올려 보십시오. “푼돈을 잘 챙기면 큰돈은 저절로 따라온다.”) Optimize 부분과 달리 CodeGen은 코드가 실행될 프로세서 아키텍처를 알고 있습니다. 어떤 경우에는 대상 프로세서에 대한 이해를 바탕으로 “스케줄링”이라고 하는 과정, 즉 기계 명령이 배치되는 순서까지 바꿉니다. 아, 이것을 조금 더 설명해야겠군요. CodeGen은 x86, x64, ARM-32 중 무엇을 대상으로 하는지 알고 있습니다. 하지만 코드가 실행될 특정 마이크로아키텍처, 예를 들어 Nehalem인지 Sandy Bridge인지를 알 수 있는 경우는 드뭅니다. (더 자세한 정보를 아는 경우는 /favor:ATOM 스위치를 참조하십시오.)
이 블로그는 컴파일러의 Optimize 부분에 초점을 맞추며, 체인을 구성하는 다른 구성 요소인 프런트 엔드, CodeGen, 링커는 거의 언급하지 않을 것입니다.
이 글에서는 많은 전문 용어를 소개했습니다. 이 시점에서 그 모든 것을 완전히 이해하리라고 기대하지는 않습니다. 이 글은 개요일 뿐이며, 여러분의 관심을 끌고 다음 글로 다시 찾아오게 하기를 바라는 생각들을 흩뿌렸습니다. 다음 글부터는 그 모든 전문 용어를 설명하기 시작하겠습니다.
다음에는 가장 단순한 최적화 중 하나인 “상수 폴딩”과 그 작동 방식을 살펴보겠습니다.
