Scala 3 스테이징으로 작은 람다 계산법 인터프리터를 런타임 JVM 코드를 생성하는 컴파일러로 바꾸고, 실제 스마트 계약에서 성능과 컴파일 시간을 개선한 과정입니다.
홈/블로그/메타프로그래밍으로 구현하는 초고속 람다 계산법 Alexander Nemish — 2026년 10월 30일
저는 베를린에서 열린 ScalaDays 2026에서 이 발표를 했습니다. 이 글은 코드와 데이터를 포함한 문서 버전입니다.
작은 람다 계산법의 교과서적 인터프리터를 Scala 3 스테이징으로 런타임에 JVM 코드를 생성하는 컴파일러로 바꿉니다. 핵심 아이디어는 수십 줄이면 됩니다. Scalus의 프로덕션 버전은 실제 Cardano 스마트 계약을 Haskell 레퍼런스 VM보다 약 세 배 빠르게 실행합니다. 그리고 가장 어려운 부분은 속도도 의미론도 아니었습니다. $ 뒤에 숨은 이차 컴파일 시간이었으며, 해결책은 하나의 규칙입니다. 각 Expr는 그것이 존재할 위치에서 만드세요.
발표의 모든 코드는 GitHub의 scala-days-2026 태그에 있습니다. 슬라이드는 여기에 있습니다.
블록체인을 한 번도 다뤄보지 않았다면, 간단한 맥락부터 설명하겠습니다. Cardano에서 스마트 계약은 _검증기_입니다. 트랜잭션을 입력으로 받는 순수 함수로서, 반환하거나 실패합니다. 실패하면 트랜잭션은 거부됩니다.
// illustrative: the shape of a validator
def validator(datum: Data, redeemer: Data, ctx: ScriptContext): Unit
// returns → the transaction is valid · fails → it is rejected
모든 노드는 모든 검증기를 다시 실행하며, 이는 실행 언어에 네 가지 요구 사항을 부과합니다.
마지막 항목이 이 글이 존재하는 이유입니다. 같은 코드가 반복 실행되는 것은 JIT가 빛나는 정확한 작업 부하입니다.
Cardano의 답은 Plutus Core입니다. Phil Wadler를 포함한 IOG 팀이 설계한 비타입 람다 계산법입니다.
2019 IOHK Summit에서 Phil Wadler(오른쪽)와 저. 사진: Alexander Nemish.
Phil은 Haskell 설계자 중 한 명이며 명제로서의 타입의 저자입니다. 타입은 명제이고 프로그램은 그 증명입니다. 람다 계산법은 논리와 계산이 같은 것이 되는 곳이므로, 프로그램에 관해 무언가를 증명하려면 바로 그곳이 적합합니다.
또한 아주 작습니다. 세 가지 구성 요소와 하나의 축약 규칙뿐입니다. 그리고 Agda 및 Lean 4로 기계화되어 있습니다. 온체인에서는 비타입이므로, 체인은 타입 검사기를 신뢰할 필요가 없습니다.
이 모든 것의 대가가 있습니다. 빠르게 설계된 것이 아닙니다. 그것은 우리의 일입니다.
다음은 @Compile로 주석을 단 평범한 Scala fib입니다(임포트는 생략했습니다).
@Compile object FibContract:
  def fib(n: BigInt): BigInt = if n <= 1 then n else fib(n - 1) + fib(n - 2)
Scalus 컴파일러 플러그인은 이를 다음 UPLC로 바꿉니다(이름은 줄였습니다).
[(lam fib [fib fib])
  (lam fib
    (lam n
      (case [(builtin lessThanEqualsInteger) n (con integer 1)]
        [(builtin addInteger)
          [fib fib [(builtin subtractInteger) n (con integer 1)]]
          [fib fib [(builtin subtractInteger) n (con integer 2)]]]
        n)))]
두 가지를 살펴봅시다. 재귀: UPLC에는 letrec이 없으므로 함수는 자신을 인수로 받습니다. 즉 [fib fib]입니다. 발표는 (lam x [x x]) 프로그램으로 시작했습니다. 자기 적용, 즉 인수를 자기 자신에게 적용하는 것입니다. 이를 자기 자신에게 적용하면 영원히 실행됩니다. 자기 적용은 재귀가 컴파일되는 정확한 방식입니다. 그리고 조건문: Scala의 if는 내장 Bool에 대한 case가 됩니다. case는 게으릅니다. False는 첫 번째 분기를, True는 두 번째 분기를 고르며, 선택한 분기만 평가됩니다.
우리의 목표는 정확히 이 프로그램을 실행하는 가장 작은 UPLC를 만들고, 빠르게 만드는 것입니다.
Scala 3에서 전체 언어는 하나의 enum입니다(Term.scala, 일부 생략).
enum Term:
  case Var(name: String)
  case LamAbs(name: String, body: Term)
  case Apply(fun: Term, arg: Term)
  case Constant(value: Const)
  case Builtin(fn: DefaultFun)
  case Case(scrutinee: Term, branches: List[Term])
  case Error

enum Const:
  case Integer(value: BigInt)
  case Bool(value: Boolean)
fib에 필요한 정확한 구성 요소와 다섯 가지 정수 내장 함수, 즉 덧셈·뺄셈·곱셈·동등 비교·작거나 같은지 비교만 있습니다. 기억할 규칙은 네 가지입니다.
Bool에 대한 case는 게으릅니다. 선택된 분기만 실행됩니다.Error는 실패하는 유일한 방법이므로, 검증기는 반환하거나 오류를 냅니다.BigInt입니다. UPLC 정수는 임의 정밀도입니다. Long에서 조용히 오버플로가 발생한다면, 같은 계약이 VM마다 다른 의미를 지니게 됩니다. 이는 합의 버그입니다.정확한 의미론은 계속 반복되는 주제입니다. 실제 Plutus V3에는 delay, force, 생성자, 바이트 문자열, Data 타입, 약 백 개의 내장 함수 등이 더 있지만, 모두 같은 패턴을 따릅니다.
Plutus Core 명세는 Felleisen과 Friedman의 CEK 기계로 평가를 정의합니다. 세 개의 레지스터가 있습니다. 평가 중인 항인 Control, 자유 변수의 값인 Environment, 그리고 결과로 무엇을 할지 나타내는 Kontinuation입니다. 이는 힙 위의 프레임으로 이루어진 명시적 스택입니다.
Plutus Core의 설계 목표는 의미론이 냅킨 위에 들어가는 것이었습니다. PlutusFest 2018에서 IOHK는 이를 문자 그대로 받아 CEK 규칙을 검은 냅킨에 금색으로 인쇄했습니다.
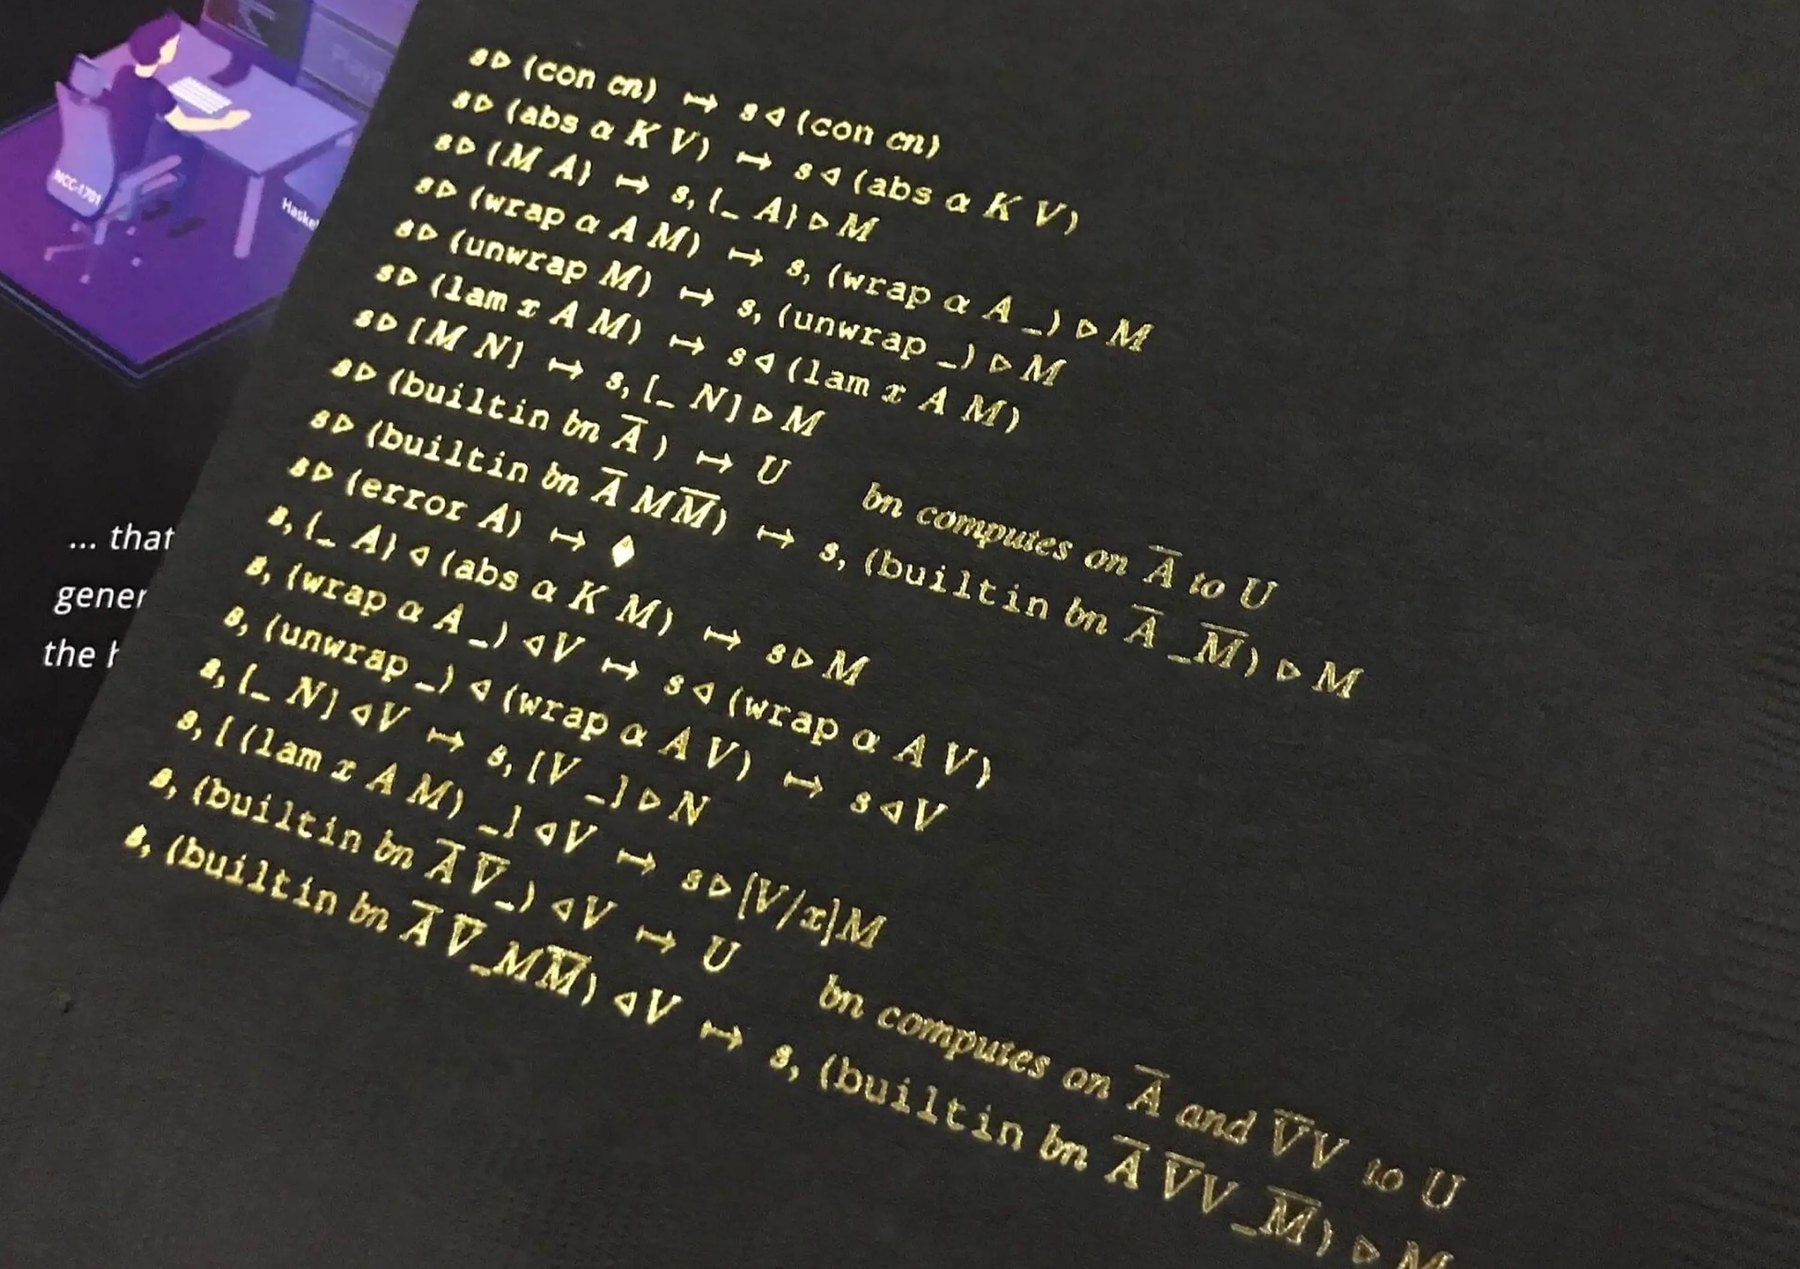
냅킨 위의 CEK 기계, PlutusFest 2018. 사진: Alexander Nemish.
각 줄은 하나의 전이입니다. s ▷ M은 “스택 s로 M을 계산하라”는 뜻이고, s ◁ V는 “V를 스택 s에 반환하라”는 뜻입니다. 이것이 기계의 전부입니다. 연속이 힙에 존재하므로 재귀가 아무리 깊어도 JVM 스택은 오버플로하지 않습니다. 기억해 두세요. 나중에 문제가 됩니다.
다음은 Scala로 작성한 기계입니다(Cek.scala, 전이 함수만 남겼습니다).
@tailrec
private def run(state: State, stack: List[Frame]): Value = state match
  // ---- compute: decompose the term ----
  case Compute(Var(x), env)       => run(Return(lookup(env, x)), stack)
  case Compute(LamAbs(x, b), env) => run(Return(VLam(x, b, env)), stack)
  case Compute(Constant(c), _)    => run(Return(VCon(c)), stack)
  case Compute(Builtin(fn), _)    => run(Return(VBuiltin(fn, Nil)), stack)
  case Compute(Apply(f, a), env)  => run(Compute(f, env), ApplyArg(a, env) :: stack)
  case Compute(Case(s, bs), env)  => run(Compute(s, env), CaseFrame(bs, env) :: stack)
  case Compute(Error, _)          => throw EvaluationError("(error) evaluated")

  // ---- return: feed the value to the top frame ----
  case Return(v) =>
    stack match
      case Nil                     => v
      case ApplyArg(arg, env) :: k => run(Compute(arg, env), ApplyTo(v) :: k)
      case ApplyTo(fun) :: k       => run(applyValue(fun, v), k)
      case CaseFrame(bs, env) :: k => run(Compute(bs(branchIndex(v, bs.size)), env), k)
두 종류의 상태가 있습니다. _Compute_는 항의 형태를 봅니다. 변수나 람다는 즉시 반환하며, Apply와 Case는 나중에 무엇을 할지 나타내는 프레임을 푸시한 뒤 함수 또는 스크루티니를 계속 처리합니다. _Return_은 프레임을 팝하고 결정합니다. 인수를 계산할지, 함수를 적용할지, 정확히 하나의 case 분기를 고를지 결정하며, 이것이 case의 게으름이 생기는 지점입니다.
모든 경우는 냅킨의 규칙 하나에 대응하고, @tailrec은 전체를 루프로 바꿉니다. 약 80줄로, 명백히 정확하고 절대 오버플로하지 않습니다. 문제는 매 실행마다 트리의 모든 노드를 다시 살피고, 상태와 프레임을 할당하며, 이름으로 환경을 탐색한다는 점입니다.
발표에서 청중에게 내기를 제안했습니다. Plutus 명세가 설명하는 인터프리터인 같은 알고리즘, 즉 CEK 기계를 두 번 작성합니다.
plutus-core.공개 벤치마크의 실제 계약 89개, 같은 머신입니다. 어느 쪽이 더 빠를까요?
계속 읽기 전에 내기를 걸어 보세요. 발표에서 보여 준 실행에서는 Haskell이 17 % 차이로 이겼습니다. 계약당 220 µs 대 256 µs였습니다. 다른 언어로 작성한 같은 인터프리터는 그저 같은 인터프리터입니다.
2주 뒤 Scala 쪽이 이겼습니다. 내부 루프를 다시 작성하고 벤치마크가 새 하니스로 옮겨진 뒤, 공개 벤치마크에서 171 µs 대 276 µs였습니다. 하지만 내기의 핵심은 그대로입니다. 인터프리터는 여전히 인터프리터입니다. 같은 JVM과 Scala 3 메타프로그래밍으로 Haskell VM보다 약 세 배 빠르게 만들었습니다. 더 빠른 언어가 아니라, 다른 아이디어입니다.
UPLC는 람다 계산법입니다. Scala에는 람다가 있습니다. JVM은 람다 실행을 매우 잘합니다. 해석하는 대신 UPLC 람다를 JVM 람다로, 내장 함수를 평범한 산술 연산으로 런타임에, 즉 스크립트가 로드될 때 변환하고 JVM의 JIT 컴파일러가 무거운 작업을 하게 하면 어떨까요? 두 단계로 올라가 보겠습니다.
CEK 기계가 HotSpot의 인터프리터 같은 티어 0이라면, 메타프로그래밍 없이 한 단계 올라간 형태는 다음과 같습니다. 항을 한 번 순회하고 Scala 클로저 트리를 만듭니다. 각 노드는 환경에서 값으로 가는 함수가 됩니다(ClosureCompiler.scala, 단순화).
type Code = Frame | Null => Any // built once, run many times

private def compileTerm(term: Term, scope: List[String]): Code = term match
  case Var(name) =>
    val depth = scope.indexOf(name) // resolved at compile time
    env => lookup(env, depth)
  case LamAbs(name, body) =>
    val bodyCode = compileTerm(body, name :: scope)
    env => (arg: Any) => bodyCode(Frame(arg, env)) // a real JVM lambda
  case Apply(fun, arg) =>
    val funCode = compileTerm(fun, scope)
    val argCode = compileTerm(arg, scope)
    env =>
      val f = funCode(env) // the function first, then the argument
      Runtime.apply(f, argCode(env))
  // … constants, builtins, case, error
변수 이름은 컴파일 시점에 깊이가 됩니다. UPLC 람다는 실제 Scala 람다가 됩니다. 적용은 그냥 호출이며, 포화된 내장 함수는 BigInt에 대한 직접 호출이 됩니다. 이 고전적 기법만으로도 fib 20에서 CEK 기계 대비 **16×**를 얻습니다.
왜 여기서 끝이 아닐까요? 인터프리터는 여전히 존재하며, 단지 숨었을 뿐이기 때문입니다. 모든 노드는 Function1.apply 호출이고, 그 호출 지점에서 JVM은 수백 개의 서로 다른 클로저 클래스를 봅니다. 인라인할 수 없는 메가모픽 호출입니다. 변수는 여전히 런타임 연결 리스트에 존재합니다. 또한 JVM이 볼 수 없는 데이터로 프로그램 구조가 남아 있습니다. 진짜 원하는 것은 프로그램 자체가 JVM 코드가 되는 것입니다. 런타임에 타입이 잘 맞는 Scala를 생성하고 컴파일하는 것입니다. Scala 3 스테이징이 정확히 이를 제공합니다.
한 예제로 보는 Scala 3 스테이징입니다. 인용 '{ e }는 표현식의 코드입니다. 결과가 아니라 Expr[T] 타입의 값입니다. 스플라이스 ${ e }는 생성한 코드를 인용 안에 삽입합니다.
// x^n, with the loop unrolled at runtime
def power(x: Expr[Double], n: Int)(using Quotes): Expr[Double] =
  if n == 0 then '{ 1.0 }
  else '{ $x * ${ power(x, n - 1) } }

given staging.Compiler = staging.Compiler.make(getClass.getClassLoader)

val cube: Double => Double =
  staging.run('{ (x: Double) => ${ power('x, 3) } })
// compiled: (x: Double) => x * (x * (x * 1.0))
power는 알려진 n에 대해 곱셈을 생성합니다. 루프는 생성 시점에 실행되고 곱셈은 실행 시점에 수행됩니다. staging.run은 JVM 내부에서 실제 Scala 컴파일러를 실행하고, 바이트코드를 로드해 함수를 돌려줍니다. 핵심적으로 인용은 생성기를 컴파일할 때 타입 검사되므로 타입이 맞지 않는 Scala를 생성할 수 없습니다. 문자열 연결이나 ASM 바이트코드와 비교해 보세요.
여기에는 이름이 있습니다. Yoshihiko Futamura는 1971년에 인터프리터를 하나의 고정 프로그램에 특수화하는 것이 컴파일과 같음을 보였습니다. 첫 번째 Futamura 투영입니다. Scala에는 이를 실용화한 긴 계보가 있습니다. 2010년 Tiark Rompf와 Martin Odersky의 Lightweight Modular Staging, 그리고 다단계 프로그래밍과 매크로를 통합한 Nicolas Stucki, Aggelos Biboudis, Martin Odersky의 2018년 논문에 나온 위의 인용과 스플라이스가 있습니다. 같은 인용이 컴파일 시점 매크로와 런타임 스테이징에 쓰입니다.
그러므로 계획은 이렇습니다. 이미 이해한 인터프리터가 값 대신 코드를 반환하게 만듭니다.
다음은 스테이징 컴파일러의 핵심입니다(StagedJit.scala, 단순화).
private def gen(term: Term, env: Map[String, Expr[Any]])(using Quotes): Expr[Any] =
  term match
    case Var(name) => env(name) // a JVM local: no environment at runtime
    case LamAbs(name, body) =>
      '{ (arg: Any) => ${ gen(body, env.updated(name, 'arg)) } }
    case Apply(fun, arg) =>
      '{
        val f = ${ gen(fun, env) }
        Runtime.apply(f, ${ gen(arg, env) })
      }
    case Constant(c) => genConstant(c)
    case Error       => '{ Runtime.fail() }
    // … plus the two idioms below

def compile(term: Term): () => Any = staging.run('{ () => ${ gen(term, Map.empty) } })
클로저 컴파일러와 인터프리터에 얼마나 가까운지 보세요. gen은 항을 순회하지만 값을 반환하는 대신 코드를 반환합니다. UPLC 변수는 Scala 람다 매개변수의 Expr에 매핑됩니다. 런타임에는 JVM 로컬이고, 클로저가 네이티브로 캡처하므로 환경이 사라집니다. UPLC 람다는 인용된 Scala 람다가 되며, 매개변수가 범위 안에 있는 동안 본문이 생성됩니다. 위생성은 무료로 얻습니다. 모든 인용이 새 심볼을 만들기에 섀도잉이 그냥 동작합니다.
진정한 성과는 관용구를 인식하는 데서 나옵니다. 두 개의 사용자 정의 추출자(Patterns.scala)가 Scalus가 생성하는 형태를 찾아내고, 인용은 각각을 사람이 직접 작성할 Scala로 바꿉니다(StagedJit.scala에서 단순화).
// (case c else then) on a Bool ⇒ a native if: only one branch runs
case IfThenElse(c, t, e) =>
  '{ if ${ genBool(c, env) } then ${ gen(t, env) } else ${ gen(e, env) } }

// [(builtin addInteger) a b] ⇒ BigInt arithmetic, no currying
case SaturatedBuiltin(AddInteger, List(a, b)) =>
  '{
    val x = ${ gen(a, env) }
    val y = ${ gen(b, env) }
    Runtime.asInteger(x) + Runtime.asInteger(y)
  }
Scalus는 모든 if/else를 두 분기가 있는 Bool에 대한 case로 컴파일합니다. 우리는 이를 네이티브 if로 되돌립니다. 조건이 비교라면 genBool은 기본형 Boolean을 생성합니다. 박싱도 타입 검사도 없습니다. 포화된 내장 함수 호출은 커리된 함수 호출 대신 평범한 BigInt 산술이 됩니다.
val과 각 gen 호출이 스플라이스 안에 있다는 점에 주목하세요. 둘 다 의도적입니다. val은 의미론을 위한 것입니다. 아래의 “빠르면서 정확히 같은 결과”를 보세요. gen 호출이 놓이는 위치가 이 이야기의 반전입니다.
다음은 Scalus가 컴파일한 fib에 대해 StagedJit.showCode가 실제로 출력한 것입니다. 약간 잘라내고 이름을 바꿨습니다.
((fib: Any) => ((n: Any) =>
  if ({ val x = n; val y = BigInt(1L); asInteger(x) <= asInteger(y) })
  then n
  else {
    val x = {
      val f = Runtime.apply(fib, fib) // [fib fib]
      Runtime.apply(f, { val a = n; val b = BigInt(1L); asInteger(a) - asInteger(b) })
    }
    val y = {
      val f = Runtime.apply(fib, fib)
      Runtime.apply(f, { val a = n; val b = BigInt(2L); asInteger(a) - asInteger(b) })
    }
    asInteger(x) + asInteger(y)
  }))
fib를 받는 Scala 람다가 n을 받는 람다를 반환합니다. Scalus의 case는 BigInt 비교를 갖는 네이티브 if가 되었습니다. else 분기에서 자기 적용 [fib fib]은 호출이고, 이어서 n - 1로 재귀 호출합니다. n - 2도 마찬가지이며, 그 뒤에 덧셈이 옵니다. 더는 인터프리터가 없습니다. UPLC를 Scala로 번역할 때 사람이 직접 작성할 코드입니다. 단, 프로그램이 런타임에 수십 밀리초 만에 작성했다는 차이가 있습니다. 이만큼 작은 프로그램에서는 그렇습니다. 이 생각은 잠시 붙들어 두세요.
네 단계와 우리가 작성하지 않은 두 컴파일러가 있습니다.
Expr[Any]: 생성기가 인용으로 만듭니다.scalac가 만듭니다.JVM은 자주 실행되는 코드를 프로파일링하고 기계어로 컴파일합니다. 작은 모노모픽 람다를 직선 코드로 인라인하고, 이스케이프 분석으로 임시 할당을 제거하며, 런타임 타입 검사를 항상 올바르게 예측되는 분기로 바꿉니다. 우리는 작은 컴파일러 하나를 작성했는데 산업 수준 컴파일러 두 개를 공짜로 얻었습니다.
라이브 데모는 Scalus로 Scala의 fib를 컴파일하고, UPLC를 미니 UPLC로 변환한 뒤 엔진들을 경쟁시킵니다.
$ sbt "scalusBridge/run 20"
| 엔진 | 실행당 µs | CEK 기계 대비 |
|---|---|---|
| CEK 기계 | 6,387 | 1× |
| 클로저 컴파일러 | 389 | 16.4× |
| 스테이징 컴파일러 | 183 | 35.0× |
fib 20은 약 22,000회의 재귀 호출이므로 이는 밀리초 단위입니다. 실제 계약은 수백 마이크로초가 걸립니다. 장난감 CEK 기계는 의도적으로 단순하므로 35×는 실제 격차를 과장합니다. 실제 수치는 4막에서 다룹니다.
빠르게 만드는 일은 쉽습니다. 레퍼런스와 정확히 같게 만드는 일이 진짜 작업입니다. 두 노드가 어떤 스크립트에 대해 다르게 판단하면 합의 버그이기 때문입니다.
Any를 뜻합니다. 모든 사용은 런타임에 타입을 검사하고, CEK 기계가 실패하는 정확히 그 지점에서 실패해야 합니다.val이 이를 위한 것입니다.case, 엄격한 호출. case는 선택된 분기만 실행하지만, 호출의 모든 인수는 사용되지 않더라도 실행됩니다.그리고 하나가 더 있습니다. 컴파일된 코드는 JVM 호출 스택을 사용합니다. 재귀가 100,000 깊이인 비꼬리 재귀는 스택이 힙에 있는 CEK 기계에서는 문제없지만, 두 컴파일러는 모두 실패합니다.
── sumTo 100000 ──
CEK machine        (con integer 5000050000)
Closure compiler   StackOverflowError!
Staged compiler    StackOverflowError!
Scalus JIT는 호출 깊이를 세며, 재귀가 너무 깊어지면 CEK 기계로 폴백합니다. 실행 예산도 유효한 스크립트가 재귀할 수 있는 깊이를 제한합니다.
이 모든 것의 원칙은 다음과 같습니다. 지루한 인터프리터를 오라클로 유지하고, 실패하는 프로그램을 특히 포함해 모든 엔진을 그것과 대조하여 테스트하세요.
fib는 수십 밀리초에 컴파일되었습니다. 그러고 나서 Scalus JIT를 벤치마크의 모든 실제 계약에 적용했습니다.
중앙값 컴파일 시간은 22초였습니다.
혹은 Scala 2 시대에는 이렇게 불렀습니다. 빠르다고요.
가장 큰 스크립트는 2분 타임아웃을 넘겼고, 시간은 스크립트보다 더 빠르게 증가했습니다. 생성된 코드가 필요로 하는 JVM 워밍업까지 더하면, 최고 속도에 도달하기까지 약 20초가 걸렸고, JIT가 평범한 인터프리터를 이기는 손익분기점은 중앙값 175,000회 평가였습니다. 테스트 스위트에는 괜찮지만, 거의 다른 어떤 용도에도 쓸모없습니다. 또 하나의 함정도 있었습니다. 계속 유지하는 스테이징 컴파일러는 계속 커졌으므로, 스크립트마다 새 컴파일러를 사용했습니다.
하지만 시간의 93 %는 scalac에 있지 않았습니다. scalac가 시작하기도 전인 자체 생성기에 있었습니다. 그래서 컴파일 시간을 고치기로 했습니다. 터미널을 열고 이렇게 말했습니다. “Claude, --dangerously-skip-permissions, 무슨 일인지 알아내.”
몇 시간 뒤 돌아와서 말했습니다. “느린 건 scalac이 아니었습니다. 당신이었습니다.”
다음은 찾아낸 내용입니다.
val 또는 람다입니다. 생성기는 각 하위 표현식을 먼저 평범한 값으로 만들고, 그 후 새 val이나 새 람다 아래의 인용에 스플라이스했습니다. 그러면 표현식은 잘못된 소유자를 가지게 되었고, 컴파일러는 유일하게 안전한 방식으로 이를 고쳤습니다. 전체 하위 트리를 순회하고 복사해 소유자를 변경한 것입니다. 한 단계 위에서 첫 번째 복사본을 포함한 트리에 다시 똑같이 했습니다.깊이 d의 노드는 d번 복사됩니다. 이차적이며, 소스에서는 완전히 보이지 않고 $ 뒤에 숨습니다.
해결책은 거의 민망할 정도로 단순하며, 위의 내장 함수 코드에서 이미 보았습니다. 한 경우에 대한 두 생성기를 나란히 보겠습니다(StagingCostExperiment.scala, 일부 생략, 주석 추가).
// Before: quadratic. Children are built first…
case Apply(Apply(Builtin(AddInteger), a), b) =>
  val ea = gen(a, env)
  val eb = gen(b, env)
  '{
    val x = $ea // …then re-owned here: the whole subtree is copied
    val y = $eb
    Runtime.asInteger(x) + Runtime.asInteger(y)
  }
// After: linear. Each child is generated inside the splice where it lives.
case Apply(Apply(Builtin(AddInteger), a), b) =>
  '{
    val x = ${ gen(a, env) }
    val y = ${ gen(b, env) }
    Runtime.asInteger(x) + Runtime.asInteger(y)
  }
이전에는 하위 표현식을 만들고 나중에 스플라이스했습니다. 이후에는 스플라이스 안에서 생성기를 호출하므로, 각 표현식은 태어날 때부터 올바른 소유자와 함께 자신이 존재할 곳에서 직접 생성됩니다. 복사할 것이 없습니다. 이것이 동작하려면 생성기는 최상단에서 캡처한 Quotes가 아니라, 자신이 실행되는 스플라이스의 Quotes를 받아야 합니다. 생성된 프로그램은 동일합니다. 같은 형태, 같은 속도입니다. 바뀐 것은 만드는 순서뿐입니다.
Scalus에는 두 종류의 복사가 있었습니다. 모든 람다 본문에 대한 자체 changeOwner와, val 또는 클로저 아래에 스플라이스한 모든 Expr에 대해 스테이징이 수행하는 소유자 변경입니다. 둘 다 사라졌습니다. 89개 계약 전체의 결과는 다음과 같습니다.
| Scalus JIT, 89개 계약 | 이전 | 이후 |
|---|---|---|
| 중앙값 컴파일 | 22초 | 2.3초 |
| 최장 컴파일 | 197초 | 7.7초 |
| 전체 컴파일 중 자체 생성기 비율 | 93 % | 6 % |
| CEK 대비 손익분기점, 중앙값 | 175,000회 실행 | 16,000회 실행 |
정상 상태 속도는 변하지 않았습니다. 인터프리터의 3.9×였습니다. scalac 자체는 전후 모두 약 2초가 걸렸습니다. 스테이징은 느린 부분이 아니었습니다.
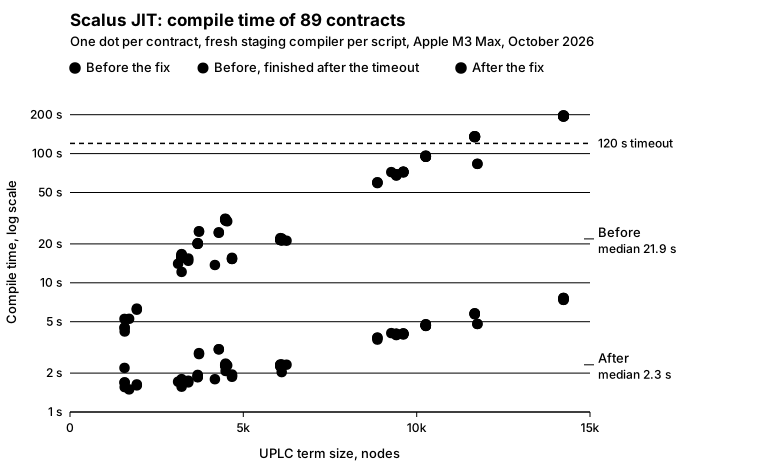
스크립트 크기에 따른 컴파일 시간입니다. 계약당 점 하나, 로그 스케일입니다. 데이터: 이전, 이후.
이를 조사하는 동안 장기 실행 스테이징 컴파일러가 계속 커지는 이유도 찾았습니다. 모든 스테이징 실행이 같은 실행 식별자를 받으므로 컴파일러 캐시가 지워지지 않았습니다. 이는 scala/scala3#27335에서 업스트림 수정되었습니다.
가져갈 규칙은 이것입니다. 각 Expr는 그것이 존재할 위치에서 만드세요.
벤치마크는 경매, 에스크로, 크라우드펀딩, Uniswap 클론 등 실제 계약 89개를 하나의 머신에서 모든 VM으로 실행합니다. 컴파일과 워밍업 후 계약당 시간은 다음과 같습니다.
| 발표 실행(Mac, 10월 11일) | 공개 실행(클라우드 서버, 10월 27일, 평가만) | |
|---|---|---|
| Scalus JIT | 71 µs | 94 µs |
Haskell plutus-core(레퍼런스) | 220 µs | 276 µs |
| Scalus CEK(우리의 인터프리터) | 256 µs | 171 µs |
| Rust | 363 µs | 365 µs |
머신과 벤치마크 하니스가 다르므로 열 내부에서 비교해야 합니다. 둘 다 JIT가 Haskell VM보다 약 세 배 빠르며, 일부 계약에서는 최대 아홉 배 빠릅니다. 몇몇 계약에서는, 일부는 아주 작고 일부는 가장 큰 계약인데, 여전히 인터프리터가 이깁니다. 가장 큰 계약에서는 JVM이 벤치마크가 제공하는 것보다 더 긴 워밍업을 필요로 하며, 더 적고 더 큰 메서드를 생성하는 것이 다음 과제입니다.
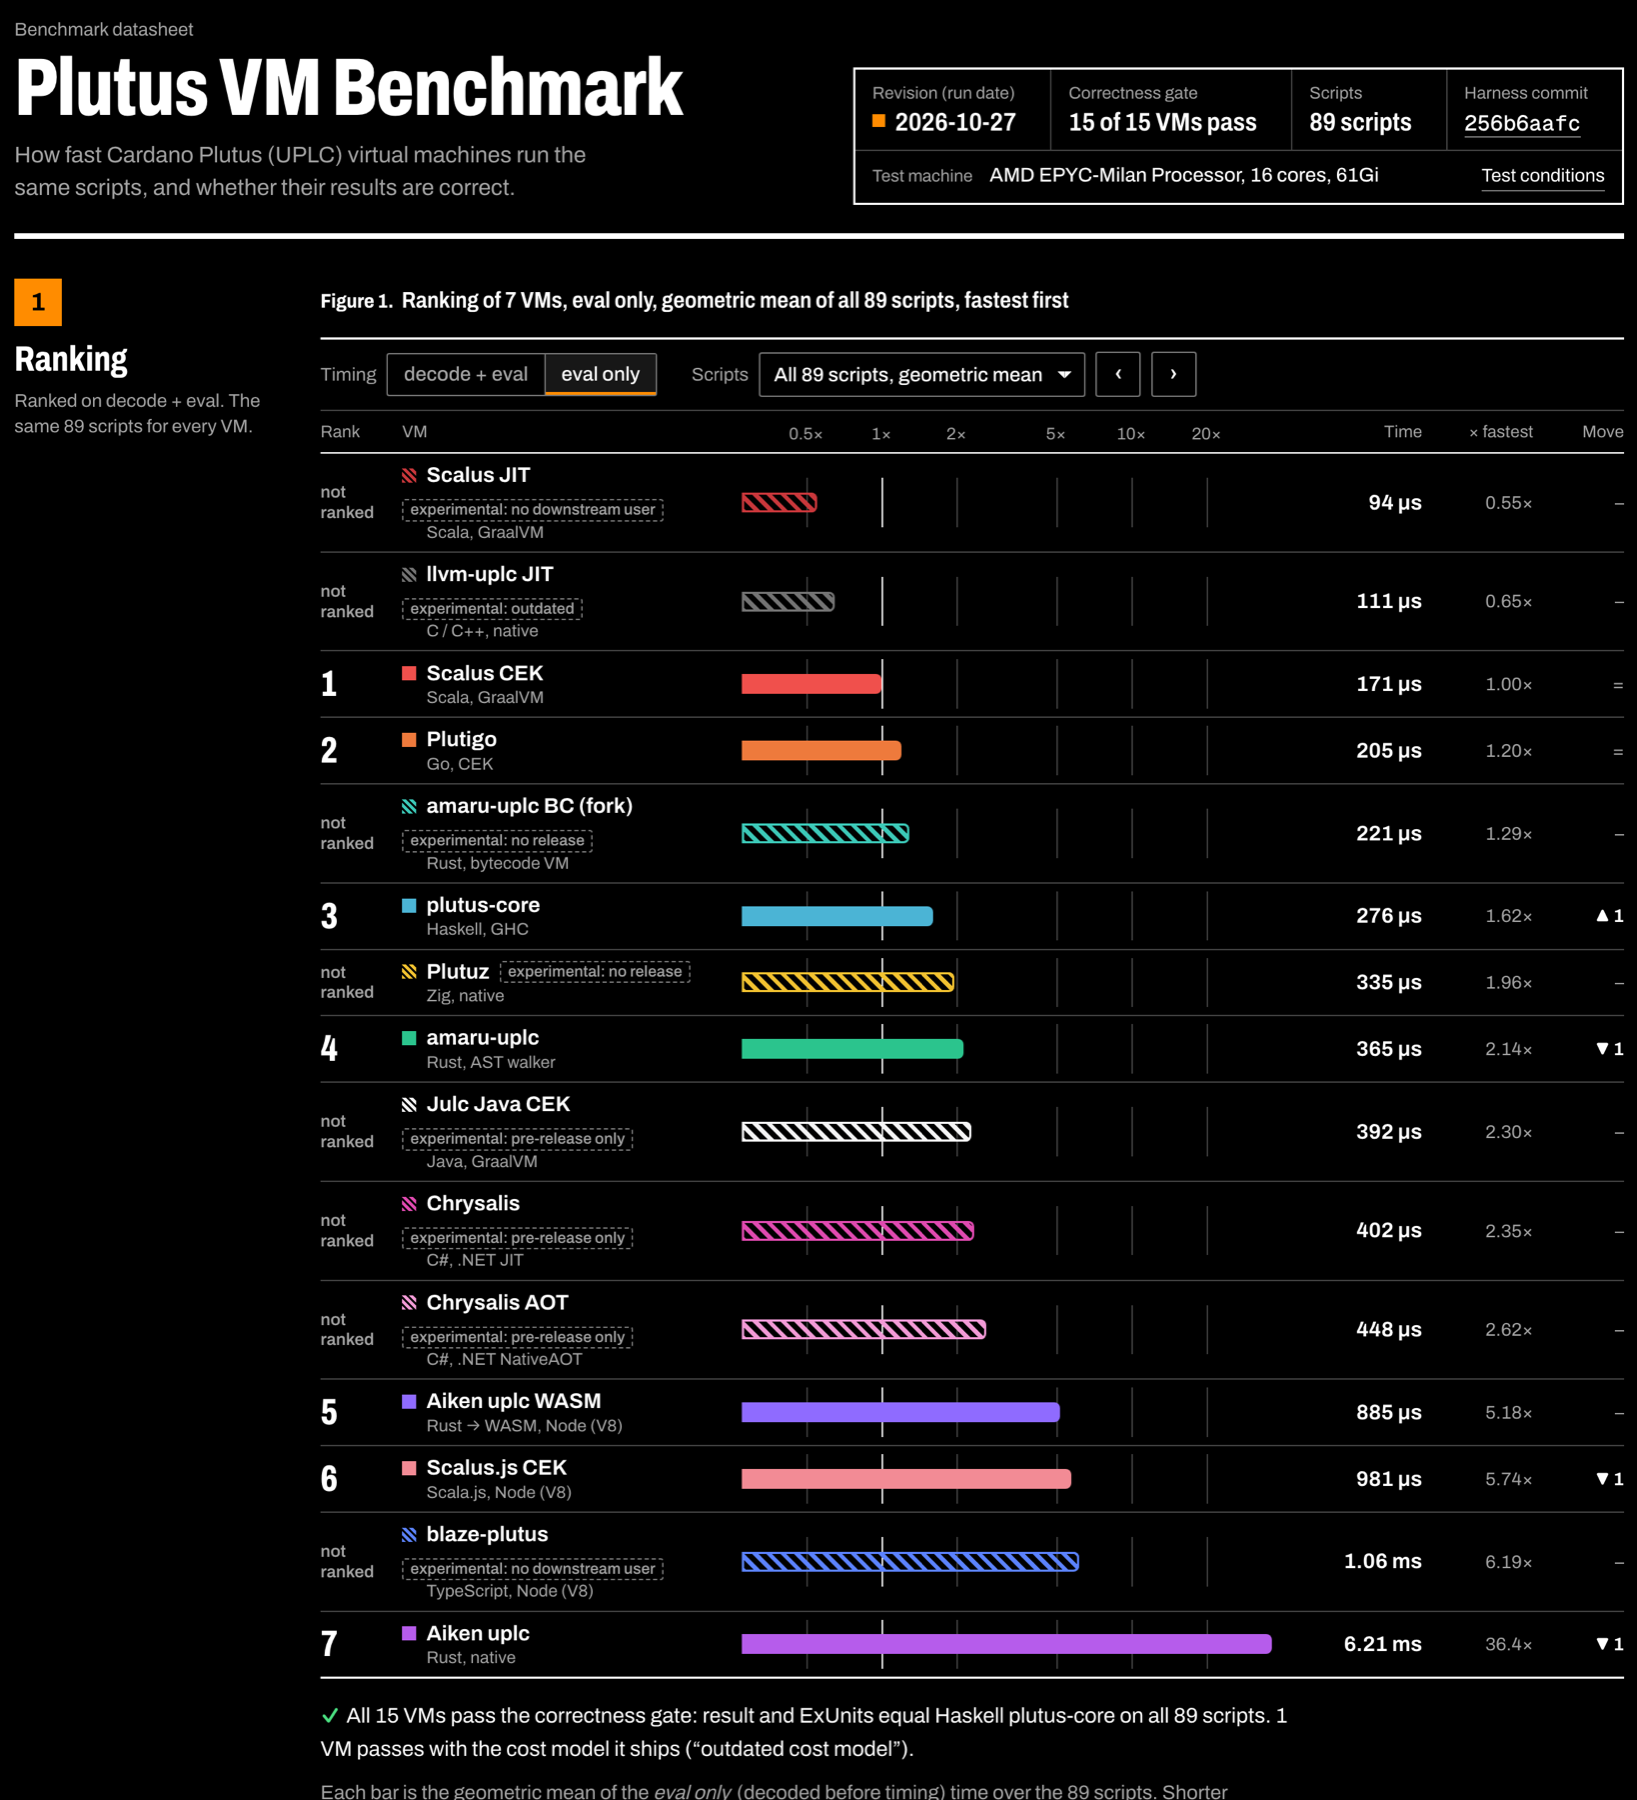
plutus-vm-bench.lantr.io의 평가 전용 순위로, 2026년 10월 27일 실행 결과입니다. Scalus JIT는 표시되지만 순위에는 포함되지 않습니다. 시간 측정 루프 전에 각 스크립트를 컴파일하기 때문입니다.
2025년 초 Cardano 메인넷 4주간의 데이터입니다. 서로 다른 2,224개 스크립트가 311,393회 실행되었습니다. 대부분은 Plutus V2 스크립트였고, 그중 가장 많이 사용된 10개가 실행의 60 %를 차지했으며 상위 100개, 즉 스크립트의 6 %가 93 %를 차지했습니다(집계 방법).
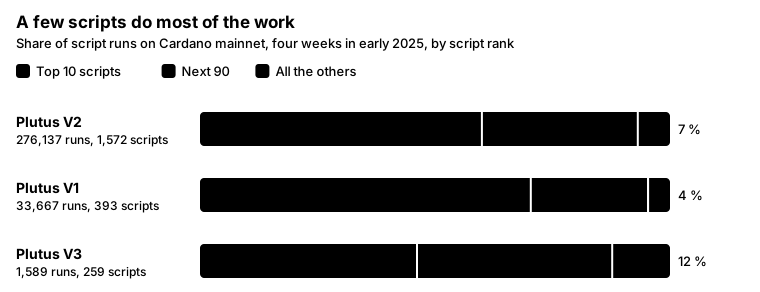
Plutus 버전별 스크립트 순위에 따른 스크립트 실행 비율입니다. 데이터: CSV.
전형적인 멱법칙이며, 정확히 JIT가 원하는 형태입니다. 소수의 자주 실행되는 스크립트가 반복 실행됩니다. Cardano에서 스크립트는 불변이고 해시로 주소 지정되므로, 컴파일된 스크립트는 그냥 캐시 항목입니다. 한 번 컴파일하고 해시를 키로 쓰면 무효화할 일이 없습니다. 아키텍처는 JVM 자체처럼 티어링입니다. 인터프리터는 차가운 스크립트에 즉시 응답하고, 자주 실행되는 스크립트는 백그라운드에서 컴파일한 뒤 교체합니다.
여기서 Phil Wadler에게 정정할 일이 있습니다. 그는 내가 만든 것이 진정한 JIT는 아니라고 말했습니다. 실행 전에 전체 스크립트를 컴파일하기 때문입니다. 맞습니다. 이것만 놓고 보면 스테이징 컴파일러이고, 여기서 진짜 JIT는 HotSpot입니다. 그래서 이 글은 장난감 엔진을 스테이징 컴파일러라고 부릅니다. 그러나 이를 인터프리터 뒤에 두고, 자주 실행되는 스크립트만 컴파일하면 시스템은 JIT입니다. 단위가 메서드가 아니라 스크립트일 뿐입니다.
솔직한 단서가 있습니다. Cardano 노드는 Haskell VM을 실행하므로, 이 작업은 레이어 1 검증을 빠르게 하지 않습니다. 최적의 지점은 레이어 2입니다. Scala 3로 작성된 상태 채널 프로토콜 Hydrozoa는 오더북 거래소 같은 자체 원장과 애플리케이션을 운영하고, 같은 소수의 스크립트를 하루 종일 평가합니다. 레퍼런스 VM보다 약 세 배 빠른 JIT가 의미를 갖는 곳이 바로 여기입니다.
“항상 컴파일러를 작성하라”가 아닙니다. 작업 부하가 감당할 티어를 선택하세요. HotSpot의 계층형 컴파일과 같은 생각입니다.
| 엔진 | fib 20 | 시작 시간 | 사용처 |
|---|---|---|---|
| 인터프리터(CEK) | 1× | 없음 | 명세와 테스트 오라클. 차갑거나 일회성인 스크립트. |
| 클로저 컴파일러 | 16× | 밀리초 | 따뜻한 스크립트. 메타프로그래밍이 필요 없음. |
| 스테이징 컴파일러 | 35× | 수 초 + 워밍업 | 매우 자주 실행되는 일부. 하나의 스크립트, 많은 실행. |
속도 향상은 fib 20에서의 장난감 엔진 결과입니다. 위 벤치마크가 보여 주듯 실제 계약에서는 격차가 더 작습니다.
그 과정에서 얻은 세 가지 교훈입니다.
Expr는 그것이 존재할 위치에서 만드세요.이 중 어느 것도 블록체인에만 국한되지 않습니다. 비즈니스 규칙, 쿼리 필터, 자체 DSL처럼 자주 실행되는 입력을 가진 모든 인터프리터는 컴파일러가 되기를 기다리고 있습니다.
scala-days-2026의 lantr-io/tiny-uplc-jit – 미니 UPLC, CEK 기계, 클로저 컴파일러, 스테이징 컴파일러, 테스트 및 JMH 벤치마크scalus-uplc-jit-compiler