Asahi Linux의 Linux 7.3 진행 보고로, 업스트리밍, M3 지원, Thunderbolt, 게임, 성능 개선 등을 다룹니다.
또다시 이 자리에 섰습니다. Linux 7.3이 출시되었고 지난 몇 달은 다사다난했으니, 또 하나의 Asahi Linux 진행 보고를 시작해 봅시다!
언제나 그렇듯 업스트리밍 작업은 계속 진전되고 있습니다. 저수준 SoC 블록을 위한 일반적인 패치들 외에도, 이번 주기에는 macaudio와 avd라는 두 주요 드라이버가 목록에 올랐습니다. macaudio를 제출 준비 상태로 만드는 일은 어려운 과제였습니다. Apple Silicon 기기의 오디오 서브시스템은 상당히 특수하며, 제대로 지원하려면 ALSA 코어에 꽤 많은 변경이 필요했습니다. Apple은 업스트림에서 이미 지원되던 특수 변형 스피커 및 헤드셋 앰프도 사용하며, 이 드라이버들 역시 상당히 큰 수정이 필요했습니다. 이전에 이 작업의 상당 부분을 자세히 다뤘으며, 마침내 주 드라이버를 검토용으로 제출할 수 있는 단계에 도달했습니다. 드라이버와 Devicetree 변경은 전체 패치셋에서 상당한 비중을 차지하며, 약 3100줄입니다.
AVD는 완전히 다른 짐승입니다. AVD 드라이버는 다운스트림 트리에 고작 3개월 남짓 있었지만 이미 목록에 올랐습니다. 이는 주요 SoC 구성 요소로서는 지금까지 가장 짧은 전환 기간이며, 언젠가 업스트림 우선 개발로 전환할 수 있다는 전망을 밝게 합니다. 이는 환상적인 소식입니다. AVD 드라이버와 관련 Devicetree 변경은 약 13000줄의 코드이기 때문입니다.
이번 주기에는 Yureka의 지칠 줄 모르는 노력 덕분에 M4 Pro 및 Max 기기뿐 아니라 M5를 위한 초기 Devicetree도 목록에 등장했습니다. 늘 그렇듯 이 초기 Devicetree는 최소한의 구성으로, SoC를 TTY까지 부팅하기에만 충분합니다. 하지만 추가 기능 활성화 작업은 진행 중입니다. 계속 지켜봐 주세요!
또한 실용적인 곳에서는 업스트림 우선 접근 방식으로 전환하기 시작했습니다. 새 기기에 필요한 TI USB-PD 및 SPMI 드라이버 변경과 Thunderbolt 초기 지원은 모두 업스트림 우선으로 개발되었습니다. 업스트리밍에 집중해 온 노력이 결실을 보기 시작해 매우 기쁩니다!
지난번에 Asahi 설치 관리자의 EXPERT 플래그를 통해 M3 계열 기기를 초기 지원한다고 발표했습니다. 초기 사용자에게서 받은 문제 보고가 거의 없었기에, 이제 M3 지원은 EXPERT 플래그 없이 정식으로 이용할 수 있음을 기쁘게 알립니다!
M3 지원에도 여러 개선을 이루었으며, 특히 DCP를 활성화했습니다. 성능과 배터리 수명 개선에 더해, 이제 M3 계열 기기에서 절전 기능을 활성화하고 MacBook의 노치 주변 영역도 사용할 수 있습니다! 앞으로 며칠 내에 나올 m1n1 및 커널 업데이트를 주목해 주세요.
지난번에는 m1n1에서 SPTM 지원 버전의 macOS를 가상화하는 지원을 예고했으며, 이를 통해 M4 계열 기기에서 리버스 엔지니어링이 가능해졌습니다. M5는 새로운 과제를 제시합니다. M5를 지원하는 모든 macOS 버전은 Exclaves 사용을 요구하기 때문입니다.
Exclaves는 Secure Kernel이 제어하는 격리 환경에서 실행되는 작은 애플리케이션입니다. M5 계열 SoC 이상에서 macOS는 화면에 “카메라 사용 중” 표시기를 그리는 것과 같은 민감한 작업에 이를 사용합니다. XNU는 Tightbeam이라는 또 다른 IPC 프로토콜을 사용해 SPTM을 통해 Secure Kernel 및 그 Exclaves와 통신합니다. SPTM과 마찬가지로, 실행 중인 Exclaves를 찾을 수 없으면 XNU는 패닉에 빠집니다. 이 모든 것은 개념상 Arm 자체의 TrustZone 기능과 매우 비슷해 보이기 시작합니다.
일부 Exclaves는 명령줄에서 몇 가지 설정을 변경하여 우회할 수 있지만, 이것이 항상 가능한 것은 아닐 것으로 예상합니다. 이에 Sven은 이 모든 것을 m1n1에 어떻게 넣을 수 있을지 살펴보기 시작했습니다. 첫 번째 조사 방향은 Secure Kernel과 Exclave 사용자 공간을 SPTM 및 macOS 옆의 또 다른 VM에 넣어 보는 것이었습니다.
오, 작동했습니다. 이제 m1n1 아래 EL1에서 VM 세 개를 생성할 수 있습니다! VMWare를 떠나는 기업에 m1n1을 팔기 시작할 수도 있겠네요… 이로써 M4 및 M5 계열 기기 모두에서 macOS를 가상화하고 리버스 엔지니어링할 수 있게 되었습니다.
M3 지원은 이제 M1 및 M2와 기능 면에서 대체로 동등하지만, 명백한 예외는 GPU입니다. Apple의 GPU 팀은 틱톡 모델을 따르는 듯하며, M3의 GPU는 M1 및 M2 SoC에서 찾아볼 수 있는 모델과 크게 달라졌습니다. 꽤 오래전에 새로운 기여자 그룹이 M3 GPU를 리버스 엔지니어링하고 있다고 언급했지만, 그 뒤로는 많은 이야기가 나오지 않았습니다.
올해 XDC에서 Alyssa Millburn, Anna Maniscalco, TellowKrinkle은 M3 GPU 리버스 엔지니어링 진행 상황에 관한 발표를 했습니다. 작업은 m1n1이 GPU를 성공적으로 초기화하고 팀이 삼각형을 그릴 수 있을 정도로 진행되었습니다! 이 진행 보고의 “Think Different” 섹션을 좋아하는 분이라면 이 발표에서 많은 것을 얻을 수 있습니다. Apple은 다시 한번 업스트림 Mesa에 통합하려면 상당한 엔지니어링 노력이 필요한 여러… 흥미로운 선택을 했습니다. 더 자세한 내용에 관심이 있다면 꼭 볼 가치가 있습니다.
이 작업을 가능하게 한 모든 분께 깊이 감사드립니다. 더 많은 진전이 이어질 예정이니 계속 지켜봐 주세요.
2024년 1월로 거슬러 올라가면, 우리는 그해 안에 Thunderbolt 지원을 약속하는 실수를 했습니다. 쉽게 반복하지 않을 실수입니다. 그 뒤 2년 동안 Thunderbolt에 관해 거의 아무 말도 하지 않았으니, 이런 의문이 생깁니다. 어디에 있나요?
Thunderbolt는 원래 Apple과 Intel이 개발했으며, Intel은 필요한 하드웨어의 설계와 제조를 담당했습니다. Intel이 이 컨트롤러를 원하는 누구에게나 (대체로) 합리적인 가격에 제공했기에, 다른 누구도 자체 설계를 할 필요를 느끼지 않았습니다. AMD 같은 회사들이 자체 컨트롤러를 개발하기로 결정한 것은 표준이 USB-IF로 이전한 시기와 대체로 맞물리는 아주 최근의 일입니다. 물론 Apple도 예외는 아닙니다.
대부분의 실리콘 IP를 자체 조달하려는 노력의 일환으로 Apple은 다른 대부분보다 먼저 자체 Thunderbolt 컨트롤러를 설계하기로 했습니다. 누구도 놀라지 않겠지만, 이 컨트롤러는 맞춤형 Thunderbolt/USB4 라우터와 결합된 RTKit 실행 Cortex-M3입니다. 모든 Apple Silicon Mac의 Thunderbolt 지원 USB-C 포트마다 하나씩 존재합니다.
시장에 존재하는 다른 모든 Thunderbolt 컨트롤러는 Intel이 공급하므로, Linux 커널의 Thunderbolt 서브시스템은 사실상 이들을 중심으로 설계되었습니다. 하드웨어 기능과 특정 레지스터 및 공유 메모리 영역에 대한 접근 패턴을 포함해 실행 중인 기기의 하드웨어 토폴로지에 관해 여러 가정을 합니다. Apple의 컨트롤러는 이 가정 중 다수를 깨뜨립니다. 훌륭하군요.
Thunderbolt 컨트롤러는 PMGR와도 이상하게 결합되어 있습니다. 각 컨트롤러의 리셋 라인은 PMGR의 MMIO 범위 한가운데에 있는 비트 집합을 설정하고 해제하여 활성화 또는 비활성화됩니다. 다른 하드웨어 블록은 이와 정확히 같은 방식으로 동작하지 않으며, PMGR에 대한 이런 겉보기에는 무작위인 쓰기가 단순한 잡음이 아님을 깨닫는 데 시간이 걸렸습니다.
다행히 Sven은 이 모든 난센스를 처리할 준비가 되어 있었습니다. 예상보다 약간 더 오래 걸렸을 뿐입니다! Thunderbolt를 활성화하는 패치셋은 먼저 업스트림에 전송되었고(우리에게 또 하나의 큰 승리입니다!), 이를 다운스트림 커널에도 가져와 이제 사용자에게 제공하고 있습니다!
하지만 문제가 있습니다. 현재 지원되는 것은 USB3, XDomain, Thunderbolt Networking뿐입니다. USB 기기를 연결하거나 두 Thunderbolt 컴퓨터를 연결해 서로 ping하게 만들 수 있지만, 그게 전부입니다. 대부분의 Thunderbolt 독에 필요한 PCIe 및 DisplayPort 터널링은 아직 지원되지 않습니다. 계속 지켜봐 주세요.
다른 모든 놀라운 작업 사이에서 거의 5년 동안 이 보답 없는 일을 붙들고 있던 Sven에게 막대한 감사를 전합니다.
Asahi Linux에서 소매 PC 게임을 플레이하는 것은 좋게 말해도 꽤 골칫거리입니다. 이를 가능하게 하는 데 필요한 소프트웨어 스택은 엄청나게 복잡합니다. x86/amd64 바이너리를 arm64로 변환해야 하고, 지연 시간이 짧은 게임에 충분할 만큼 빠르게 처리해야 합니다. 대부분의 경우 Windows API도 다뤄야 합니다. 게다가 거의 모든 게임은 특정 성능 최적화를 위해 4 KiB 메모리 페이지 크기를 전제합니다. 지난 몇 년간 이 문제 대부분은 해결되었습니다.
muvm이 처음 개발되었을 때, DRM Native Context가 VM 내부에서 네이티브에 가까운 GPU 성능을 제공할 것이라는 가정이 있었습니다. 안타깝게도 이 가정은 성립하지 않았습니다. muvm의 성능 손실은 여러 이유로 상당하며, 워크로드에 따라 약 20%입니다. VM 사용에 본질적으로 따르는 한계를 우회하는 엔지니어링도 문제를 일으킵니다. muvm은 Wayland를 사용할 수 없고, I/O 성능이 느리며, 특정 유형의 입력 기기에서 어려움을 겪습니다.
이 영역에서는 macOS가 우리를 완전히 압도합니다. FEX와 Rosetta의 성능 격차는 좁아졌지만, XNU는 사용자 공간 프로세스가 어떤 페이지 단위로든 자신을 매핑할 수 있게 하므로 Rosetta는 하위 프로세스에 4 KiB 페이지를 매핑하라고 XNU에 지시하기만 하면 됩니다. Linux에는 이런 유연성이 없습니다. 모든 페이지는 커널과 동일한 단위로 매핑되어야 합니다. 작년에 muvm 밖에서 Windows 게임이 동작하는 것을 예고했지만, 이는 이후 유지 관리성과 변환 정확성을 위해 제거된 FEX 내부의 보기 흉한 해킹에 의존했습니다. 아쉽습니다. 그럼에도 호환성은 들쭉날쭉했고, 많은 (대부분 오래된) 소프트웨어가 여전히 동작을 거부했습니다. 더 아쉽습니다.
Android는 여러 이유로 현재 4 KiB 페이지에서 16 KiB 페이지로 전환하는 중입니다. Google Play는 이제 앱이 16 KiB 시스템용으로 빌드되도록 요구하며, 이런 시스템에서 성공적으로 테스트되지 않은 애플리케이션 업데이트는 Play Store 게시 승인을 받지 못합니다. 하지만 더 이상 업데이트되지 않는 애플리케이션은 어떨까요? 사이드로딩한 기업용 엉성한 앱은요?
Google 엔지니어 Kalesh Singh와 Frederick Mayle은 올해 Linux Plumbers Conference에서 바로 이 주제에 관한 매우 흥미로운 발표를 했습니다. 해결책은 간단합니다. 사용자 공간이 4 KiB 페이지를 매핑할 수 있도록 Linux를 고치면 됩니다!
Android 커널에 추가된 기능의 이름은 프로세스별 페이지 크기, 즉 P3S입니다. ARM64 시스템에서 페이지 테이블 단위는 Translation Control Registers(TCR)에 설정된 비트로 제어됩니다. P3S는 각 프로세스의 페이지 테이블 단위를 추적하고, 다른 페이지 테이블 크기를 지닌 프로세스로 전환할 때마다 적절한 비트를 TCR에 기록하는 방식으로 작동합니다. 이는 레지스터 하나를 쓰는 작업일 뿐이고, “네이티브” 페이지 크기 프로세스에서는 아무 작업도 하지 않으므로 성능 손실은 사실상 0입니다!
이 노력은 주로 Android를 대상으로 하지만, 패치셋은 대체로 메인라인 Linux 위에 깔끔하게 리베이스됩니다. 이를 Asahi 트리 위에 리베이스하고(몇 가지 버그도 고치고) 나면 어떻게 될까요? 결과는 다음과 같습니다.
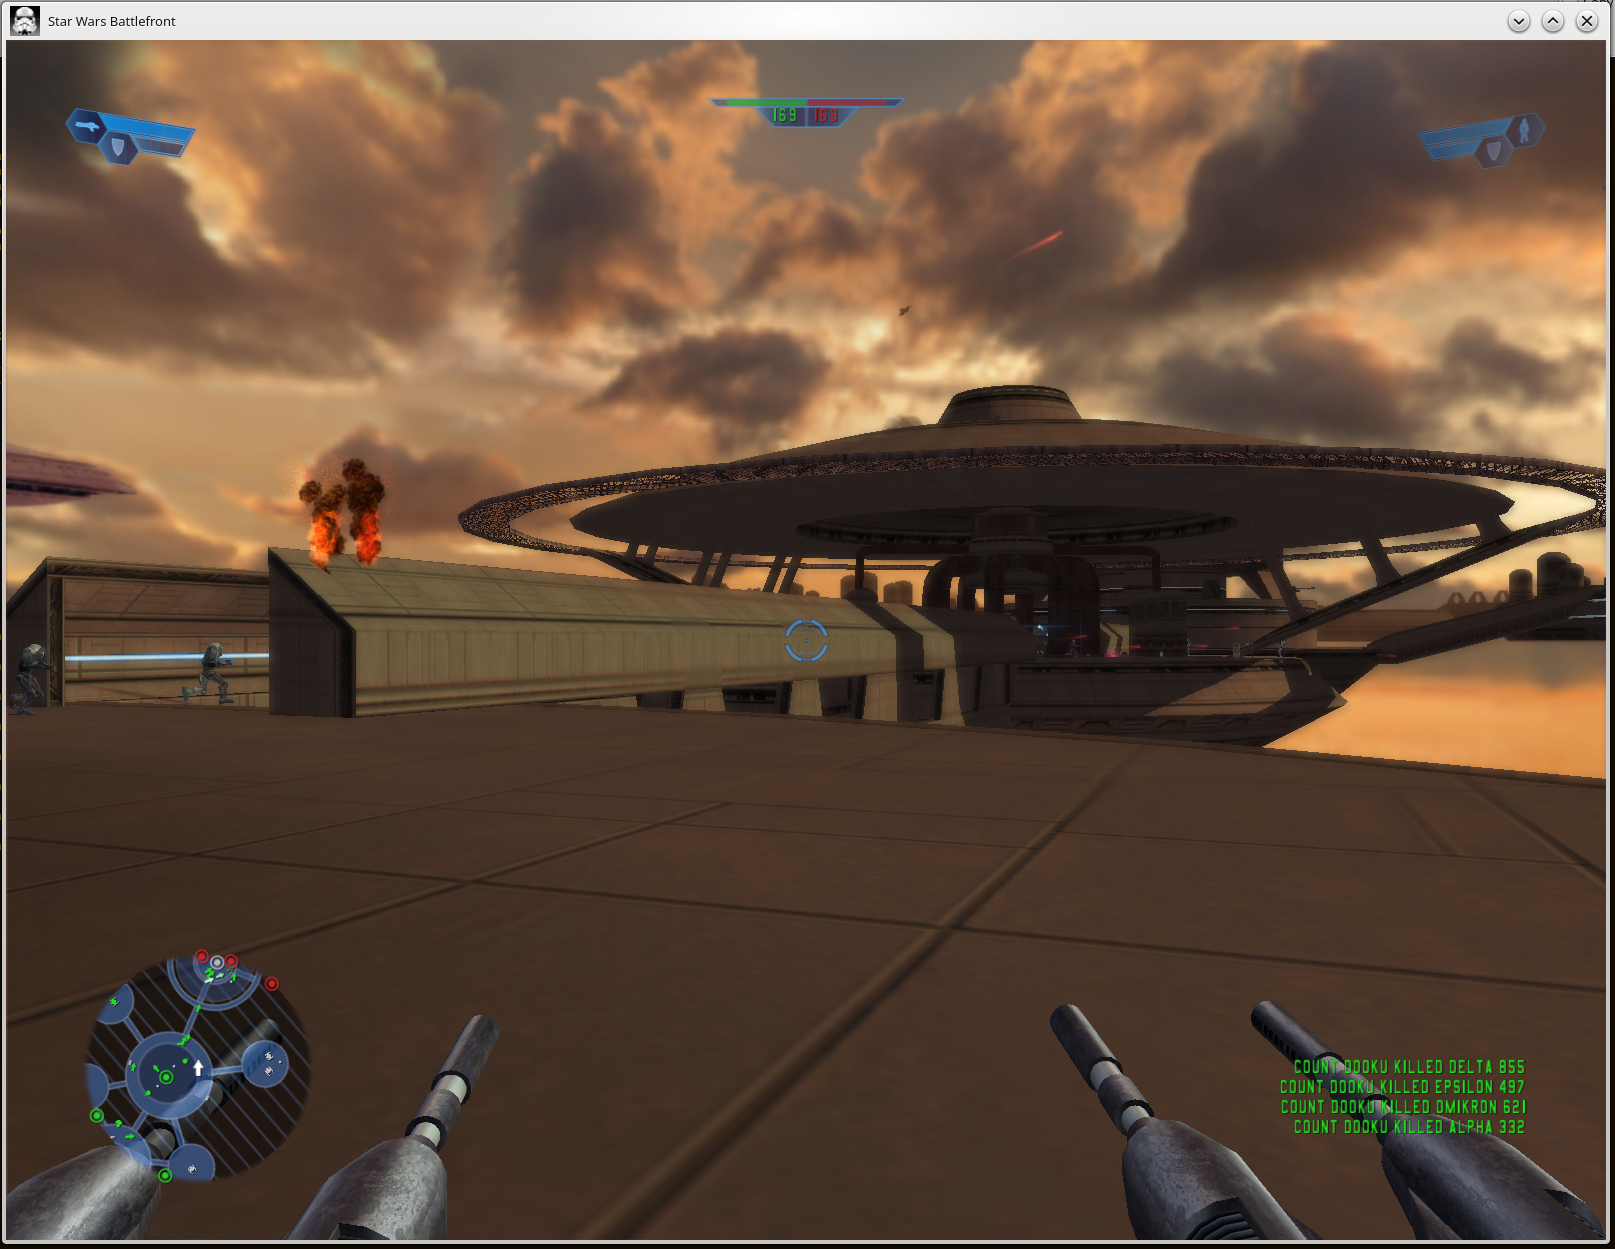
WineD3D와 함께 muvm 밖에서 실행 중인 Star Wars Battlefront (2004)
좋아요, Battlefront는 22년 전의 아주 단순한 Direct3D 9.0 게임입니다. 딱히 인상적인 시연은 아니죠? 그렇다면 이것은 어떨까요?
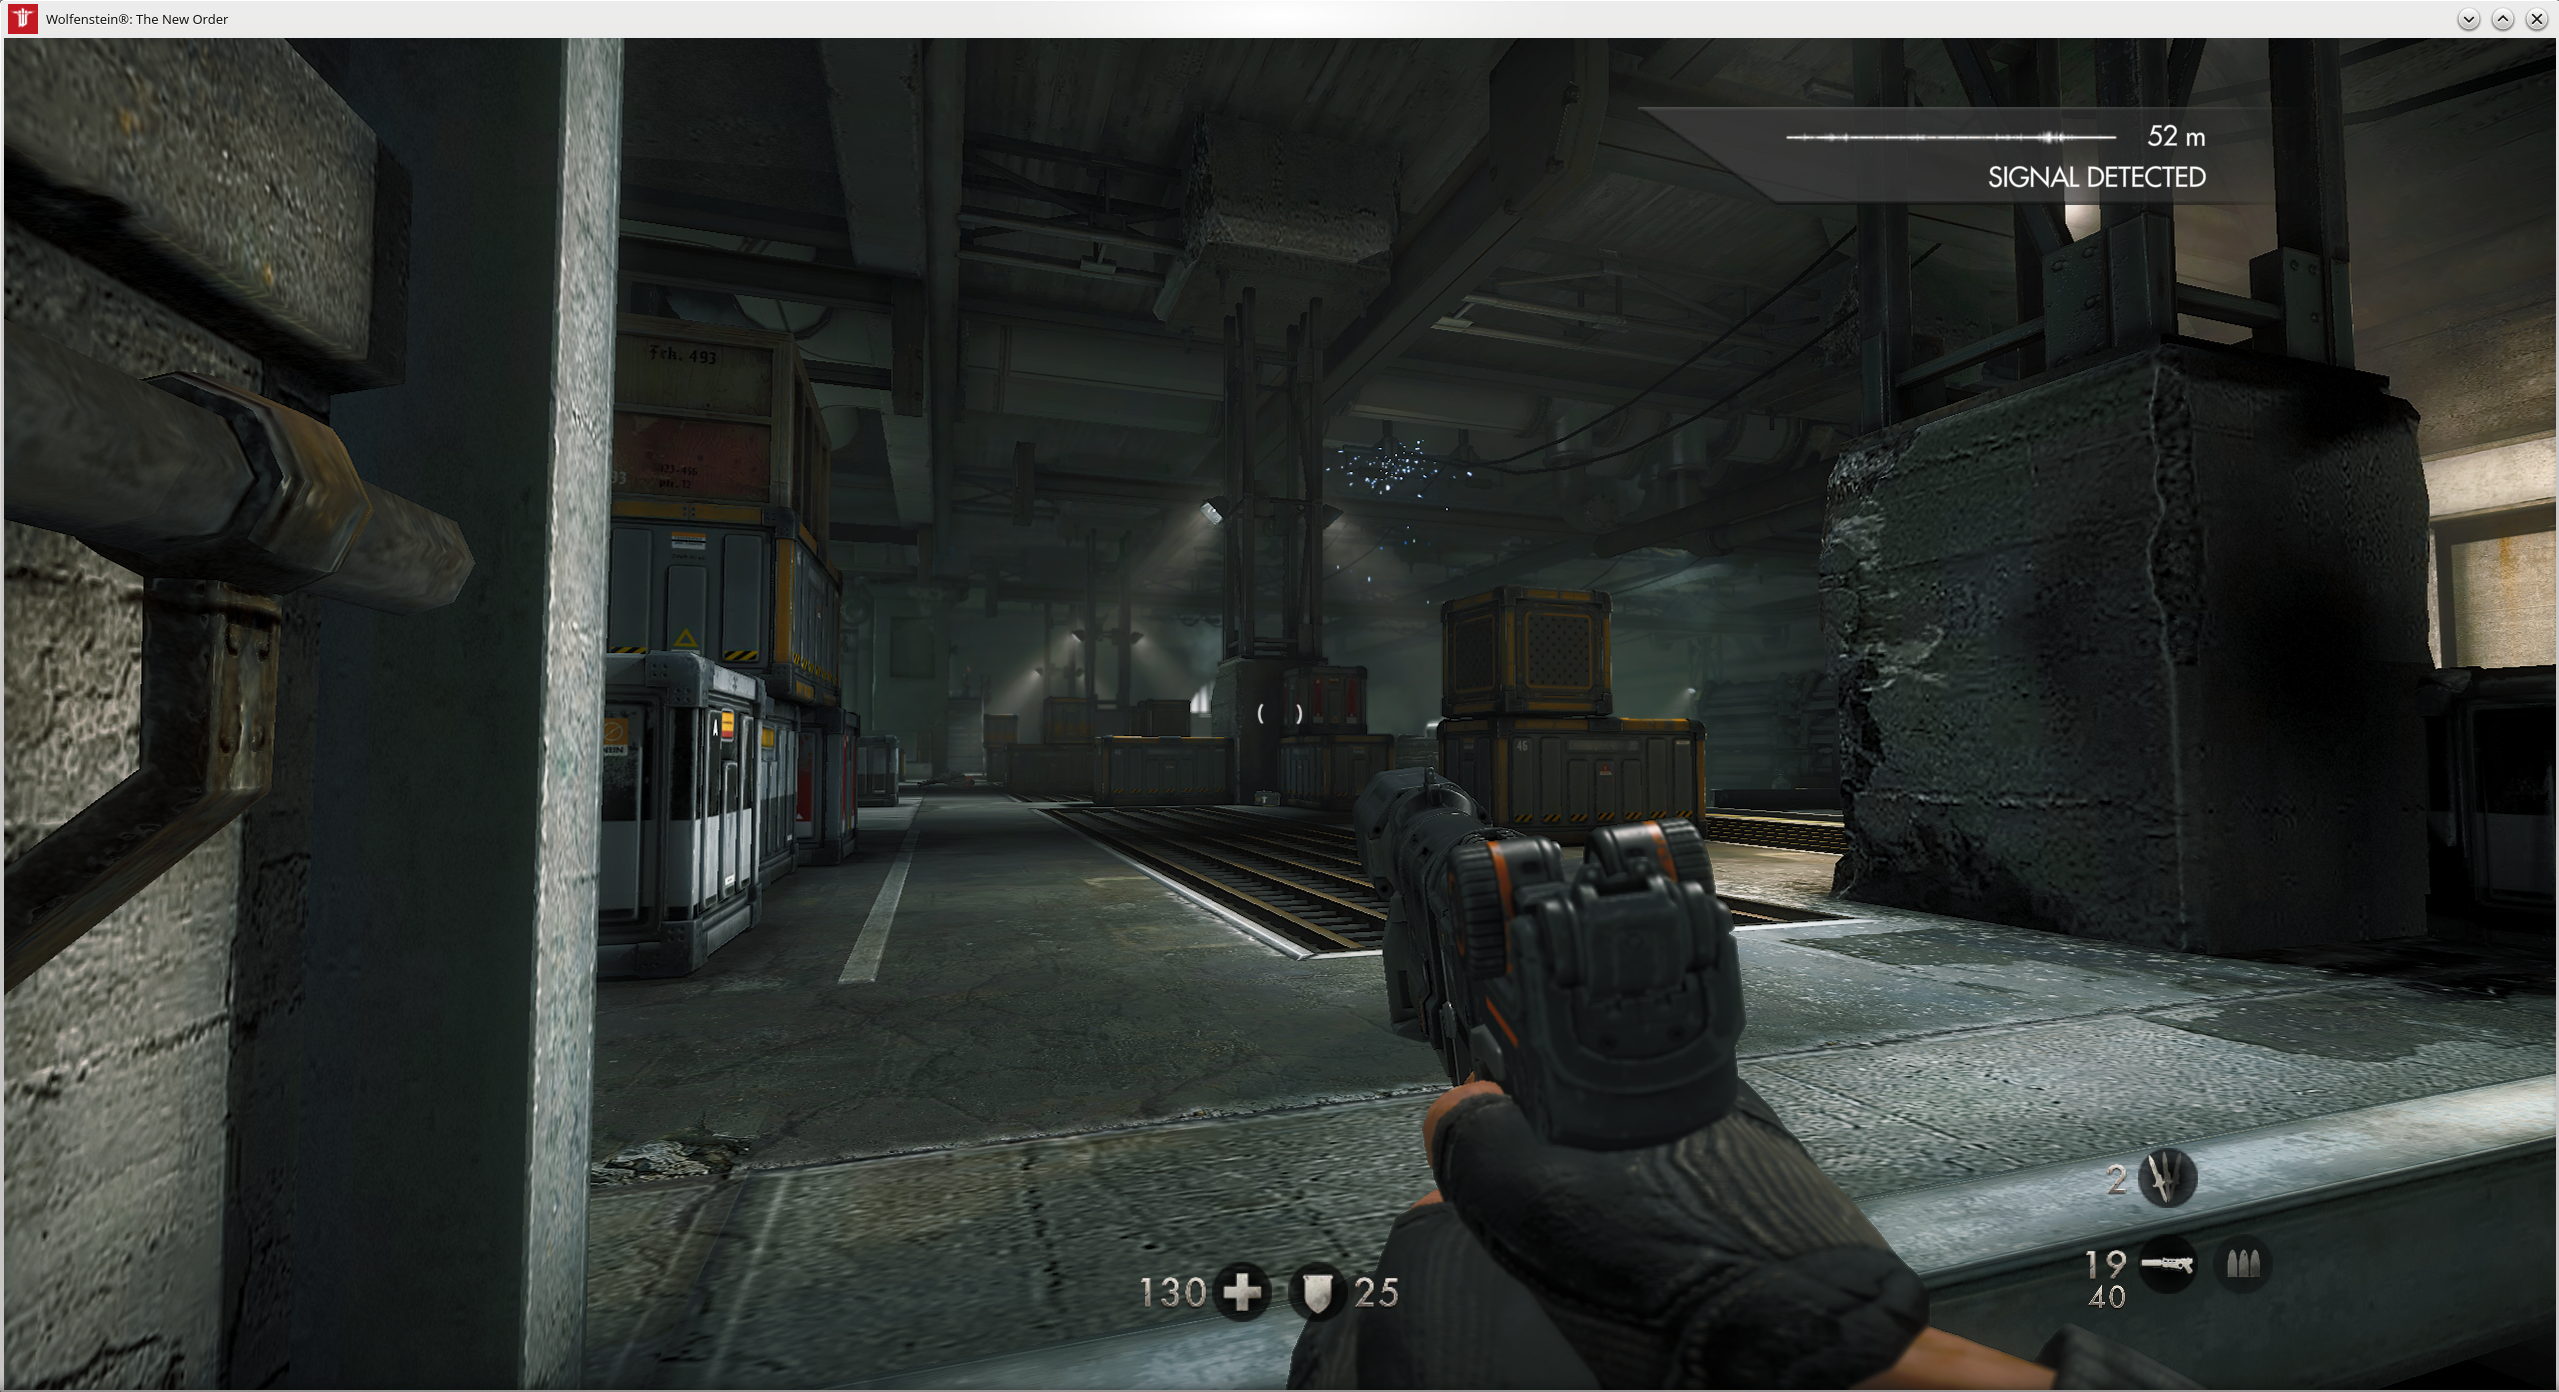
muvm 밖에서 실행 중인 Wolfenstein: The New Order (2014)
Wolfenstein: The New Order는 지금까지 출시된 네이티브 Vulkan 타이틀 중 최적화가 가장 뛰어난 작품 중 하나이며, 64비트이므로 WINE의 ARM64EC 경로를 사용해 FEX가 해야 할 작업량을 크게 줄입니다. 다시 말해, 기술적 난이도를 기준으로 판단한다면 딱히 인상적인 시연은 아닙니다.
다른 것을 찾아봅시다. 더… 나쁜 것을요. FEX와 WINE이 더 열심히 일하도록 32비트인 것. DXVK도 활용하게 만들 것. 실제 Windows 기기에서도 제대로 동작하지 않고, 현대 컴퓨터에서 아예 시작하려면 커뮤니티 패치와 명령줄 스위치에 의존할 정도로 우스울 만큼 버그가 많고 최적화가 형편없는 것 말입니다.
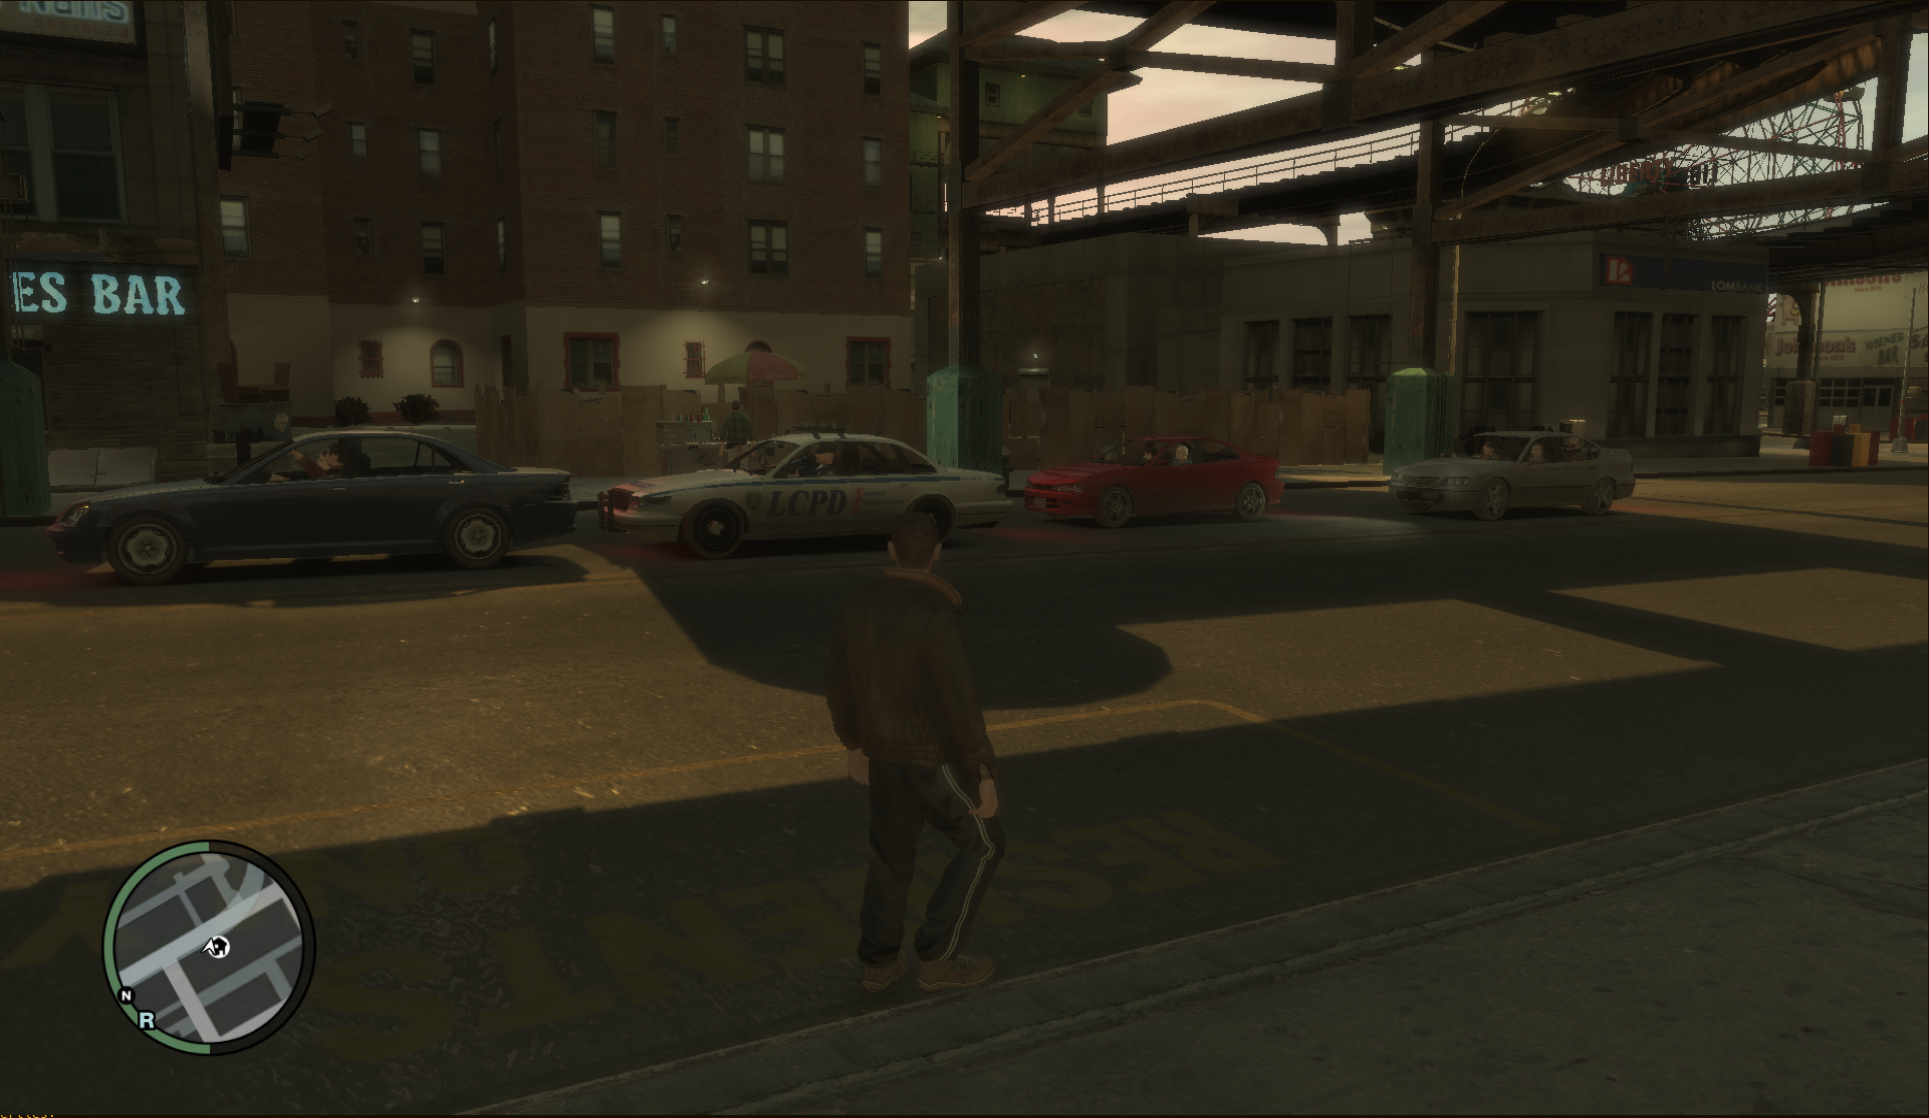
DXVK와 함께 muvm 밖에서 실행 중인 Grand Theft Auto IV (2008)
이제 좀 낫군요! 하지만 더 나쁜 것도 할 수 있습니다. 심지어… Bethesda 게임도 실행할 수 있습니다!
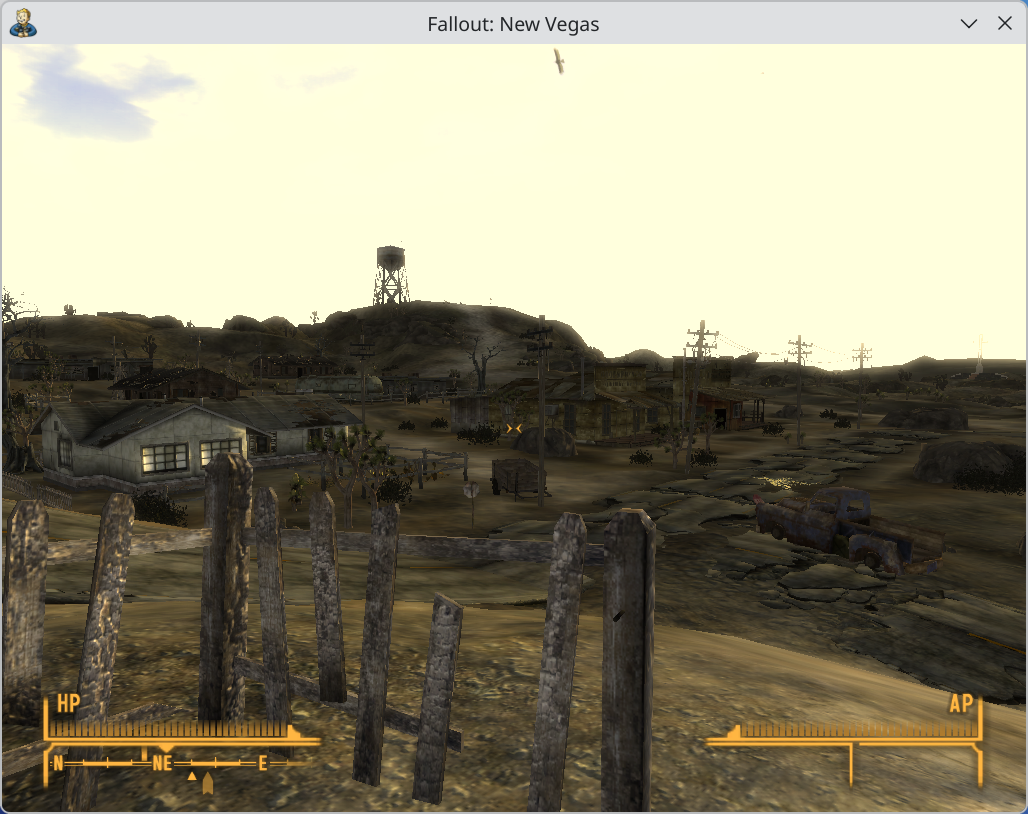
DXVK와 함께 muvm 밖에서 실행 중인 Fallout: New Vegas (2010)
물론 성능은 여전히 고르지 않습니다. Battlefront와 Wolfenstein은 둘 다 사실상 흠잡을 데 없이 실행되며, 후자는 M2 Max Mac Studio에서 144+ FPS에 도달합니다. 반면 GTA IV는… 훌륭하지 않습니다. 그래도 muvm 사용 시보다 성능은 크게 향상되었고, 일반적으로 VM 사용을 없애면 몇 가지 부류의 버그도 사라질 것입니다. 이 접근 방식에서는 GPU 드라이버 디버깅도 훨씬 쉬워질 것입니다.
언제나 그렇듯 문제가 있으며, 안타깝게도 큰 문제입니다. 현재 해결책은 16 KiB 호스트 및 그 호스트에서의 4 KiB 프로세스에 하드코딩되어 있습니다. 이는 분명 Google의 상업적 요구 사항을 충족하지만, 페이지 크기별 임시방편을 커널의 핵심 메모리 관리 코드에 추가하는 것은 업스트림에 적절하지 않습니다. Google이 이 접근 방식을 일반화해 업스트림으로 올릴지, 아니면 Android 전용 패치셋으로 남을지는 알 수 없습니다. 따라서 이런 수준의 불확실성이 있는 상황에서 사람들이 이에 의존하게 될 다운스트림 트리에 이를 제공하고 싶지 않습니다.
사용자 공간 통합도 필요합니다. P3S는 바이너리 메타데이터에서 섹션의 페이지 정렬을 확인하는 방식으로 작동합니다. P3S는 4 KiB 페이지에 정렬된 애플리케이션의 대체 메커니즘으로 의도되었으므로, 이는 Google의 사용 사례에는 맞습니다. 그러나 현대 arm64 바이너리는 모든 네이티브 페이지 크기의 시스템과의 호환성을 보장하기 위해 64 KiB에 정렬됩니다. 따라서 P3S를 강제로 활성화하는 심이 필요합니다. 심이 P3S를 작동시키면 모든 하위 프로세스가 4 KiB 페이지 크기를 상속합니다. Google이 이 패치셋으로 무엇을 할지 어느 정도 확실해질 때까지 이를 구현하는 데 노력을 들일 가치는 없습니다.
몇 가지 질문을 Google에 전달했으며, 곧 더 많은 이야기를 전할 수 있기를 바랍니다.
MacBook에서 발견되는 마이크 어레이용 맞춤형 빔포머는 Rust로 작성되었습니다. Rust의 과학 컴퓨팅 생태계는 C++만큼 성숙하지 않았는데, 빔포밍에는 오디오 샘플로 채워진 버퍼에서 실시간 FFT 및 매우 무거운 행렬 연산을 수행해야 하므로 다소 문제가 됩니다. 성숙한 과학 컴퓨팅 라이브러리에는 흔히 대상 ISA에 종속된 인트린식을 사용하는 수작업 최적화 코드가 있습니다. 하지만 우리는 그러지 않았으며, 성능 목표를 달성하기 위해 가능한 곳에서 컴파일러가 코드를 자동 벡터화하는 데 의존했습니다.
FFT 기반 해석 변환을 무한 임펄스 응답(IIR) 필터 기반 구현으로 대체하면서 이것은 무너졌습니다. 이 방식이 더 빨라야 하지만, 컴파일러가 새 구현을 자동 벡터화하지 못했습니다. Linkmauve가 친절하게 나서서 arm64와 amd64 모두를 위한 SIMD 최적화 코드를 추가했습니다. 여기에 Frédéric Bour가 제공한 다른 성능 최적화까지 더해져, Triforce는 CPU 시간을 더 적게 사용하면서 거의 두 배 빨라졌습니다!
Fedora Linux 45는 11월 3일에 출시되었고, 우리는 같은 날 Fedora Asahi Remix를 제공했습니다. 업스트림 Fedora와 같은 날 새 버전의 Fedora Asahi Remix를 출시할 수 있었던 것은 이번이 처음입니다!
우리는 우리의 작업에 큰 자부심을 느끼며, 언제나 개발 _전체_를 공개적으로 해 왔습니다. 사용자, 팔로워, 재정 후원자와 인간적으로 가능한 한 투명하게 소통합니다. 재정은 공개되어 있고, 개발 브랜치도 공개되어 있으며, 진행 상황을 정기적으로 솔직하게 공개 보고합니다. IRC 채널과 Matrix 방은 Asahi Linux 또는 Apple Silicon 해킹에 조금이라도 관심이 있는 누구에게나 열려 있는 안전한 공간입니다.
우리가 이 모든 일을 하는 이유는 Free and Open Source Software를 단순한 수단이 아니라 그 자체로 목적이라고 굳게 믿기 때문입니다. 현대 디지털 세계는 Free Software 운동 덕분에만 가능하며, Free Software 생태계를 보호하고 그 기반이 되는 이상을 지키기 위해 우리가 할 수 있는 모든 일을 하는 것은 그 어느 때보다 중요합니다.
WINE이 처음에는 MIT 라이선스로 제공되었다는 사실은 일부에게 놀라울 수 있습니다. 90년대와 2000년대의 Free Software 생태계는 매우 다른 시대였고, 허용적 라이선스 프로젝트는 기술 기업에 약탈하고 이용할 수 있는 공짜 자산으로 여겨졌습니다. WINE도 여기서 자유롭지 못했고, 여러 악의적 행위자가 WINE의 수익화된 독점 포크를 마케팅하고 판매했습니다. WINE 개발팀은 이러한 독점 포크가 존재할 권리는 충분히 있지만, 결국 생태계에 너무 큰 파편화를 초래해 WINE 자체가 존속 불가능해질 수 있다고 점점 우려했습니다. 2002년에 WINE은 추가적인 독점 포크 생성을 막고 직접적인 업스트림 기여를 장려하기 위해 LGPL로 재라이선스되었습니다.
Asahi Linux가 처음 시작되었을 때, 우리는 Apple Silicon 플랫폼을 위한 Free Software _생태계_를 개발하고자 했습니다. BSD 및 다른 Free Software 운영 체제에 있는 친구들의 참여를 촉진하고 장려하기 위해, 가능한 한 많은 코드를 허용적인 MIT 라이선스로 배포하고자 노력했습니다.
안타깝게도 이는 더 이상 실현 가능하지 않습니다. 90년대와 2000년대의 악의적 관행이 다시 추한 모습을 드러냈으며, 이번에는 고품질 학습 데이터를 향한 프런티어 AI 연구소의 끝없는 욕구와 Free Software 커뮤니티를 향한 호전적인 적대감이 큰 부분을 차지합니다.
얼마 전, 우리는 허용적 라이선스를 악용해 우리의 작업을 가로채고 프로젝트를 대체한 뒤 Apple Silicon의 Linux를 공격적으로 수익화하려는 여러 시도를 알게 되었습니다. 일부 극단적인 사례에서는 개발 중인 기능 코드가 개인 포크에서 그대로 가져와 출처 표기 없이 게시되거나, 그 기원을 흐리기 위해 LLM의 도움으로 성의 없이 다시 작성되었습니다. MIT 라이선스는 이를 명시적으로 허용하며, 악의로 행동하는 이들을 막기 위한 예외 조항이 없습니다.
이에 따라 우리는 모든 저장소를 GNU General Public License version 2 or later로 전환하는 과정을 시작하기로 어려운 결정을 내렸습니다. 앞으로 모든 Asahi Linux 코드는 강한 카피레프트 라이선스로만 배포될 것입니다. 역사에서 배우지 않는 자는 역사를 되풀이할 운명입니다.
언제나 그렇듯 OpenCollective와 GitHub Sponsors의 후원자 여러분께 진심으로 감사드립니다. 여러분의 너그러운 지원이 있기에 우리는 플랫폼을 계속 리버스 엔지니어링하고, 세계적 수준으로 다듬어지고 실전에서 검증된 Linux 데스크톱 경험을 제공하는 데 시간과 자원을 쏟을 수 있습니다. 여러분은 우리에게 세상 그 자체입니다.
James Calligeros · 2026-11-07
